
Resumo executivo
- Pesquisadores da Universidade de Stanford e do Arc Institute usaram os modelos de linguagem genômica Evo 1 e Evo 2 para escrever genomas completos de bacteriófagos do zero, sintetizaram quase 300 projetos e recuperaram 16 vírus viáveis.
- Um coquetel dos fagos projetados por IA eliminou cepas de E. coli que haviam desenvolvido resistência ao fago modelo natural, um resultado que uma mistura comparável de fagos naturais não conseguiu alcançar.
- A barreira restante para um fago terapêutico agora tem menos a ver com computação do que com síntese e viabilidade, porque o número de projetos que precisam ser construídos e testados aumenta muito mais rápido do que o custo de modelagem à medida que o comprimento do genoma cresce.
A inteligência artificial tem sido usada para ajudar a projetar partes biológicas há vários anos. Proteínas, complexos CRISPR-Cas, elementos transponíveis, promotores e pares toxina-antitoxina foram todos gerados por vários modelos de IA. No entanto, projetar um genoma é um problema diferente, e o design auxiliado por IA nessa escala estava, até agora, fora de alcance.
Recentemente, pesquisadores da Universidade de Stanford e do Arc Institute relataram ter cruzado essa linha. Usando os modelos de linguagem genômica Evo 1 e Evo 2, eles geraram genomas completos de bacteriófagos, sintetizaram quimicamente quase 300 deles e recuperaram 16 fagos viáveis.
Um coquetel desses projetos inibiu com sucesso cepas bacterianas que haviam evoluído para resistir ao fago modelo. Um coquetel comparável de fagos naturais não conseguiu alcançar isso.
Menos de 1% da pesquisa genômica utilizou IA
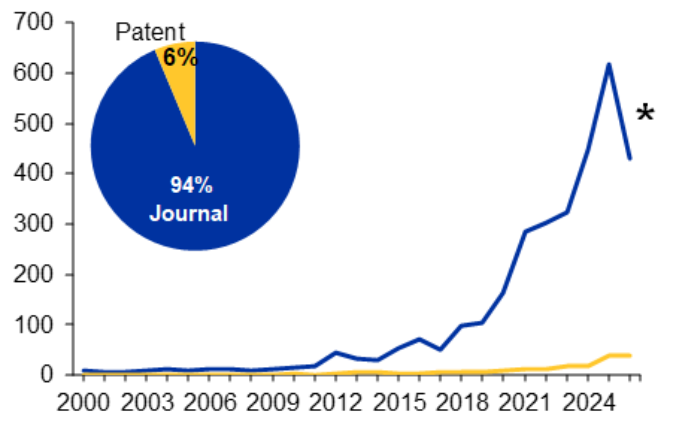
Para colocar esses resultados em um contexto mais amplo, analisamos um corpus de 11.259 documentos recuperados da CAS Content Collection™ cobrindo tópicos de IA/ML aplicados a genomas, abrangendo de 1989 a 2026. O corpus é dominado pela genômica preditiva e clínica. O trabalho que realmente usa IA para projetar sequências genômicas é raro, representando apenas 88 documentos ou 0,78% deste corpus.
Os 88 documentos dividem-se da seguinte forma:
- Design de CRISPR e edição (seleção de RNA guia, previsão de efeitos fora do alvo e resultados de edição) é o tópico mais prevalente com 42 documentos; é também o mais estabelecido, tendo ocorrido continuamente desde 2018.
- Design de elementos regulatórios (promotores, intensificadores, UTRs) representa 18 documentos.
- Design de sequência generativa (modelos que emitem novas sequências de nucleotídeos em vez de pontuar sequências existentes) representa 10 documentos e é o mais recente, com um ano médio de publicação em 2025.
- Design em escala de genoma completo e cromossomo representa apenas oito documentos.
Estes são números pequenos, e as categorias mais recentes são as menores, portanto, indicam onde a atividade está começando, em vez de uma taxa de crescimento. Dos 88 documentos de design, 74 são artigos de periódicos e apenas oito são patentes: o design genômico generativo ainda é literatura acadêmica.
Quantos "modelos de linguagem genômica" existem?
Genome language models, however, are a crowded field. A 2026 systematic review screened 469 records and identified 58 model-development studies. Most are encoders – put a sequence in, and a score or an embedding comes out. These dominate the corpus. DNABERT and DNABERT-2 appear in 34 documents, Enformer in 13, Caduceus in five, HyenaDNA and the Nucleotide Transformer in four each. Yet, only three of those documents fall in our verified genome-design set. AlphaGenome, the strongest recent model of this type, reads up to a million bases and predicts regulatory consequences, but does not write sequences.
Além dos modelos publicados, existem alguns em desenvolvimento que geram sequências, disponíveis apenas como preprints com código e pesos publicados publicamente (veja a Tabela 1).
Tabela 1. Lista de LLMs de genoma capazes de projetar genomas
A atividade comercial atualmente situa-se nas margens deste tópico, e não no seu centro.
- A Profluent, que relata ter projetado um sistema CRISPR inteiramente com IA, anunciou uma parceria com a Eli Lilly para recombinases projetadas por IA para medicina genética.
- A Dyno Therapeutics projeta capsídeos de AAV para entrega de genes e os licenciou para a Astellas e a Roche.
- A Ginkgo Bioworks e a Basecamp Research fornecem dados de treinamento, em vez de modelos.
- A NVIDIA codesenvolveu e distribui o Evo 2 com o Arc Institute.
- A Tatta Bio, uma organização sem fins lucrativos, lançou o modelo de modalidade mista gLM2.
Programas voltados para o design de genomas propriamente ditos permanecem escassos, e o trabalho em escala genômica até agora veio em grande parte de grupos acadêmicos e sem fins lucrativos com parceiros de computação (consistente com o cenário de patentes em nosso corpus).
Dentro desse grupo, o Evo tem um histórico mais longo e um contexto maior.O Evo 1 já produziu sistemas CRISPR-Cas e transposons funcionais e sequências em escala de megabases de arquitetura genômica plausível, e o Evo 2 lê e escreve com resolução de nucleotídeo único em uma janela de 1 milhão de tokens. Esse contexto é a propriedade decisiva: um genoma de fago de 5,4 quilobases cabe inteiro nele, de modo que o modelo mantém a ordem dos genes, o posicionamento regulatório e os sinais de empacotamento em vista de uma só vez, em vez de montar um genoma a partir de fragmentos pontuados independentemente. O pré-treinamento focado em fagos também é importante, com mais de 2 milhões de genomas de bacteriófagos, colocando o alvo dentro da distribuição que os modelos aprenderam.
O que foi solicitado aos modelos?
The template was ΦX174: a small lytic member of the Microviridae, whose 5.4-kilobase genome carries 11 genes and at least seven regulatory elements. Compactness, decades of characterization, and a harmless laboratory host made it an unusually safe proving ground. Both models were fine-tuned on approximately 15,000 Microviridae sequences before any candidate went to synthesis.
IA como uma etapa em um pipeline de seis estágios
A geração bruta não produziu genomas viáveis. A diferença entre esta tentativa e uma fracassada reside em grande parte no que cercava o modelo. Os autores descrevem um pipeline de seis estágios:
- Pré-treinamento
- Ajuste fino supervisionado em Microviridae
- Engenharia de prompt com sequência ΦX174
- Direcionamento durante a inferência por modelos separados que pontuaram a arquitetura genômica e previram a gama de hospedeiros
- Filtragem computacional
- Validação experimental
Apenas o uso de prompts não foi suficiente: em nenhum comprimento de prompt os modelos base recuperaram o ΦX174, enquanto as versões ajustadas (fine-tuned) conseguiram.
A filtragem foi a etapa onde a maioria dos candidatos foi eliminada, dividida em três níveis: qualidade básica da sequência, especificidade para o hospedeiro pretendido e distância da sequência natural. O controle de qualidade impôs comprimentos de quatro a seis quilobases, conteúdo GC entre 30 e 65% e nenhum homopolímero com mais de 10 bases. As verificações mais rigorosas foram biológicas, e foi aqui que a previsão de estrutura e função entrou no ciclo de design, em vez de apenas na redação. As proteínas geradas foram dobradas com o OpenGenome e PHROGs, retornando uma distribuição realista de anotações funcionais, apesar da baixa identidade de sequência com qualquer coisa conhecida.
Nenhuma das seis ferramentas de anotação genética amplamente utilizadas conseguiu anotar todos os 11 genes do ΦX174 do tipo selvagem, porque as matrizes de leitura sobrepostas do genoma invalidam a previsão padrão de quadros de leitura abertos; por isso, a equipe criou um preditor de sequência codificante personalizado. Sem ele, não havia como confirmar se um genoma gerado continha um conjunto completo de genes — uma estratégia de gerar e filtrar sem um filtro.
O AlphaFold 3 também aparece, mas após o design: prevendo a orientação da incomum proteína J no capsídeo do Evo-Φ36 e posicionando mutações associadas à resistência no exterior do vírion. A previsão de estrutura desempenhou dois papéis: um filtro durante o design e uma ferramenta explicativa posteriormente.
Dos 302 designs selecionados, 285 foram sintetizados e montados com sucesso. O restante falhou devido à complexidade da síntese. Dezesseis inibiram o crescimento de Escherichia coli C — 12 de 227 sequências do Evo 1 (5,3%) e 4 de 58 do Evo 2 (6,9%). A viabilidade acompanhou a similaridade da sequência com os genomas naturais, atingindo 46,2% entre os designs mais próximos: quanto mais o modelo se afasta do que a evolução amostrou, mais frequentemente ele falha.
Três razões pelas quais este é um avanço genuíno
- Escala. Todo sucesso generativo anterior nesta linhagem foi apenas uma parte. Este é um genoma completo e autorreplicante cujos componentes devem funcionar juntos em um hospedeiro vivo, entregue por meio de uma estrutura de ponta a ponta, em vez de um único constructo de sorte.
- Os designs não são recombinações do modelo. A criomicroscopia eletrônica do Evo-Φ36 (um dos 285 fagos sintetizados projetados por IA) com resolução de 2,9 Å mostrou que o fago projetado carrega uma proteína J de empacotamento de DNA truncada do fago Escherichia G4, um parente distante (25 resíduos em vez de 38). Essa troca havia sido relatada como inviável no ΦX174 do tipo selvagem. O modelo montou um contexto no qual uma parte, de outra forma incompatível, funciona, sendo esta a evidência mais clara de que ele internalizou restrições epistáticas em vez de memorizar a sequência.
- Os designs trazem novidade real. Mutações sem contraparte natural, genes divergentes, sequência regulatória alterada e comprimentos de genoma variáveis. As edições concentraram-se no promotor A, no gene J e no terminador J: todos pontos de controle regulatórios e estruturais.
Superando a resistência bacteriana
A terapia fágica tem despertado interesse contínuo à medida que a resistência antimicrobiana se aprofunda, mas permanece limitada pela baixa eficácia in vivo e pela evolução da resistência das bactérias aos fagos. A Organização Mundial da Saúde classifica a resistência antimicrobiana (RAM) entre as principais ameaças à saúde global.
Notavelmente, uma mistura dos fagos projetados por IA relatados por King et al. foi eficaz contra cepas de E. coli resistentes ao ΦX174, enquanto uma mistura comparável de fagos naturais semelhantes ao ΦX174 não foi.
Distância da aplicação clínica
A tradução clínica ainda está em estágio inicial, com cerca de 96 estudos intervencionais envolvendo agentes baseados em fagos listados no ClinicalTrials.gov (em 12 de agosto de 2026), com quase metade deles recrutando, ativos ou ainda não iniciados. Entre os ensaios que relatam uma fase, a Fase 1 e a Fase 2 predominam (62 de 71). Os alvos incluem Pseudomonas aeruginosa em fibrose cística, infecções do trato urinário, úlceras de pé diabético e infecções de próteses articulares. Fagos modificados já chegaram aos pacientes: o SNIPR001 está em um estudo de Fase 1b/2a (NCT06938867) em pacientes submetidos a transplante de células-tronco que carregam E. coli resistente a fluoroquinolonas.
Os desafios de projetar nesta escala
Os fagos projetados foram testados em E. coli C, uma cepa laboratorial inofensiva, não um patógeno clínico. Fagos direcionados a Klebsiella ou Pseudomonas geralmente têm de 40 a 100 quilobases, uma ordem de magnitude maior do que o modelo de 5,4 quilobases usado aqui, e os autores identificam o custo de sintetizar e montar tanto DNA como o principal obstáculo para projetá-los. Os obstáculos familiares para qualquer medicamento biológico (consistência de fabricação, imunogenicidade, controle de endotoxinas) permanecem inalterados por um genoma projetado por IA.
O poder computacional é o lugar óbvio para esperar um limite, mas esse não é o caso aqui. O Evo não usa a arquitetura transformer padrão, cujo custo cresce com o quadrado do comprimento da sequência. Em vez disso, seu custo aumenta de forma quase linear, portanto, um fago de 100 quilobases, ou até mesmo um genoma bacteriano de 4,6 megabases, é um passo gerenciável. O comprimento do contexto também não foi estendido aqui: os modelos leem oito quilobases de cada vez, confortavelmente mais do que o genoma que estavam escrevendo. Um genoma humano de 3,1 gigabases é uma questão diferente e exigiria trabalho arquitetônico. O que escala mal é a viabilidade. Dos 285 genomas sintetizados com sucesso, 16 produziram fagos funcionais (5,6%), subindo para 46,2% apenas entre os designs mais próximos da sequência natural. Uma única mutação em qualquer lugar pode matar um genoma, e cada quilobase adicional adiciona genes, elementos regulatórios e sinais de empacotamento que devem estar corretos e ser mutuamente compatíveis. A inferência é que o ônus que cresce acentuadamente com o comprimento do genoma é experimental, não computacional. O número de designs que devem ser construídos e rastreados para recuperar um funcional aumenta muito mais rápido do que o poder computacional necessário para escrevê-los.
A disponibilidade de dados de treinamento estabelece um segundo limite. O resultado baseia-se em mais de 2 milhões de genomas de bacteriófagos no pré-treinamento e cerca de 15.000 parentes próximos do modelo no ajuste fino, portanto, o alvo estava bem dentro da distribuição que os modelos haviam aprendido. Para um fago personalizado de 100 quilobases contra um isolado clínico específico, essa densidade de vizinhos próximos não está disponível, e para genomas eucarióticos o problema muda de natureza. A função ali depende do estado da cromatina, do splicing e da regulação de longo alcance que a sequência primária subdetermina. O precedente do laboratório é sóbrio. Um genoma bacteriano de 1,08 megabase foi sintetizado quimicamente e transplantado em 2010, e um sucessor minimizado surgiu em 2016, mas uma cepa de levedura sintética totalmente consolidada permanece inacabada após cerca de duas décadas. Os métodos habilitadores estão avançando, mas nenhum ainda oferece o rendimento que tornou possível uma triagem de 285 designs na escala de fagos.
Os autores também recomendam o envolvimento de especialistas em segurança em todas as etapas, um conselho que ganha mais peso à medida que os alvos passam de um fago laboratorial inofensivo para patógenos clínicos.
O resultado é preciso e sólido: com um modelo bem caracterizado, uma IA escreveu genomas que se tornaram vírus funcionais e superaram os naturais na quebra de resistência. No contexto da literatura atual, é um marco importante em uma área que passou anos aperfeiçoando a seleção de RNA guia e só recentemente começou a escrever sequências diretamente. Escalar para um fago terapêutico é agora tanto um problema de síntese e segurança quanto de modelagem.