
Resumen ejecutivo
- Investigadores de la Universidad de Stanford y del Arc Institute utilizaron los modelos de lenguaje genómico Evo 1 y Evo 2 para escribir genomas completos de bacteriófagos desde cero, sintetizaron casi 300 diseños y recuperaron 16 virus viables.
- Un cóctel de los fagos diseñados por IA eliminó cepas de E. coli que habían desarrollado resistencia al fago plantilla natural, un resultado que una mezcla comparable de fagos naturales no pudo lograr.
- La barrera restante para un fago terapéutico tiene menos que ver con la computación que con la síntesis y la viabilidad, ya que el número de diseños que deben construirse y analizarse aumenta mucho más rápido que el coste de modelado a medida que crece la longitud del genoma.
La inteligencia artificial se ha utilizado para ayudar a diseñar componentes biológicos durante varios años. Diversos modelos de IA han generado proteínas, complejos CRISPR-Cas, elementos transponibles, promotores y pares toxina-antitoxina. Sin embargo, diseñar un genoma es un problema distinto, y el diseño asistido por IA a esa escala había estado, hasta ahora, fuera de nuestro alcance.
Recientemente, investigadores de la Universidad de Stanford y del Arc Institute informaron haber superado ese límite. Utilizando los modelos de lenguaje genómico Evo 1 y Evo 2, generaron genomas completos de bacteriófagos, sintetizaron químicamente casi 300 de ellos y recuperaron 16 fagos viables.
Un cóctel de esos diseños inhibió con éxito cepas bacterianas que habían evolucionado para resistir al fago plantilla. Un cóctel comparable de fagos naturales no pudo lograr este resultado.
Menos del 1% de la investigación genómica ha utilizado IA
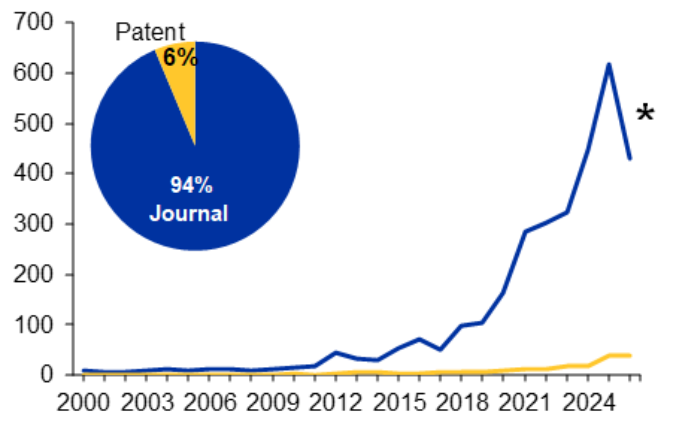
Para situar estos resultados en un contexto más amplio, analizamos un corpus de 11 259 documentos extraídos de la CAS Content Collection™ que abarca temas de IA/aprendizaje automático aplicados a genomas, desde 1989 hasta 2026. El corpus está dominado por la genómica predictiva y clínica. El trabajo que realmente utiliza IA para diseñar secuencias genómicas es poco frecuente, representando solo 88 documentos o el 0,78% de este corpus.
Los 88 documentos se desglosan de la siguiente manera:
- El diseño de CRISPR y edición (selección de ARN guía, predicción de efectos fuera de objetivo y resultados de edición) es el tema más frecuente con 42 documentos; también es el más consolidado, habiéndose desarrollado de forma continua desde 2018.
- El diseño de elementos reguladores (promotores, potenciadores, UTR) representa 18 documentos.
- El diseño de secuencias generativas (modelos que emiten nuevas secuencias de nucleótidos en lugar de evaluar secuencias existentes) representa 10 documentos y es el más reciente, con un año medio de publicación de 2025.
- El diseño a escala de genoma completo y cromosoma representa solo ocho documentos.
Estas son cifras pequeñas, y las categorías más nuevas son las más reducidas, por lo que indican dónde está comenzando la actividad más que una tasa de crecimiento. De los 88 documentos de diseño, 74 son artículos de revistas y solo ocho son patentes: el diseño genómico generativo sigue siendo literatura académica.
¿Cuántos "modelos de lenguaje genómico" existen?
No obstante, los modelos de lenguaje genómico constituyen un campo saturado. Una revisión sistemática de 2026 analizó 469 registros e identificó 58 estudios de desarrollo de modelos. La mayoría son codificadores: se introduce una secuencia y se obtiene una puntuación o una representación vectorial (embedding). Estos dominan el corpus. DNABERT y DNABERT-2 aparecen en 34 documentos, Enformer en 13, Caduceus en cinco, y HyenaDNA y Nucleotide Transformer en cuatro cada uno. Sin embargo, solo tres de esos documentos se incluyen en nuestro conjunto verificado de diseño genómico. AlphaGenome, el modelo reciente más sólido de este tipo, lee hasta un millón de bases y predice consecuencias reguladoras, pero no escribe secuencias.
Además de los modelos publicados, existen algunos en desarrollo que generan secuencias, disponibles únicamente como prepublicaciones con el código y los pesos publicados abiertamente (véase la Tabla 1).
Tabla 1. Lista de modelos de lenguaje genómico (LLM) capaces de diseñar genomas
La actividad comercial se sitúa actualmente en la periferia de este tema, no en su núcleo.
- Profluent, que afirma haber diseñado un sistema CRISPR íntegramente con IA, ha anunciado una colaboración con Eli Lilly sobre recombinasas diseñadas por IA para medicina genética.
- Dyno Therapeutics diseña cápsides de AAV para la administración de genes y las ha licenciado a Astellas y Roche.
- Ginkgo Bioworks y Basecamp Research suministran datos de entrenamiento en lugar de modelos.
- NVIDIA ha codesarrollado y distribuye Evo 2 junto con el Arc Institute.
- Tatta Bio, una organización sin ánimo de lucro, ha lanzado el modelo de modalidad mixta gLM2.
Los programas destinados al diseño de genomas propiamente dichos siguen siendo escasos, y el trabajo a escala genómica realizado hasta la fecha proviene en gran medida de grupos académicos y sin ánimo de lucro con socios tecnológicos (lo cual es coherente con el panorama de patentes en nuestro corpus).
Dentro de ese grupo, Evo cuenta con una trayectoria más larga y un contexto mayor. Evo 1 ya produjo sistemas CRISPR-Cas y transposones funcionales, así como secuencias a escala de megabases de arquitectura genómica plausible, y Evo 2 lee y escribe con una resolución de un solo nucleótido a través de una ventana de 1 millón de tokens. Ese contexto es la propiedad decisiva: un genoma de fago de 5,4 kilobases cabe completo en él, por lo que el modelo mantiene a la vista el orden de los genes, la ubicación reguladora y las señales de empaquetamiento, en lugar de ensamblar un genoma a partir de fragmentos puntuados de forma independiente. El preentrenamiento centrado en fagos también es relevante, con más de 2 millones de genomas de bacteriófagos, lo que sitúa al objetivo dentro de la distribución que los modelos aprendieron.
¿Qué se les pidió hacer a los modelos?
La plantilla fue ΦX174: un pequeño miembro lítico de la Microviridae, cuyo genoma de 5,4 kilobases contiene 11 genes y al menos siete elementos reguladores. Su compacidad, décadas de caracterización y un huésped de laboratorio inofensivo lo convirtieron en un terreno de pruebas inusualmente seguro. Ambos modelos fueron ajustados con aproximadamente 15 000 secuencias de Microviridae antes de que cualquier candidato pasara a la síntesis.
La IA como un paso en un proceso de seis etapas
La generación bruta no produjo genomas viables. La diferencia entre este intento y uno fallido reside en gran medida en lo que rodeaba al modelo. Los autores describen un proceso de seis etapas:
- Preentrenamiento
- Ajuste supervisado con Microviridae
- Ingeniería de prompts con la secuencia ΦX174
- Direccionamiento durante la inferencia mediante modelos independientes que puntuaron la arquitectura genómica y predijeron el rango de huéspedes
- Filtrado computacional
- Validación experimental
El uso de prompts por sí solo no fue suficiente: en ninguna longitud de prompt los modelos base recuperaron el ΦX174, mientras que las versiones ajustadas sí lo hicieron.
El filtrado fue la etapa donde la mayoría de los candidatos fueron descartados, siguiendo tres niveles: calidad básica de la secuencia, especificidad para el huésped previsto y distancia respecto a la secuencia natural. El control de calidad impuso longitudes de cuatro a seis kilobases, un contenido de GC entre el 30 y el 65%, y la ausencia de homopolímeros superiores a 10 bases. Las comprobaciones más rigurosas fueron de carácter biológico, y es aquí donde la predicción de estructura y función se integró en el ciclo de diseño en lugar de en la fase de redacción. Las proteínas generadas se plegaron con OpenGenome y PHROGs, arrojando una distribución realista de anotaciones funcionales a pesar de la baja identidad de secuencia con cualquier elemento conocido.
Ninguna de las seis herramientas de anotación genética más utilizadas pudo anotar los 11 genes del ΦX174 de tipo salvaje, ya que los marcos de lectura superpuestos del genoma invalidan la predicción estándar de marcos de lectura abiertos; por ello, el equipo desarrolló un predictor de secuencias codificantes a medida. Sin él, no había forma de confirmar que un genoma generado contuviera un conjunto completo de genes: una estrategia de generación y filtrado sin filtro.
AlphaFold 3 también aparece, pero en una fase posterior al diseño: prediciendo la orientación de la inusual proteína J en la cápside de Evo-Φ36 y situando las mutaciones asociadas a la resistencia en el exterior del virión. La predicción de estructuras desempeñó dos funciones: la de filtro durante el diseño y la de herramienta explicativa a posteriori.
De los 302 diseños seleccionados, 285 se sintetizaron y ensamblaron con éxito. El resto falló debido a la complejidad de la síntesis. Dieciséis inhibieron el crecimiento de Escherichia coli C (12 de 227 secuencias de Evo 1 (5,3%) y 4 de 58 de Evo 2 (6,9%)). La viabilidad siguió la similitud de secuencia con los genomas naturales, alcanzando el 46,2% entre los diseños más cercanos: cuanto más se aleja el modelo de lo que la evolución ha muestreado, más a menudo fracasa.
Tres razones por las que esto supone un avance real
- Escala. Todos los éxitos generativos anteriores en este linaje se limitaban a partes aisladas. Este es un genoma completo y autorreplicante cuyos componentes deben funcionar conjuntamente en un huésped vivo, obtenido mediante un marco de trabajo integral en lugar de un único constructo afortunado.
- Los diseños no son recombinaciones de la plantilla. La criomicroscopía electrónica de Evo-Φ36 (uno de los 285 fagos diseñados por IA sintetizados) a una resolución de 2,9 Å mostró que el fago diseñado porta una proteína J de empaquetamiento de ADN truncada del fago de Escherichia G4, un pariente lejano (25 residuos en lugar de 38). Ese intercambio se había reportado como inviable en el ΦX174 de tipo salvaje. El modelo ensambló un contexto en el que una parte, de otro modo incompatible, funciona, siendo esta la prueba más clara de que internalizó las restricciones epistáticas en lugar de memorizar la secuencia.
- Los diseños aportan una novedad real. Mutaciones sin contrapartida natural, genes divergentes, secuencias reguladoras alteradas y longitudes de genoma variables. La edición se concentró en el promotor A, el gen J y el terminador J: todos ellos puntos de control estructural y regulador.
Superando la resistencia bacteriana
La terapia fágica ha despertado un interés sostenido a medida que la resistencia a los antimicrobianos se ha agravado, pero sigue limitada por una escasa eficacia in vivo y por la evolución de la resistencia bacteriana a los fagos. La Organización Mundial de la Salud clasifica la resistencia a los antimicrobianos (RAM) entre las principales amenazas para la salud mundial.
Sorprendentemente, una mezcla de los fagos diseñados por IA reportados por King et al. resultó eficaz contra cepas de E. coli resistentes al ΦX174, mientras que una mezcla comparable de fagos naturales similares al ΦX174 no lo fue.
Distancia hasta la aplicación clínica
La traslación clínica se encuentra aún en una fase inicial, con unos 96 estudios de intervención que involucran agentes basados en fagos registrados en ClinicalTrials.gov (a fecha de 12 de agosto de 2026), de los cuales casi la mitad están en fase de reclutamiento, activos o aún no han comenzado. Entre los ensayos que informan de una fase, predominan la Fase 1 y la Fase 2 (62 de 71). Los objetivos incluyen Pseudomonas aeruginosa en fibrosis quística, infecciones del tracto urinario, úlceras de pie diabético e infecciones de prótesis articulares. Los fagos modificados ya han llegado a los pacientes: SNIPR001 se encuentra en un estudio de Fase 1b/2a (NCT06938867) en pacientes trasplantados de células madre portadores de E. coli resistente a fluoroquinolonas.
Los desafíos de diseñar a esta escala
Los fagos diseñados se probaron en E. coli C, una cepa de laboratorio inofensiva, no un patógeno clínico. Los fagos dirigidos a Klebsiella o Pseudomonas suelen tener entre 40 y 100 kilobases, un orden de magnitud mayor que la plantilla de 5,4 kilobases utilizada aquí, y los autores identifican el coste de sintetizar y ensamblar tal cantidad de ADN como el principal obstáculo para su diseño. Los obstáculos habituales para cualquier medicamento biológico (consistencia en la fabricación, inmunogenicidad, control de endotoxinas) no cambian con un genoma diseñado por IA.
La potencia de cálculo es el lugar obvio donde esperar un límite, pero no es el caso aquí. Evo no utiliza la arquitectura transformer estándar, cuyo coste crece con el cuadrado de la longitud de la secuencia. Por el contrario, su coste aumenta de forma casi lineal, por lo que un fago de 100 kilobases, o incluso un genoma bacteriano de 4,6 megabases, es un paso manejable. Tampoco se amplió la longitud del contexto: los modelos leen ocho kilobases a la vez, cómodamente más que el genoma que estaban escribiendo. Un genoma humano de 3,1 gigabases es otra cuestión y requeriría trabajo arquitectónico. Lo que escala mal es la viabilidad. De 285 genomas sintetizados con éxito, 16 produjeron fagos funcionales (5,6%), cifra que aumenta al 46,2% solo entre los diseños más cercanos a la secuencia natural. Una sola mutación en cualquier lugar puede destruir un genoma, y cada kilobase adicional añade genes, elementos reguladores y señales de empaquetamiento que deben ser correctos y mutuamente compatibles. La inferencia es que la carga que crece drásticamente con la longitud del genoma es experimental, no computacional. El número de diseños que deben construirse y cribarse para recuperar uno funcional aumenta mucho más rápido que el cómputo necesario para escribirlos.
Training data availability sets a second limit. The result rests on more than 2 million bacteriophage genomes in pretraining and roughly 15,000 close relatives of the template in fine-tuning, so the target sat well inside the distribution the models had learned. For a bespoke 100-kilobase phage against a specific clinical isolate, that density of near neighbors is not available, and for eukaryotic genomes the problem changes in kind. Function there depends on chromatin state, splicing, and long-range regulation that primary sequence underdetermines. The wet-lab precedent is sobering. A 1.08-megabase bacterial genome was chemically synthesized and transplanted in 2010 and a minimized successor followed in 2016, yet a fully consolidated synthetic yeast strain remains unfinished after roughly two decades. Enabling methods are advancing, but none yet offers the throughput that made a 285-design screen possible at phage scale.
Los autores recomiendan además involucrar a especialistas en seguridad en todas las etapas, un consejo que cobra mayor relevancia a medida que los objetivos pasan de ser fagos de laboratorio inofensivos a patógenos clínicos.
El resultado es concreto y sólido: a partir de una plantilla bien caracterizada, un modelo de lenguaje generó genomas que se convirtieron en virus funcionales y superaron a los naturales al romper resistencias. En el contexto de la literatura científica, es un hito en un campo que ha dedicado años a perfeccionar la selección de ARN guía y que solo recientemente ha comenzado a escribir secuencias directamente. Escalar hacia un fago terapéutico es ahora tanto un problema de síntesis y seguridad como de modelado.