
요약
- 스탠퍼드 대학교와 Arc 연구소의 연구진은 게놈 언어 모델인 Evo 1과 Evo 2를 사용하여 박테리오파지 게놈 전체를 처음부터 새로 작성하고, 약 300개의 설계를 합성하여 16개의 생존 가능한 바이러스를 회수했습니다.
- AI가 설계한 파지 칵테일은 대장균 균주를 제거했는데, 이 균주는 자연 템플릿 파지에 대한 내성을 진화시킨 상태였으며, 이는 유사한 자연 파지 혼합물로는 달성할 수 없었던 결과입니다.
- 치료용 파지를 만드는 데 남은 장벽은 이제 컴퓨팅보다는 합성 및 생존 가능성에 있습니다. 게놈 길이가 길어질수록 구축하고 선별해야 하는 설계의 수가 모델링 비용보다 훨씬 빠르게 증가하기 때문입니다.
인공지능은 수년간 생물학적 부품을 설계하는 데 활용되어 왔습니다. 단백질, CRISPR-Cas 복합체, 트랜스포존, 프로모터, 독소-항독소 쌍 등이 다양한 AI 모델에 의해 생성되었습니다. 그러나 게놈 설계는 차원이 다른 문제이며, 그 규모에서의 AI 지원 설계는 지금까지 불가능한 영역이었습니다.
최근 스탠퍼드 대학교와 Arc 연구소의 연구진이 그 한계를 돌파했다고 보고했습니다. 이들은 게놈 언어 모델인 Evo 1과 Evo 2를 사용하여 박테리오파지 게놈 전체를 생성하고, 그중 약 300개를 화학적으로 합성하여 16개의 생존 가능한 파지를 회수했습니다.
이 설계들의 칵테일은 템플릿 파지에 내성을 갖도록 진화한 박테리아 균주를 성공적으로 억제했습니다. 유사한 자연 파지 칵테일로는 이러한 결과를 얻을 수 없었습니다.
게놈 연구의 1% 미만이 AI를 활용했습니다
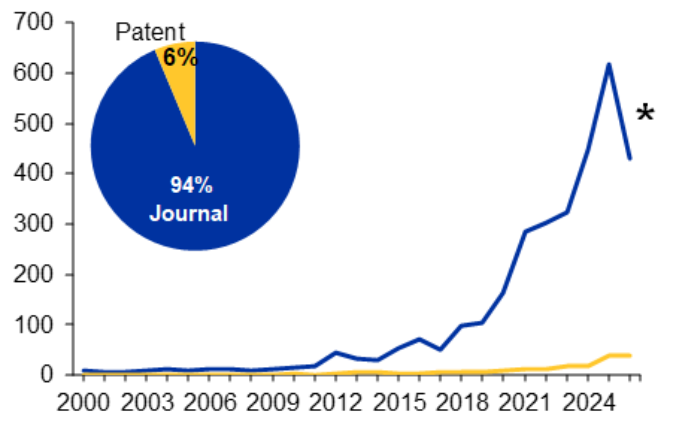
이러한 결과를 더 넓은 맥락에서 파악하기 위해, 1989년부터 2026년까지 게놈에 적용된 AI/ML 주제를 다루는 CAS Content Collection™에서 검색된 11,259건의 문헌을 분석했습니다. 이 문헌들은 예측 및 임상 게놈학이 주를 이루고 있습니다. 실제로 AI를 사용하여 게놈 서열을 설계하는 연구는 드물며, 전체 문헌의 0.78%인 88건에 불과합니다.
88건의 세부 분류는 다음과 같습니다:
- CRISPR 및 편집 설계(가이드 RNA 선택, 오프 타겟 및 편집 결과 예측)가 42건으로 가장 흔한 주제이며, 2018년부터 지속적으로 연구되어 온 가장 확립된 분야이기도 합니다.
- 조절 요소 설계(프로모터, 인핸서, UTR)은 18건을 차지합니다.
- 생성적 서열 설계(기존 서열을 평가하는 대신 새로운 뉴클레오타이드 서열을 생성하는 모델)은 10건으로 가장 최신 분야이며, 중간 출판 연도는 2025년입니다.
- 전체 게놈 및 염색체 규모 설계는 8건에 불과합니다.
이 수치는 작으며, 가장 최신 범주가 가장 작은 규모라는 점은 이것이 성장률을 나타내기보다는 이제 막 활동이 시작되는 단계임을 시사합니다. 88건의 설계 문헌 중 74건은 학술지 논문이며, 특허는 8건에 불과합니다. 즉, 생성적 게놈 설계는 여전히 학술 문헌의 영역에 머물러 있습니다.
현재 "게놈 언어 모델"은 몇 개나 존재할까요?
하지만 게놈 언어 모델 분야는 이미 포화 상태입니다. 2026년 체계적 문헌 고찰에 따르면 469건의 기록을 검토하여 58개의 모델 개발 연구를 확인했습니다. 대부분은 인코더 방식으로, 서열을 입력하면 점수나 임베딩이 출력되는 형태입니다. 이러한 모델이 전체 코퍼스의 주류를 이룹니다. DNABERT와 DNABERT-2는 34개 문서, Enformer는 13개, Caduceus는 5개, HyenaDNA와 Nucleotide Transformer는 각각 4개 문서에서 언급되었습니다. 그러나 이 중 검증된 게놈 설계 세트에 포함된 문서는 3건에 불과합니다. AlphaGenome은 이 유형의 가장 강력한 최신 모델로, 최대 100만 개의 염기를 읽고 조절 기능을 예측할 수 있지만, 서열을 직접 작성하지는 못합니다.
출판된 모델 외에도 코드와 가중치가 공개된 프리프린트 형태로만 제공되는 서열 생성 모델이 일부 개발 중입니다(표 1 참조).
표 1. 게놈 설계가 가능한 게놈 LLM 목록
상업적 활동은 현재 이 분야의 중심이 아닌 주변부에 머물러 있습니다.
- AI만으로 CRISPR 시스템을 설계했다고 발표한 Profluent는 일라이 릴리(Eli Lilly)와 유전 의학을 위한 AI 설계 재조합 효소에 관한 파트너십을 체결했습니다.
- Dyno Therapeutics는 유전자 전달을 위한 AAV 캡시드를 설계하며, 이를 아스텔라스(Astellas) 및 로슈(Roche)에 라이선스했습니다.
- Ginkgo Bioworks와 Basecamp Research는 모델이 아닌 학습 데이터를 공급합니다.
- NVIDIA는 Arc Institute와 공동으로 Evo 2를 개발하고 배포합니다.
- 비영리 단체인 Tatta Bio는 혼합 모달리티 모델인 gLM2를 공개했습니다.
게놈 자체를 설계하기 위한 프로그램은 여전히 드물며, 지금까지의 게놈 규모 연구는 대부분 컴퓨팅 파트너와 협력하는 비영리 및 학술 단체에서 주도해 왔습니다(이는 우리 코퍼스의 특허 현황과 일치합니다).
해당 그룹 내에서 Evo는 더 긴 실적과 더 넓은 컨텍스트를 보유하고 있습니다. Evo 1은 이미 기능적 CRISPR-Cas 및 트랜스포존 시스템과 그럴듯한 게놈 구조의 메가베이스 규모 서열을 생성했으며, Evo 2는 100만 토큰 윈도우 전반에 걸쳐 단일 뉴클레오타이드 해상도로 읽고 쓸 수 있습니다. 이러한 컨텍스트는 결정적인 강점입니다. 5.4킬로베이스 규모의 파지 게놈 전체를 한 번에 담을 수 있어, 모델이 독립적으로 점수화된 조각들을 조립하는 대신 유전자 순서, 조절 요소 배치, 패키징 신호를 한눈에 파악할 수 있습니다. 200만 개 이상의 박테리오파지 게놈을 포함한 파지 중심의 사전 학습 또한 중요하며, 이는 모델이 학습한 분포 내에 타겟을 위치시킵니다.
모델에게 어떤 작업을 수행하도록 요청했는가?
템플릿은 ΦX174였습니다. 이는 Microviridae 과에 속하는 작은 용균성 파지로, 5.4킬로베이스의 게놈에 11개의 유전자와 최소 7개의 조절 요소를 포함하고 있습니다. 높은 압축률, 수십 년간의 연구 데이터, 무해한 실험실 숙주 덕분에 매우 안전한 검증 환경을 제공했습니다. 두 모델 모두 합성 후보를 생성하기 전에 약 15,000개의 Microviridae 서열로 미세 조정되었습니다.
6단계 파이프라인의 한 단계로서의 AI
단순 생성만으로는 생존 가능한 게놈을 만들 수 없었습니다. 이번 시도와 이전의 실패 사례를 가르는 차이는 모델을 둘러싼 환경에 있습니다. 저자들은 6단계 파이프라인을 설명합니다:
- 사전 학습
- Microviridae를 대상으로 한 지도 미세 조정
- ΦX174 서열을 활용한 프롬프트 엔지니어링
- 게놈 구조를 점수화하고 숙주 범위를 예측하는 별도 모델을 통한 추론 단계의 제어
- 컴퓨팅 필터링
- 실험적 검증
프롬프트만으로는 충분하지 않았습니다. 어떤 길이의 프롬프트를 사용하더라도 기본 모델은 ΦX174를 복구하지 못했지만, 미세 조정된 모델은 이를 성공적으로 수행했습니다.
필터링은 후보군을 선별하는 핵심 단계로, 기본 서열 품질, 표적 숙주에 대한 특이성, 자연 서열과의 거리라는 세 가지 기준을 적용했습니다. 품질 관리를 통해 길이는 4~6kb, GC 함량은 30~65%로 제한했으며, 10염기 이상의 동종 중합체는 배제했습니다. 더 까다로운 검증은 생물학적 측면에서 이루어졌으며, 이 단계에서 구조 및 기능 예측이 설계 과정에 도입되었습니다. 생성된 단백질은 ESMFold로 폴딩되었으며, 그 평균 pLDDT 점수는 자연 단백질과 일치하면서도 무작위 대조군을 상회했습니다. 이는 해당 서열이 그럴듯해 보이는 염기 서열이 아니라 실제로 폴딩 가능한 단백질을 암호화하고 있음을 입증합니다. 유전체는 바이러스 분류기인 geNomad로 점수를 매겼고, 예측된 단백질은 OpenGenome 및 PHROGs 데이터베이스와 정렬되어, 알려진 서열과의 낮은 유사성에도 불구하고 현실적인 기능 주석 분포를 나타냈습니다.
널리 사용되는 6가지 유전자 주석 도구 중 어느 것도 야생형 ΦX174의 11개 유전자 전체를 주석 처리할 수 없었습니다. 이는 유전체의 중첩된 판독 프레임이 표준 개방형 판독 프레임 예측을 방해하기 때문입니다. 따라서 연구팀은 맞춤형 코딩 서열 예측기를 구축했습니다. 이 도구가 없었다면 생성된 유전체가 완전한 유전자 세트를 갖추었는지 확인할 방법이 없었을 것이며, 이는 필터 없는 생성 및 필터링 전략에 불과했을 것입니다.
AlphaFold 3 또한 설계 이후 단계에서 활용되었습니다. Evo-Φ36 캡시드 내 특이한 J 단백질의 방향을 예측하고, 비리온 외부에 내성 관련 돌연변이를 배치하는 데 사용되었습니다. 구조 예측은 설계 과정에서의 필터 역할과 이후의 설명 도구라는 두 가지 역할을 수행했습니다.
선별된 302개의 설계안 중 285개가 성공적으로 합성 및 조립되었습니다. 나머지는 합성 복잡성 문제로 실패했습니다. 16개는 Escherichia coli C의 성장을 억제했는데, 이는 Evo 1에서 227개 서열 중 12개(5.3%), Evo 2에서 58개 서열 중 4개(6.9%)에 해당합니다. 생존 가능성은 자연 유전체와의 서열 유사성에 비례했으며, 가장 유사한 설계안들 사이에서는 46.2%에 달했습니다. 즉, 모델이 진화의 표본에서 멀어질수록 실패 확률도 높아집니다.
이 연구가 진정한 진보인 세 가지 이유
- 규모. 이 계통에서 이전의 모든 생성적 성공은 부분적인 것이었습니다. 이번 연구는 살아있는 숙주 내에서 구성 요소들이 함께 기능해야 하는 완전한 자기 복제 유전체를 단 한 번의 운 좋은 결과물이 아닌, 엔드 투 엔드 프레임을 통해 구현해 냈습니다.
- 설계안은 템플릿의 단순 재조합이 아닙니다. 285개의 AI 설계 파지 중 하나인 Evo-Φ36을 2.9 Å 해상도의 극저온 전자 현미경으로 관찰한 결과, 이 파지는 먼 친척 관계인 Escherichia 파지 G4의 절단된 DNA 패키징 단백질 J(38개 잔기 대신 25개 잔기)를 포함하고 있었습니다. 해당 교체는 야생형 ΦX174에서는 생존 불가능한 것으로 보고된 바 있습니다. 모델은 본래 호환되지 않는 부품이 기능할 수 있는 환경을 조성했으며, 이는 모델이 서열을 암기한 것이 아니라 에피스타시스(상위성) 제약을 내재화했음을 보여주는 가장 명확한 증거입니다.
- 설계안은 진정한 독창성을 지닙니다. 자연계에 대응하는 서열이 없는 돌연변이, 발산된 유전자, 변경된 조절 서열, 가변적인 유전체 길이 등이 포함되었습니다. 편집은 프로모터 A, 유전자 J, 터미네이터 J와 같은 조절 및 구조적 제어 지점에 집중되었습니다.
세균 내성 극복
파지 치료는 항균제 내성이 심화됨에 따라 지속적인 관심을 받아왔으나, 낮은 생체 내 효능과 세균의 파지 내성 진화로 인해 한계가 있습니다. 세계보건기구(WHO)는 항균제 내성(AMR)을 세계 10대 보건 위협 중 하나로 지정하고 있습니다.
놀랍게도, King 등이 보고한 AI 설계 파지 혼합물은 ΦX174 내성 E. coli 균주에 효과적이었으나, 유사한 자연 ΦX174 유사 파지 혼합물은 그렇지 못했습니다.
임상 적용까지의 거리
임상적 전환은 아직 초기 단계입니다. 2026년 8월 12일 기준 ClinicalTrials.gov에 등록된 파지 기반 중재 연구는 약 96건이며, 그중 절반 가까이가 모집 중이거나 활성 상태, 또는 시작 전 단계입니다. 임상 단계가 보고된 연구 중에서는 1상과 2상이 71건 중 62건으로 대다수를 차지합니다. 표적 질환으로는 낭성 섬유증의 Pseudomonas aeruginosa 감염, 요로 감염, 당뇨병성 족부 궤양, 인공 관절 감염 등이 있습니다. 이미 엔지니어링된 파지가 환자에게 적용된 사례도 있습니다. SNIPR001은 플루오로퀴놀론 내성 E. coli를 보유한 조혈모세포 이식 환자를 대상으로 1b/2상 연구(NCT06938867)를 진행 중입니다.
이 규모의 설계가 가진 도전 과제
설계된 파지는 임상 병원균이 아닌 무해한 실험실 균주인 E. coli C에서 테스트되었습니다. Klebsiella나 Pseudomonas를 표적으로 하는 파지는 일반적으로 40~100kb 규모로, 여기서 사용된 5.4kb 템플릿보다 10배 더 큽니다. 저자들은 이 정도 규모의 DNA를 합성하고 조립하는 비용이 설계의 가장 큰 장애물이라고 지적합니다. 생물학적 의약품이 겪는 일반적인 난관(제조 일관성, 면역원성, 내독소 제어)은 AI 설계 유전체라고 해서 달라지지 않습니다.
컴퓨팅 파워가 한계점일 것이라 예상하기 쉽지만, 실제로는 그렇지 않습니다. Evo는 서열 길이의 제곱에 비례하여 비용이 증가하는 표준 트랜스포머 아키텍처를 사용하지 않습니다. 대신 비용이 선형적으로 증가하므로, 100kb 파지나 4.6Mb 세균 유전체도 충분히 관리 가능한 수준입니다. 컨텍스트 길이 또한 무리하게 확장하지 않았으며, 모델은 한 번에 8kb를 읽는데 이는 설계 중인 유전체보다 충분히 긴 길이입니다. 3.1Gb 규모의 인간 유전체는 다른 문제이며 아키텍처 개선이 필요할 것입니다. 실제로 확장성이 떨어지는 것은 생존 가능성입니다. 성공적으로 합성된 285개 유전체 중 16개만이 작동하는 파지를 생성(5.6%)했으며, 자연 서열과 가장 가까운 설계안들 사이에서만 46.2%로 상승했습니다. 유전체 내 단 하나의 돌연변이로도 유전체가 사멸할 수 있으며, 킬로베이스가 추가될 때마다 정확하고 상호 호환되어야 하는 유전자, 조절 요소, 패키징 신호가 늘어납니다. 즉, 유전체 길이에 따라 급격히 증가하는 부담은 계산적인 것이 아니라 실험적인 것입니다. 작동하는 파지를 얻기 위해 구축하고 선별해야 하는 설계안의 수는 이를 작성하는 데 필요한 컴퓨팅 자원보다 훨씬 빠르게 증가합니다.
학습 데이터의 가용성이 두 번째 한계입니다. 이번 결과는 사전 학습에 사용된 200만 개 이상의 박테리오파지 유전체와 미세 조정에 사용된 템플릿의 근연종 약 15,000개를 기반으로 하므로, 표적은 모델이 학습한 분포 내에 있었습니다. 특정 임상 분리주를 표적으로 하는 맞춤형 100kb 파지의 경우, 이 정도의 근연종 밀도를 확보하기 어렵습니다. 진핵생물 유전체의 경우 문제는 더욱 복잡해집니다. 진핵생물의 기능은 염색질 상태, 스플라이싱, 원거리 조절 등에 의존하는데, 이는 1차 서열만으로는 충분히 결정되지 않기 때문입니다. 습식 실험의 선례는 시사하는 바가 큽니다. 1.08Mb 세균 유전체가 2010년에 화학적으로 합성되어 이식되었고 2016년에는 최소화된 후속 유전체가 뒤따랐지만, 완전히 통합된 합성 효모 균주는 약 20년이 지난 지금까지도 미완성 상태입니다. 이를 가능하게 하는 방법론은 발전하고 있지만, 파지 규모에서 285개 설계안을 선별할 수 있게 했던 처리량을 제공하는 기술은 아직 없습니다.
저자들은 또한 모든 단계에서 안전 및 보안 전문가를 참여시킬 것을 권고합니다. 이러한 조언은 대상이 무해한 실험실 파지에서 임상 병원체로 옮겨감에 따라 더욱 큰 무게를 갖게 됩니다.
결과는 명확하고 확실합니다. 잘 규명된 템플릿이 주어지면 언어 모델은 작동 가능한 바이러스의 유전체를 작성할 수 있으며, 내성을 극복하는 데 있어 자연적인 바이러스를 능가합니다. 관련 문헌들과 비교해 볼 때, 이는 수년간 가이드 RNA 선택을 완성하는 데 집중해 오다 최근 들어서야 서열을 직접 작성하기 시작한 분야에서 중요한 이정표가 됩니다. 이제 치료용 파지로의 확장은 모델링 문제만큼이나 합성 및 안전성 문제가 되었습니다.