
エグゼクティブサマリー
- スタンフォード大学とArc Instituteの研究チームは、ゲノム言語モデル「Evo 1」および「Evo 2」を用いてバクテリオファージの全ゲノムをゼロから作成し、約300種類の設計を合成した結果、16個の生存可能なウイルスを回収しました。
- AIが設計したファージのカクテルは、大腸菌の天然鋳型ファージに対する耐性株を死滅させました。これは、同等の天然ファージの混合物では達成できなかった成果です。
- 治療用ファージを実現するための残された障壁は、計算能力よりも合成と生存能力にあります。なぜなら、ゲノム長が長くなるにつれて、構築およびスクリーニングが必要な設計数は、モデリングコストよりもはるかに速いペースで増加するからです。
人工知能は、数年前から生物学的パーツの設計支援に活用されてきました。タンパク質、CRISPR-Cas複合体、トランスポゾン、プロモーター、毒素・抗毒素ペアなどが、さまざまなAIモデルによって生成されています。しかし、ゲノムの設計はそれとは異なる課題であり、その規模でのAI支援設計はこれまで到達困難な領域でした。
最近、スタンフォード大学とArc Instituteの研究チームがその一線を越えたと報告しました。彼らはゲノム言語モデル「Evo 1」および「Evo 2」を使用してバクテリオファージの全ゲノムを生成し、そのうち約300種類を化学的に合成して、16個の生存可能なファージを回収しました。
これらの設計をカクテルとして投与したところ、鋳型ファージに対して耐性を獲得した細菌株の増殖を抑制することに成功しました。同等の天然ファージのカクテルでは、これを達成することはできませんでした。
AIを活用したゲノム研究は全体の1%未満
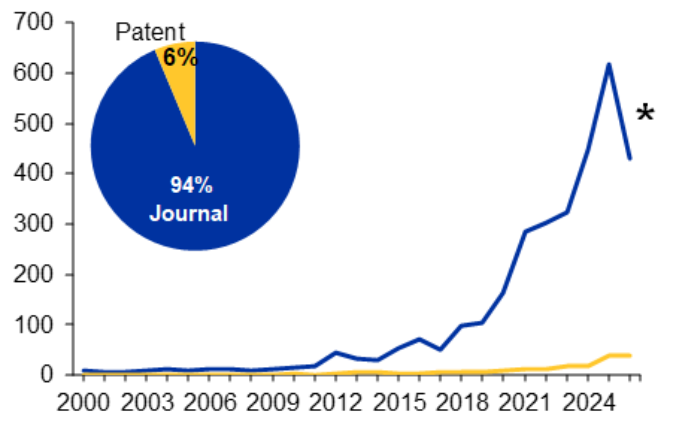
これらの結果をより広い文脈で捉えるため、私たちはCAS Content Collection™から抽出した、1989年から2026年にわたるゲノムへのAI/ML適用に関する11,259件の文献を分析しました。このコーパスは予測ゲノミクスと臨床ゲノミクスが大部分を占めています。実際にAIを用いてゲノム配列を設計する研究は稀であり、このコーパス全体のわずか0.78%にあたる88件に過ぎません。
その88件の内訳は以下の通りです。
- CRISPRおよび編集設計(ガイドRNAの選択、オフターゲット予測、編集結果の予測)が42件で最も一般的なトピックであり、2018年から継続的に行われている最も確立された分野でもあります。
- 制御エレメントの設計(プロモーター、エンハンサー、UTR)は18件です。
- 生成的な配列設計(既存の配列をスコアリングするのではなく、新しいヌクレオチド配列を出力するモデル)は10件で、最も新しい分野であり、出版年の中央値は2025年です。
- 全ゲノムおよび染色体スケールの設計はわずか8件です。
これらは小さな数字であり、新しいカテゴリーほど件数が少ないことから、成長率というよりも活動の端緒を示していると言えます。88件の設計関連文献のうち74件は学術論文であり、特許はわずか8件です。生成的なゲノム設計は、依然として学術的な文献の域に留まっています。
「ゲノム言語モデル」はいくつ存在するのでしょうか?
しかし、ゲノム言語モデルの分野はすでに飽和状態にあります。2026年のシステマティックレビューでは、469件の記録を精査し、モデル開発に関する研究を58件特定しました。その大半はエンコーダーであり、配列を入力するとスコアや埋め込みが出力される仕組みです。これらがコーパスの主流を占めています。DNABERTおよびDNABERT-2は34件の文書に、Enformerは13件、Caduceusは5件、HyenaDNAとNucleotide Transformerはそれぞれ4件の文書に登場します。しかし、我々が検証したゲノム設計セットに含まれるのは、そのうちわずか3件に過ぎません。AlphaGenomeは、この種のモデルとしては最近最も強力なものですが、最大100万塩基を読み取り、調節機能への影響を予測することはできても、配列を生成することはできません。
公開済みのモデル以外にも、開発中のモデルがいくつか存在します。これらはプレプリントとしてのみ入手可能であり、コードと重みは公開されています(表1を参照)。
表1。ゲノム設計が可能なゲノムLLMの一覧
商業的な活動は現在、このトピックの中心ではなく周辺にとどまっています。
- AIのみを用いてCRISPRシステムを設計したと報告しているProfluent社は、イーライリリー社と遺伝子治療のためのAI設計リコンビナーゼに関する提携を発表しました。
- Ginkgo Bioworks社とBasecamp Research社は、モデルではなく学習データを提供しています。
- NVIDIAは、Arc Instituteと共同でEvo 2を開発し、配布しています。
- 非営利団体のTatta Bioは、混合モダリティモデルであるgLM2を公開しました。
ゲノムそのものを設計することを目的としたプログラムは依然として少なく、これまでのゲノムスケールの研究は、主に計算リソースのパートナーを持つ非営利団体や学術機関によって行われてきました(これは我々のコーパスにおける特許の状況とも一致しています)。
そのグループの中で、Evoはより長い実績とより大きなコンテキストウィンドウを有しています。Evo 1はすでに機能的なCRISPR-Casシステムやトランスポゾンシステム、そして妥当なゲノム構造を持つメガベーススケールの配列を生成しており、Evo 2は100万トークンのウィンドウ全体にわたり、単一ヌクレオチド解像度で読み書きが可能です。このコンテキストこそが決定的な特性です。5.4キロベースのファージゲノム全体を一度に収めることができるため、モデルは個別にスコアリングされた断片からゲノムを組み立てるのではなく、遺伝子の順序、調節領域の配置、パッケージングシグナルを一度に把握できます。また、200万以上のバクテリオファージゲノムを用いたファージ重視の事前学習も重要であり、ターゲットをモデルが学習した分布の中に配置しています。
モデルにはどのようなタスクが課されたのでしょうか。
The template was ΦX174: a small lytic member of the Microviridae, whose 5.4-kilobase genome carries 11 genes and at least seven regulatory elements. Compactness, decades of characterization, and a harmless laboratory host made it an unusually safe proving ground. Both models were fine-tuned on approximately 15,000 Microviridae sequences before any candidate went to synthesis.
6段階のパイプラインにおけるAIの役割
生の生成結果だけでは、生存可能なゲノムは得られませんでした。今回の試みと過去の失敗との違いは、主にモデルを取り巻く環境にあります。著者らは6段階のパイプラインを記述しています。
- 事前学習
- Microviridaeを用いた教師ありファインチューニングMicroviridae
- ΦX174配列を用いたプロンプトエンジニアリング
- ゲノム構造をスコアリングし、宿主域を予測する個別のモデルによる推論時の制御
- 計算によるフィルタリング
- 実験的検証
プロンプトのみでは不十分でした。プロンプトの長さを変えてもベースモデルはΦX174を復元できませんでしたが、ファインチューニングされたモデルでは復元が可能でした。
候補の大部分は、基本的な配列品質、標的宿主に対する特異性、自然界の配列からの距離という3段階のフィルタリングで排除されました。品質管理では、長さを4〜6キロベース、GC含有量を30〜65%、ホモポリマーを10塩基以下に制限しました。より困難なのは生物学的なチェックであり、ここで設計ループに構造および機能予測が組み込まれました。生成されたタンパク質はESMFoldで折り畳まれ、その平均pLDDTスコアは自然界のタンパク質と同等で、スクランブル対照群を上回りました。これは、生成された配列が単なるもっともらしい塩基配列ではなく、折り畳み可能なタンパク質をコードしている証拠です。ゲノムはウイルス分類ツールgeNomadでスコアリングされ、予測されたタンパク質はOpenGenomeおよびPHROGsデータベースと照合されました。その結果、既知の配列との同一性が低いにもかかわらず、機能アノテーションにおいて現実的な分布が得られました。
広く利用されている6種類の遺伝子アノテーションツールのいずれも、野生型ΦX174の全11遺伝子をアノテーションできませんでした。これは、ゲノムの重複する読み取り枠が標準的なオープンリーディングフレーム予測を阻害するためです。そのため、チームは独自のコーディング配列予測ツールを構築しました。これがなければ、生成されたゲノムが完全な遺伝子セットを保持しているかを確認する術はなく、フィルタリング機能のない「生成してフィルタリングする」戦略になっていたでしょう。
AlphaFold 3も活用されましたが、それは設計の後段階です。Evo-Φ36カプシドにおける特殊なJタンパク質の配向予測や、ビリオン外表面への耐性関連変異の配置に使用されました。構造予測は、設計時のフィルターと、設計後の説明ツールの2つの役割を果たしました。
精査された302の設計のうち、285が合成・構築に成功しました。残りは合成の複雑さが原因で失敗しました。16の設計がEscherichia coli Cの増殖を阻害しました。これはEvo 1の227配列中12(5.3%)、Evo 2の58配列中4(6.9%)に相当します。生存率は自然ゲノムとの配列類似性に比例し、最も近い設計では46.2%に達しました。モデルが進化のサンプルから遠ざかるほど、失敗の頻度は高まります。
これが真の進歩である3つの理由
- 規模。これまでのこの分野における生成の成功例は、すべて「部品」単位でした。今回は、構成要素が宿主内で協調して機能しなければならない完全な自己複製ゲノムであり、単なる幸運な構築物ではなく、エンドツーエンドのフレームワークを通じて実現されました。
- 設計はテンプレートの組み換えではありません。AIが設計し合成された285のファージのうちの1つであるEvo-Φ36をクライオ電子顕微鏡で2.9 Åの解像度で観察したところ、遠縁のEscherichiaファージG4由来の短縮型DNAパッケージングタンパク質J(38残基の代わりに25残基)を保持していることが判明しました。この置換は、野生型ΦX174では生存不能であると報告されていたものです。モデルは、本来なら互換性のない部品が機能するコンテキストを構築しました。これは、モデルが配列を記憶したのではなく、エピスタティックな制約を内部化したことを示す最も明確な証拠です。
- 設計には真の新規性があります。自然界には存在しない変異、分岐した遺伝子、改変された調節配列、可変的なゲノム長などが含まれています。編集はプロモーターA、遺伝子J、ターミネーターJに集中しており、これらはすべて調節および構造上の制御ポイントです。
細菌耐性を上回る
ファージ療法は、抗菌薬耐性の深刻化に伴い継続的な関心を集めていますが、生体内での有効性の低さと、細菌がファージに対する耐性を獲得することから、依然として限界があります。世界保健機関(WHO)は抗菌薬耐性(AMR)を世界的な健康に対する脅威の上位に位置づけています。
注目すべきことに、Kingらによって報告されたAI設計ファージの混合物は、ΦX174耐性E. coli株に対して有効でしたが、同等の天然ΦX174様ファージの混合物は有効ではありませんでした。
臨床応用への距離
臨床への橋渡しはまだ初期段階にあり、ClinicalTrials.govにはファージベースの薬剤に関する介入研究が約96件登録されています(2026年8月12日時点)。その半数近くが被験者募集、進行中、または未開始の状態です。フェーズが報告されている試験では、第1相および第2相が大部分(71件中62件)を占めています。標的には、嚢胞性線維症におけるPseudomonas aeruginosa、尿路感染症、糖尿病性足潰瘍、人工関節感染症などが含まれます。遺伝子組み換えファージはすでに患者への投与段階にあり、SNIPR001はフルオロキノロン耐性E. coliを保有する造血幹細胞移植患者を対象とした第1b/2a相試験(NCT06938867)が行われています。
この規模での設計における課題
設計されたファージは、臨床病原体ではなく、無害な実験用株であるE. coli Cで試験されました。KlebsiellaやPseudomonasを標的とするファージは通常40〜100キロベースあり、今回使用された5.4キロベースのテンプレートより一桁大きいため、著者らはこれらDNAの合成と構築にかかるコストを設計上の最大の障害として挙げています。医薬品に共通するハードル(製造の一貫性、免疫原性、エンドトキシン管理)は、AI設計ゲノムであっても変わりません。
計算能力が壁になると予想されがちですが、今回はそうではありません。Evoは、配列長の二乗でコストが増大する標準的なトランスフォーマーアーキテクチャを使用していません。そのコストは線形に近い形で上昇するため、100キロベースのファージや4.6メガベースの細菌ゲノムであっても、管理可能なステップアップとなります。コンテキスト長も拡張されておらず、モデルは一度に8キロベースを読み取りますが、これは作成対象のゲノムよりも十分に長いものです。3.1ギガベースのヒトゲノムは別問題であり、アーキテクチャの改良が必要になるでしょう。スケーリングが困難なのは生存率です。合成に成功した285のゲノムのうち、機能するファージを生成したのは16(5.6%)であり、自然配列に最も近い設計でのみ46.2%に上昇しました。ゲノムのどこか一箇所の変異でゲノムが死滅する可能性があり、キロベースが増えるごとに、正しく相互に適合しなければならない遺伝子、調節要素、パッケージングシグナルが増加します。結論として、ゲノム長とともに急激に増大する負荷は計算上の問題ではなく、実験上の問題です。機能するものを回収するために構築・スクリーニングしなければならない設計数は、それを記述するために必要な計算量よりもはるかに速く増加します。
学習データの可用性が2つ目の制限要因です。今回の結果は、事前学習における200万以上のバクテリオファージゲノムと、ファインチューニングにおけるテンプレートの約15,000の近縁種に基づいているため、標的はモデルが学習した分布の範囲内に収まっていました。特定の臨床分離株に対する100キロベースの特注ファージの場合、そのような近縁種の密度は得られず、真核生物ゲノムの場合は問題の性質が変わります。真核生物の機能は、一次配列だけでは決定できないクロマチン状態、スプライシング、長距離調節に依存するためです。ウェットラボの先例は厳しい現実を示しています。1.08メガベースの細菌ゲノムが化学合成され移植されたのは2010年であり、最小化された後継ゲノムが2016年に続きましたが、完全に統合された合成酵母株は、約20年が経過しても未完成のままです。実現を可能にする手法は進歩していますが、ファージ規模で285の設計スクリーニングを可能にしたようなスループットを実現できるものはまだありません。
著者らはまた、あらゆる段階で安全・セキュリティの専門家を関与させることを推奨しています。この助言は、対象が無害な実験用ファージから臨床的な病原体へと移行するにつれて、より重みを増すものです。
その結果は限定的でありながら確かなものです。十分に特性が解明されたテンプレートがあれば、言語モデルは機能するウイルスとなるゲノムを書き出し、耐性を打破する能力において天然のウイルスを凌駕しました。広範な文献に照らして見ると、これは長年ガイドRNAの選択を洗練させ、つい最近になって配列の直接的な記述を開始した分野における重要な指標となります。治療用ファージへのスケールアップは、今やモデリングの問題であると同時に、合成と安全性の問題でもあります。