
エグゼクティブサマリー
- 多くのAIモデルは管理されたテスト環境では優れた性能を発揮しますが、実際の実験データに適用すると機能しなくなり、研究開発の進捗を遅らせ、研究者の信頼を損なう原因となります。
- 精査された科学データは、測定可能なレベルでモデルの精度を向上させます。CASの調査によると、薬物とタンパク質の結合研究において、科学者が検証した原子マッピングを使用することで、学習データが半分でも予測精度が約2倍になり、合成経路の予測では30%以上の改善が見られました。
- 持続的なAI成熟度は、データガバナンス、ワークフローの検証、データの持続可能性という3つの運用プラクティスが連携することで実現します。
AIは科学研究開発の分野で着実に浸透しています。しかし、多くの組織が、初期段階のモデルを実際の研究に適用すると、期待通りの性能を発揮しないという事実に直面しています。管理された評価環境では信頼できるように見えるアルゴリズムも、実際の研究環境特有の変動性、文書化の慣習、実験の多様性に直面すると、一貫性のない挙動を示すことがよくあります。この乖離は、研究開発におけるAI成熟度をより高める必要性を示唆しています。
挙動の差異を生む大きな要因は、基盤となるデータの構造です。実験結果は、測定がどのように生成され、その結果がどのように記録されたかに依存します。これらの詳細は、機器やプロトコルの違いから、単位、命名規則、さらには実験ノートに記録される詳細レベルに至るまで、チーム間で大きく異なります。さらに、限られた狭い範囲のデータで学習された多くのAIシステムは、当初の静的な想定を超えた予期せぬ変動を解釈できません。適切な準備がなされていないと、予測は不安定になり、実験室での検証段階で破綻してしまいます。こうした不整合が蓄積されることで、プロトタイプ時の性能と実際の運用環境との間にギャップが生じ、初期のAI導入効果が限定的になるだけでなく、組織としてより深刻な課題に直面することになります。
科学研究開発においてAIの進歩が停滞する理由
これらの課題は、多くの研究開発組織に共通する、より根深い成熟度のギャップを反映しています。初期のAIモデルは管理されたテスト環境ではうまく機能しますが、実際の実験データに触れたり、複数の研究プロジェクトに展開されたりすると、性能が低下し、進捗が停滞します。モデルが不整合な入力データに直面したり、結果を解釈するために必要な文脈的根拠を欠いていたり、あるいはシームレスなデータフローを妨げる分断されたデジタルインフラを利用していたりすると、綻びが生じます。これらの問題は、ボトルネックがモデルそのものではなく、それを取り巻くデータ、プロセス、インフラの準備状況にあることを明らかにしています。この崩壊がどこで発生しているかを理解することは、科学研究開発においてAIの成熟度を達成することがなぜ困難なのかを説明する助けとなります。
科学データのばらつきが、不正確で信頼性の低い結果を生む
「ゴミを入れればゴミが出てくる(Garbage In, Garbage Out)」という言葉はよく知られていますが、科学研究開発においては、より深い構造的な課題を反映しています。実験結果は、フォーマット、用語、メタデータの取得に関する慣習が異なる機器、実験チーム、文書化システムから生成されます。2つのグループが同じアッセイを実行しても、出力ファイルの構造、単位、文脈の詳細、さらには命名規則さえも大きく異なる場合があります。しかし、構造的な不整合は、より重大な問題に比べれば二次的なものです。それは、実験条件そのもの(温度、機器の校正、タイミングなど)が結果を劇的に変化させる可能性があり、これらの変数がチーム間で十分に文書化されていなかったり、一貫性のない方法で記録されていたりすることが多いためです。数値が比較可能に見えても、それを生み出した条件が異なっている可能性があります。学習データにこうした不整合が含まれていると、モデルは意味のある科学的な変動と、報告上のアーティファクト(人為的な誤差)を確実に区別できません。不適切な識別子、欠落したメタデータ、不完全な記録は、モデルが基盤となる科学の安定した表現を形成することを妨げ、結果として学習されたパターンが不正確で、出力が信頼できないモデルを生み出すことになります。
学習済みモデルを実際に使用する際にも、同様に深刻な2つ目の問題が発生します。たとえ優れたモデルであっても、実際の運用時にモデルに入力されるデータが、元の学習データとは異なる前提条件で準備されていれば、モデルは機能しなくなります。学習パイプラインと推論パイプラインの間で、単位、識別子、実験の文脈、ファイル構造に違いがあると、モデルは入力を誤って解釈し、信頼できない、あるいは使用不可能な予測を生成してしまいます。したがって、学習データの前提条件と実際のデータパイプラインとの整合性を維持することは、アクティブな研究開発環境に展開されるあらゆるAIソリューションにとって継続的な要件となります。
不明瞭な推論がAI出力への信頼を低下させる
説明可能性も、AI技術の導入において重要な要素です。確立された実験結果に基づいて研究者やリーダーが期待する挙動と、モデルの挙動が一致しない場合、AIモデルの利用は減少します。科学者は、実験によって検証可能な予測や出力を信頼します。予測が(一般的に)構造化データに遡れなかったり、明確な推論経路を辿れなかったりすると、システムへの信頼は損なわれます。なぜその予測がなされたのかという明確な理由がなければ、研究者はそれを進行中の実験に組み込むことを躊躇します。
システムがどの入力が予測や結果に影響を与えたかを示さない場合、不確実性はさらに深まります。アッセイのセットアップ、サンプルの属性、分子記述子のわずかな違いが結果に影響を与える可能性があります。モデルの結論が何に基づいているのかを可視化できなければ、チームは出力が科学的に適切かどうかを判断できません。時間が経つにつれて、こうした説明可能性の欠如は導入を制限し、トラブルシューティングを妨げ、AIがアクティブな研究プログラムを確実にサポートまたは加速させる能力を低下させます。
断片化されたインフラがデータの連続性を遮断する
予測と入力を結びつける確固たる推論経路を形成できるかどうかに加え、もう一つの課題として断片化されたデジタルインフラが挙げられます。多くの研究グループは、デジタル移行の異なる段階で採用されたソフトウェアに依存しており、その結果、データやアルゴリズムが孤立したプラットフォームに分散してしまっています。実験記録はある環境に存在し、分析結果や独自の参照データは別の場所に保存されているといった状況です。
こうした分断はデータの連続性を損ない、モデルがどのように出力を生成したのか、あるいはその出力が特定の実験条件とどのように関連しているのかを追跡することを困難にします。システム間でデータを確実に交換できない場合、チームは手作業でファイルをコピーしたり、結果をエクスポートしたり、プラットフォーム間で記録を再構築したりせざるを得ません。こうした手作業による転送はエラーのリスクを高め、断片化されたワークフローを通じて移動する情報に依存する予測の信頼性を低下させます。長期的には、エンドツーエンドの統合が欠如していることで再現性が制限され、反復作業が遅延し、アクティブな研究プログラムにおけるAIの有効性が制約されます。
科学研究開発のための「成功の三角形(Triangle of Success)」フレームワーク
これらの課題に対処するため、CASは科学研究開発に特化した構造的パートナーシップフレームワークとして「成功の三角形」を活用しています。このモデルは、調整された科学的レビュー、意図的な技術設計、および構造化されたナレッジマネジメントが、いかにして安定したモデル動作に必要な条件を作り出すかを説明するものです。これら3つの柱にわたる専門知識を連携させることで、組織はデータ、インフラストラクチャ、科学的基盤を体系的に強化し、AI成熟度を高めるための進歩を加速させることができます。
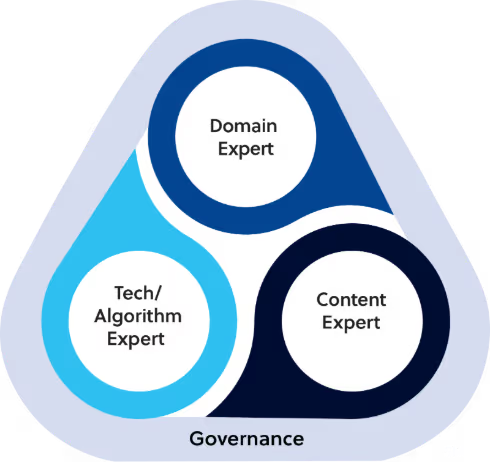
「成功の三角形」は、AIライフサイクルの2つの重要な段階に適用されます。1つ目はモデル作成段階です。予測課題が科学的に正しく定義されているか、トレーニングデータが適切なコンテキストと品質を備えているか、そしてAIのアプローチがユースケースに適合しているかを確認します。2つ目はモデル適用段階です。モデルのトレーニングと検証が完了した後、このフレームワークは、当初の前提条件が維持されているか、入力データがモデル構築時の条件を満たし続けているか、そして研究環境の変化に応じて出力が信頼できる状態を保っているかを検証することで、実世界の研究ワークフローへの導入を導きます。これら2つの適用を組み合わせることで、AIの能力が目的のために構築され、活用されることが保証されます。
このフレームワークは、各グループの明確でありながら相互依存的な貢献を強調しています。ドメインエキスパートは実験の変動性を解釈し、コンテンツエキスパートはデータを標準化・安定化させ、テクノロジーエキスパートはデジタルインフラストラクチャのエコシステムを統合します。これらが一体となることで、AIが研究開発の意思決定に確実に影響を与えるために必要な安定性と科学的基盤が提供されます。
ドメインエキスパート
組織内のドメインエキスパートは、科学的知識と実世界の研究経験を活かし、AIモデルが正確に動作しているかを評価します。主な責務は以下の通りです。
- どの実験要因が結果に影響を与えるか、またそれをデータにどのように反映させるべきかを明確にする。
- モデルが何を学習すべきか、またどこに科学的な制約を適用すべきかという期待値を設定する。
- 出力がデータ内のアーティファクト(人為的産物)ではなく、確立された科学的知見と整合しているかを確認する。
コンテンツエキスパート
コンテンツエキスパート(CASのスペシャリストや専門家など)は、AIシステムに入力される科学情報が正確かつ検証済みであることを保証し、各入力が不整合や不完全な記録ではなく、確立された関係性を反映していることを確認します。彼らは以下の方法でガイダンスを提供します。
- 化学、生物学、材料科学にわたる検証済みの関係性を反映したデータセットを作成する。
- モデルの安定性を損なう、競合する識別子、欠落したメタデータ、一貫性のない用語、その他の問題を解決する。
- 入力データが実際の研究開発環境で観察される内容を表現できるよう、検証済みの科学的ソースからコンテキストを追加する。
- データセットの来歴を保持し、分野の発展に合わせて最新の科学的知見と整合性を保つコンテンツシステムを維持する。
テクノロジーおよびアルゴリズムエキスパート
テクノロジーおよびアルゴリズムのスペシャリストは、AIシステムが研究プログラム全体で確実に機能するためのインフラストラクチャを構築します。彼らは以下の方法でAI開発を支援します。
- パイプラインを通じたデータの移動を自動化するシステムを構築し、手作業を排除してエラー率を低減する。
- 新しいデータによってシステムが更新された際のモデルの挙動を監視し、パフォーマンスの変化に応じてワークフローを調整する。
- 予測結果を既存の研究ツールに統合し、チームが日常的な意思決定のプロセスで活用できるようにします。
なぜ優れたデータがより精度の高い予測モデルにつながるのか
科学研究開発におけるAIの成熟度は、各モデルの学習に使用されるデータの品質と一貫性に左右されます。「成功のトライアングル」を実践に適用した場合、その影響は学習データの品質と、それに続くモデルのパフォーマンスに最も顕著に表れます。精査された入力データは、モデルが学習すべき関係性をより明確に提示するため、実際の研究現場での信頼性を損なうノイズを低減します。CASの調査結果は、より強固なデータ基盤が、より安定した正確なモデルの挙動を生み出すことを裏付けています。
ある薬物とタンパク質の結合予測研究では、科学者が精査したCASデータで学習させたモデルは、データポイントを50%削減しながらも、約2倍の予測精度を実現しました。この改善により、不要な追試が減り、チームはより有望な結合候補をワークフローの初期段階で優先的に検討できるようになりました。*
合成経路予測に関する別の評価でも、同様の向上が見られました。 科学者が検証した原子マッピングを学習データに追加したところ、 経路予測の精度が30%以上向上しました。 検証済みのマッピングによって、以前はモデルを誤った方向に導いていた構造的な曖昧さが解消され、実験結果とより整合性の高い予測が可能となり、修正のための反復作業も削減されました。**
これらの調査結果は、専門家によるレビューを経た調和のとれた科学データで学習させた場合に、AIモデルがより効果的に機能することを示しています。こうした成果を一貫して得るには、単発的な改善以上の取り組みが必要です。時間の経過とともに成熟度を高める運用体制の構築が不可欠です。
AIの成熟度を高める運用のステップ
組織のAIおよびデータ戦略が、チームによるデータ準備の方法からプロジェクトでの予測結果の活用に至るまで、日々の研究開発の意思決定に反映されるようになると、AIの成熟度は向上します。進歩のためには、研究ニーズに適応し、ワークフローに入力されるデータとそこから導き出される予測結果との間に明確なつながりを維持するシステムを構築することが重要です。
3つの運用プラクティスは、チームが初期のパイロット段階から、より成熟した信頼性の高いAI活用ワークフローへと移行する一助となります。
データガバナンス
- ワークフローへの入力前にデータを準備するためのルールを策定する
- 入力データと予測結果が科学的な期待値に適合しているかを確認するチェック体制を定義する
- データセットの変更、モデルの更新、評価ステップに関する文書を維持する
- データのレビューおよびワークフロー更新の承認に関する責任の所在を明確にする
ワークフローの検証
- 前処理やモデル設定を含む、予測生成に使用されたすべてのステップを保存し、結果の追跡と再現を可能にする
- 異なるチームによる実行や異なるタイミングでの再実行を通じて、安定性を確認する
- 科学スタッフと技術スタッフが連携し、不一致の確認と解決を行う
- ワークフローが他のプロジェクトをサポートできるほど十分に安定していると判断するための明確な基準を設定する
データの持続可能性
- 厳格な取り込みプロセスを通じて厳選された新しいデータを追加し、モデルを最新の科学的知見に適合させます
- ワークフローへの導入前に、すべての新規データセットに対して標準化されたフォーマット、メタデータ、コンテキストルールを適用します
- 検索拡張生成(RAG)手法を用い、推論時にモデルが最新の科学的ソースを参照できるようにします
- データパターンや前提条件の変化を監視し、データセットやモデルを更新することで、予測精度の低下を防ぎます
データガバナンス、ワークフローの検証、データの持続可能性がワークフロー全体で維持されることで、AIの信頼性が高まり、より高度な成熟度への進化が促進されます。
AIの成熟度が科学的ワークフローと成果をどのように強化するか
AIの成熟度は、科学組織が実験の設計やプログラムの方向性に影響を与える意思決定において、モデルの出力を信頼できるかどうかを左右します。多くのチームは管理された評価環境では高いパフォーマンスを示しますが、測定のばらつきやワークフローの違いが挙動に影響を及ぼす実際のR&D環境では、信頼性が低下してしまいます。
成熟度を高めるには、各モデルの基盤となる科学的根拠を強化することが不可欠です。ドメインエキスパートは、システムが従うべき研究の前提条件や科学的制約を明確にし、モデルの推論が確立された知見と整合するようにします。テクノロジーリードは、再現性を維持し、データの来歴を追跡し、データの進化に合わせて出力の追跡可能性を確保するデジタル環境を管理します。コンテンツエキスパートは、実際の挙動を反映し、学習を不安定にする不整合を排除した、調和のとれた検証済みの入力データを提供します。
これらの能力が連携することで、AIシステムは科学的な精査の下でも一貫したパフォーマンスを発揮し、日々の意思決定をより確信を持ってサポートできるようになります。
CASがお客様のAIジャーニーの次のステップをどのように支援できるかについては、こちらの「Science-smart AI」リソースをご覧ください。
- - -
* CASのケーススタディ:タンパク質標的に対するリガンドの生物活性予測精度において、科学者が厳選した高品質なコンテンツが与える影響を紹介します。ノイズの多い公開データではなくCASが厳選したコンテンツを使用することで、モデルは元の半分以下の学習データ量で予測精度を2倍に向上させました。
** Molecule.One社との共同開発によるケーススタディ。公開されている反応データで学習した逆合成モデルを、CASデータを用いて再学習させました。化学予測の精度に不可欠な、反応物と生成物の原子間のマッピングを科学者が精査したデータが活用されています。CASデータを使用することで、熟練の合成化学者の評価において、有効な合成ルートの正確な予測が30%向上しました。


