
Resumen ejecutivo
- Muchos modelos de IA funcionan bien en pruebas controladas, pero fallan cuando se aplican a datos de laboratorio reales, lo que ralentiza el progreso de la I+D y erosiona la confianza de los investigadores.
- Los datos científicos seleccionados producen modelos notablemente mejores. Los hallazgos de CAS muestran aproximadamente el doble de precisión en las predicciones con la mitad de los datos de entrenamiento en estudios de unión fármaco-proteína, y una mejora de más del 30% en la predicción de rutas sintéticas cuando se utilizan mapeos atómicos verificados por científicos.
- La madurez sostenida de la IA depende de tres prácticas operativas que funcionan conjuntamente: gobernanza de datos, validación de flujos de trabajo y sostenibilidad de los datos.
La IA sigue ganando terreno en la I+D científica. Sin embargo, muchas organizaciones están descubriendo que los modelos en fase inicial funcionan de forma diferente cuando se aplican a la investigación en el mundo real. Los algoritmos que parecen fiables en evaluaciones controladas a menudo muestran un comportamiento inconsistente cuando se enfrentan a la variabilidad, las prácticas de documentación y la diversidad experimental características de los entornos de investigación activos. Esta discrepancia pone de relieve la necesidad de una mayor madurez de la IA en I+D.
Un factor importante que contribuye a la diferencia de comportamiento es la estructura de datos subyacente. Los resultados experimentales dependen de cómo se generaron las mediciones y de la forma en que se documentaron dichos resultados. Estos detalles varían ampliamente entre equipos, desde variaciones en la instrumentación y los protocolos hasta diferencias en las unidades, las convenciones de nomenclatura e incluso el nivel de detalle registrado en las notas de laboratorio. Además, muchos sistemas de IA entrenados con porciones de datos limitadas y estrechas no pueden interpretar variaciones inesperadas fuera de sus alcances iniciales y estáticos.Sin una preparación adecuada, las predicciones se vuelven inestables y fallan durante la validación en laboratorio. Estas inconsistencias se acumulan y crean una brecha entre el rendimiento del prototipo y el despliegue en el mundo real, lo que limita el impacto de los esfuerzos iniciales de IA y prepara el terreno para desafíos organizativos más profundos.
Por qué se estanca el progreso de la IA en la I+D científica
Estos desafíos reflejan una brecha de madurez más profunda, común en muchas organizaciones de I+D. Los modelos de IA iniciales funcionan bien en entornos de prueba controlados, pero una vez que encuentran datos de laboratorio reales o se despliegan en múltiples esfuerzos de investigación, el rendimiento disminuye y el progreso se ralentiza. Las grietas aparecen cuando los modelos se enfrentan a datos de entrada inconsistentes, carecen de la base contextual necesaria para interpretar los resultados o utilizan una infraestructura digital dividida que impide un flujo de datos fluido. Estos problemas revelan que el cuello de botella no es el modelo en sí, sino la preparación de los datos, los procesos y la infraestructura que lo rodean. Comprender dónde se produce este fallo ayuda a explicar por qué alcanzar la madurez de la IA en la I+D científica sigue siendo un desafío.
Las variaciones en los datos científicos producen resultados inexactos y poco fiables
«Basura entra, basura sale» es una frase conocida, pero en la I+D científica refleja un desafío estructural más profundo. Los resultados experimentales provienen de instrumentos, equipos de laboratorio y sistemas de documentación que siguen diferentes convenciones para el formato, la terminología y la captura de metadatos. Dos grupos pueden realizar el mismo ensayo, pero sus archivos de salida pueden diferir significativamente en estructura, unidades, detalle contextual e incluso prácticas de nomenclatura. Sin embargo, la inconsistencia estructural suele ser secundaria a un problema de mayor trascendencia: las condiciones experimentales en sí mismas (temperatura, calibración de instrumentos, tiempos, etc.) pueden alterar drásticamente los resultados, y estas variables a menudo están mal documentadas o se registran de forma inconsistente entre los equipos. Incluso cuando los valores numéricos parecen comparables, las condiciones que los producen pueden ser diferentes. Cuando los datos de entrenamiento arrastran estas inconsistencias, un modelo no puede distinguir de forma fiable la variación científica significativa de los artefactos de notificación. Los identificadores desalineados, los metadatos faltantes y los registros incompletos impiden que forme representaciones estables de la ciencia subyacente, produciendo así un modelo cuyos patrones aprendidos son inexactos y cuyos resultados no pueden ser de confianza.
Un segundo problema, igualmente grave, surge cuando se pone en uso un modelo entrenado. Incluso un modelo bien construido fallará si los datos que fluyen hacia él durante la aplicación en el mundo real se prepararon bajo supuestos diferentes a los de los datos de entrenamiento originales. Las diferencias en las unidades, los identificadores, el contexto experimental o la estructura de archivos entre los procesos de entrenamiento y de inferencia hacen que el modelo malinterprete las entradas, generando predicciones que no son fiables o que no se pueden utilizar. Por lo tanto, mantener la alineación entre los supuestos de los datos de entrenamiento y los flujos de datos del mundo real es un requisito continuo para cualquier solución de IA desplegada en entornos de I+D activos.
El razonamiento poco claro reduce la confianza en los resultados de la IA
La explicabilidad es otro factor importante para la adopción de la tecnología de IA. El uso de modelos de IA disminuye cuando el comportamiento del modelo no se alinea con lo que los investigadores o líderes esperan basándose en resultados de laboratorio establecidos. Los científicos confían en predicciones y resultados que pueden validarse mediante experimentos. Cuando una predicción no puede rastrearse hasta los datos estructurados (en general) o hasta una vía de razonamiento clara, la confianza en el sistema se erosiona. Sin claridad sobre por qué se realizó una predicción, los investigadores dudan en incorporarla a los experimentos en curso.
La incertidumbre se profundiza cuando el sistema no indica qué entradas influyeron en sus predicciones o resultados. Pequeñas diferencias en la configuración del ensayo, los atributos de la muestra o los descriptores moleculares pueden influir en los resultados. Sin visibilidad sobre qué informó la conclusión del modelo, los equipos no pueden evaluar cuándo el resultado es científicamente apropiado. Con el tiempo, estas brechas de explicabilidad limitan la adopción, dificultan la resolución de problemas y reducen la capacidad de la IA para apoyar o acelerar de forma fiable los programas de investigación activos.
La infraestructura fragmentada interrumpe la continuidad de los datos
Más allá de ser capaz de formar vías de razonamiento sólidas para conectar las predicciones con la entrada, surge otro desafío a partir de la infraestructura digital fragmentada. Muchos grupos de investigación dependen de software adoptado en diferentes etapas de su transición digital, lo que da como resultado que los datos y los algoritmos se dispersen en plataformas aisladas. Los registros experimentales pueden residir en un entorno, mientras que los resultados analíticos o las referencias propietarias se almacenan en otra ubicación.
Estas divisiones interrumpen la continuidad de los datos, lo que dificulta rastrear cómo un modelo generó sus resultados o cómo estos se relacionan con condiciones de laboratorio específicas. Cuando los sistemas no pueden intercambiar datos de forma fiable, los equipos se ven obligados a transferir información manualmente mediante la copia de archivos, la exportación de resultados o la reconstrucción de registros entre plataformas. Estas transferencias manuales aumentan el riesgo de errores y debilitan la confianza en las predicciones que dependen de la información trasladada a través de flujos de trabajo fragmentados. Con el tiempo, la falta de una integración integral limita la reproducibilidad, ralentiza la iteración y restringe la eficacia de la IA en los programas de investigación activos.
El marco del Triángulo del Éxito para I+D científica
Para abordar estos desafíos, CAS utiliza el Triángulo del Éxito como un marco de colaboración estructurado y adaptado a la I+D científica. Este modelo explica cómo la revisión científica coordinada, el diseño técnico intencional y la gestión estructurada del conocimiento crean las condiciones necesarias para un comportamiento estable del modelo. Al alinear la experiencia en estos tres pilares, las organizaciones pueden fortalecer sistemáticamente sus datos, su infraestructura y sus fundamentos científicos para acelerar su progreso hacia una mayor madurez en IA.
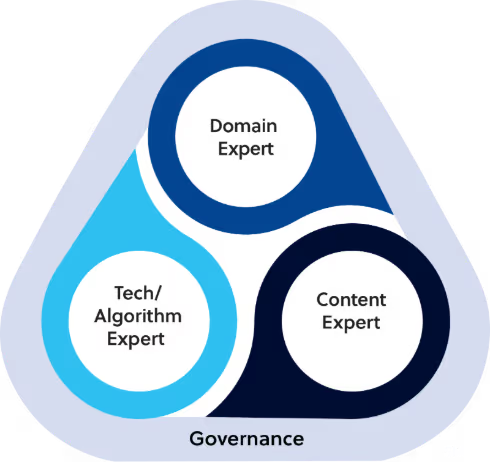
El Triángulo del Éxito se aplica en dos etapas críticas del ciclo de vida de la IA. La primera es la creación del modelo: garantizar que el problema de predicción se plantee de forma correcta y científica, que los datos de entrenamiento contengan el contexto y la calidad adecuados, y que el enfoque de IA sea el idóneo para el caso de uso. La segunda es la aplicación del modelo: una vez que el modelo ha sido entrenado y validado, el marco guía cómo se implementa en los flujos de trabajo de investigación reales, verificando que las suposiciones originales sigan siendo válidas, que los datos entrantes continúen cumpliendo las condiciones bajo las cuales se construyó el modelo y que los resultados sigan siendo fiables a medida que evolucionan los entornos de investigación. En conjunto, estas dos aplicaciones del marco garantizan que la capacidad de la IA se desarrolle y utilice con un propósito definido.
El marco destaca las contribuciones, distintas pero interdependientes, de cada grupo: los expertos en el dominio interpretan la variabilidad experimental, los expertos en contenido estandarizan y estabilizan los datos, y los expertos en tecnología unifican el ecosistema de infraestructura digital. Juntos, proporcionan la estabilidad y la base científica necesarias para que la IA influya de forma fiable en las decisiones de I+D.
Experto en el dominio
Los expertos en el dominio dentro de una organización aplican sus conocimientos científicos y su experiencia en investigación real para evaluar si un modelo de IA se comporta con precisión. Sus responsabilidades principales incluyen:
- Clarificar qué factores experimentales influyen en un resultado y cómo deben reflejarse en los datos.
- Establecer expectativas sobre lo que el modelo debe aprender y dónde se aplican las restricciones científicas.
- Comprobar si los resultados son coherentes con el conocimiento científico establecido, en lugar de ser artefactos presentes en los datos.
Experto en contenido
Los expertos en contenido, como los especialistas de CAS, garantizan que la información científica que ingresa en un sistema de IA sea precisa y esté verificada, y que cada dato refleje relaciones establecidas en lugar de registros inconsistentes o incompletos. Proporcionan orientación mediante:
- La preparación de conjuntos de datos que reflejen relaciones validadas en los campos de la química, la biología y la ciencia de materiales.
- La resolución de identificadores conflictivos, metadatos faltantes, terminología inconsistente u otros problemas que comprometan la estabilidad del modelo.
- La incorporación de contexto proveniente de fuentes científicas verificadas para que los datos de entrada representen lo que se observa en entornos de I+D reales.
- El mantenimiento de sistemas de contenido que preserven la procedencia y mantengan los conjuntos de datos alineados con el conocimiento científico actual a medida que el campo evoluciona.
Experto en tecnología y algoritmos
Los especialistas en tecnología y algoritmos crean la infraestructura que permite a los sistemas de IA funcionar de manera fiable en todos los programas de investigación. Apoyan el desarrollo de la IA mediante:
- La creación de sistemas que automatizan el movimiento de datos a través de procesos, eliminando la necesidad de trabajo manual y reduciendo las tasas de error.
- El seguimiento del comportamiento de los modelos cuando nuevos datos actualizan el sistema y el ajuste de los flujos de trabajo cuando el rendimiento cambia.
- Integración de predicciones en las herramientas de investigación existentes para que los equipos puedan utilizarlas durante la toma de decisiones rutinaria.
Por qué unos mejores datos conducen a mejores modelos predictivos
La madurez de la IA en I+D científica depende de la calidad y la consistencia de los datos utilizados para entrenar cada modelo. Cuando el Triángulo del Éxito se aplica en la práctica, su impacto es más visible en la calidad de los datos de entrenamiento y en el rendimiento resultante. Los datos de entrada seleccionados proporcionan a los modelos una visión más clara de las relaciones que deben aprender, reduciendo así el ruido que puede limitar su fiabilidad en entornos de investigación reales. Los hallazgos de CAS demuestran que unos cimientos de datos más sólidos producen un comportamiento del modelo más estable y preciso.
En un estudio de predicción de unión fármaco-proteína, los modelos entrenados con datos de CAS seleccionados por científicos ofrecieron aproximadamente el doble de precisión en la predicción utilizando un 50% menos de puntos de datos. Esta mejora redujo la necesidad de experimentos de seguimiento innecesarios y ayudó a los equipos a priorizar los candidatos de unión más plausibles en una fase más temprana de su flujo de trabajo.*
Una evaluación independiente de la predicción de rutas sintéticas mostró ganancias similares. Cuando se añadió al entrenamiento el mapeo de átomos verificado por científicos, la precisión de la ruta aumentó más de un 30%. Los mapeos verificados resolvieron ambigüedades estructurales que anteriormente habían desviado al modelo, lo que dio lugar a predicciones que se ajustaban mejor a las observaciones de laboratorio y requerían menos iteraciones correctivas.**
Estos hallazgos demuestran que los modelos de IA funcionan con mayor eficacia cuando se entrenan con datos científicos armonizados que han sido revisados por expertos. Lograr estas ganancias de forma constante requiere algo más que mejoras puntuales. Depende de prácticas operativas que refuercen la madurez a lo largo del tiempo.
Pasos operativos que refuerzan la madurez de la IA
La madurez de la IA aumenta cuando la estrategia de datos e IA de una organización empieza a fundamentar las decisiones cotidianas de I+D, desde cómo los equipos preparan los datos hasta cómo utilizan las predicciones de los modelos en sus proyectos. El progreso depende de la creación de sistemas que se adapten a las necesidades de investigación y mantengan un vínculo claro entre los datos que entran en un flujo de trabajo y las proyecciones que surgen de él.
Tres prácticas operativas ayudan a los equipos a pasar de los pilotos iniciales a flujos de trabajo basados en IA más maduros y fiables.
Gobernanza de datos
- Establece normas sobre cómo deben prepararse los datos antes de entrar en un flujo de trabajo
- Define comprobaciones que confirman si los datos de entrada y las predicciones cumplen las expectativas científicas
- Mantiene la documentación de los cambios en los conjuntos de datos, las actualizaciones de los modelos y los pasos de evaluación
- Asigna la responsabilidad de revisar los datos y aprobar las actualizaciones del flujo de trabajo
Validación del flujo de trabajo
- Almacena todos los pasos utilizados para generar una predicción, incluidos el preprocesamiento y la configuración del modelo, para que los resultados puedan rastrearse y repetirse
- Confirma la estabilidad mediante ejecuciones repetidas realizadas por diferentes equipos o en otros momentos
- Reúne al personal científico y técnico para revisar y resolver discrepancias
- Establece criterios claros sobre cuándo un flujo de trabajo es lo suficientemente estable como para respaldar proyectos adicionales
Sostenibilidad de los datos
- Incorpora datos nuevos y rigurosamente seleccionados mediante procesos de admisión controlados para mantener los modelos alineados con el conocimiento científico actual
- Aplica reglas estandarizadas de formato, metadatos y contexto a cada nuevo conjunto de datos antes de que se integre en un flujo de trabajo
- Utiliza métodos de generación aumentada por recuperación, lo que permite a los modelos consultar fuentes científicas actualizadas durante la inferencia
- Supervisa los cambios en los patrones o supuestos de los datos y actualiza los conjuntos de datos o modelos para evitar la degradación de la calidad de las predicciones
Cuando se mantienen la gobernanza de datos, la validación de flujos de trabajo y la sostenibilidad de los datos, la IA se vuelve más fiable y favorece el avance hacia una mayor madurez.
Cómo la madurez de la IA fortalece los flujos de trabajo y los resultados científicos
La madurez de la IA determina si las organizaciones científicas pueden confiar en los resultados de los modelos para tomar decisiones que definan experimentos e influyan en la dirección de los programas. Muchos equipos observan un rendimiento sólido en evaluaciones controladas, pero la fiabilidad disminuye cuando los modelos operan en entornos reales de I+D, donde la variación en las mediciones y las diferencias en los flujos de trabajo afectan al comportamiento.
El progreso hacia una mayor madurez depende del fortalecimiento de la base científica de cada modelo. Los expertos en la materia aclaran los supuestos de investigación y las restricciones científicas que el sistema debe seguir, garantizando que el razonamiento del modelo se alinee con el conocimiento establecido. Los responsables tecnológicos mantienen los entornos digitales que preservan la reproducibilidad, rastrean el linaje de los datos y mantienen la trazabilidad de los resultados a medida que los datos evolucionan. Los expertos en contenido proporcionan datos armonizados y verificados que reflejan el comportamiento real y eliminan las inconsistencias que desestabilizan el aprendizaje.
Cuando estas capacidades se alinean, los sistemas de IA funcionan de forma más coherente bajo escrutinio científico y pueden respaldar las decisiones cotidianas con mayor confianza.
Para saber cómo CAS puede apoyar los próximos pasos en su trayectoria con la IA, explore estos recursos de IA inteligente para la ciencia.
- - -
* Caso práctico de CAS que muestra el impacto de un contenido de alta calidad, seleccionado por científicos, en la precisión predictiva de la actividad biológica de un ligando frente a una diana proteica. Al utilizar contenido seleccionado por CAS en lugar de datos públicos ruidosos, el modelo duplicó su precisión predictiva utilizando un conjunto de datos de entrenamiento que era la mitad del tamaño del original.
** Caso práctico desarrollado en colaboración con Molecule.One. Un modelo de retrosíntesis entrenado con datos de reacciones públicas fue reentrenado utilizando datos de CAS, aprovechando los mapeos entre átomos de reactivos y productos seleccionados por científicos, los cuales son fundamentales para realizar predicciones químicas precisas. Con los datos de CAS, la predicción precisa de rutas sintéticas válidas aumentó un 30%, según la valoración de químicos sintéticos expertos.


