
Resumo executivo
- Muitos modelos de IA funcionam bem em testes controlados, mas falham ao serem aplicados a dados laboratoriais reais, atrasando o progresso de P&D e minando a confiança dos pesquisadores.
- Dados científicos curados produzem modelos comprovadamente melhores. As descobertas da CAS mostram aproximadamente o dobro da precisão de previsão com metade dos dados de treinamento em estudos de ligação droga-proteína, e uma melhoria de mais de 30% na previsão de vias sintéticas quando mapeamentos atômicos verificados por cientistas são utilizados.
- A maturidade sustentada em IA depende de três práticas operacionais trabalhando em conjunto: governança de dados, validação de fluxo de trabalho e sustentabilidade de dados.
A IA continua ganhando força em toda a P&D científica. No entanto, muitas organizações estão descobrindo que modelos em estágio inicial apresentam comportamentos diferentes quando aplicados a pesquisas do mundo real. Algoritmos que parecem confiáveis em avaliações controladas frequentemente exibem comportamento inconsistente ao enfrentar a variabilidade, as práticas de documentação e a diversidade experimental características de ambientes de pesquisa ativos. Essa discrepância destaca a necessidade de maior maturidade em IA na P&D.
Um dos principais fatores para essa diferença de comportamento é a estrutura de dados subjacente. Os resultados experimentais dependem de como as medições foram geradas e da forma como esses resultados foram documentados. Esses detalhes variam amplamente entre as equipes, desde variações em instrumentação e protocolos até diferenças em unidades, convenções de nomenclatura e até mesmo o nível de detalhe registrado nas anotações de laboratório. Além disso, muitos sistemas de IA treinados em fatias de dados limitadas e restritas não conseguem interpretar variações inesperadas fora de seus escopos iniciais e estáticos.Sem a preparação adequada, as previsões tornam-se instáveis e falham durante a validação laboratorial. Essas inconsistências se acumulam e criam uma lacuna entre o desempenho do protótipo e a implementação no mundo real, limitando o impacto dos esforços iniciais de IA e preparando o terreno para desafios organizacionais mais profundos.
Por que o progresso da IA estagna na P&D científica
Esses desafios refletem uma lacuna de maturidade mais profunda, comum em muitas organizações de P&D. Os modelos iniciais de IA funcionam bem em ambientes de teste controlados, mas, ao encontrarem dados laboratoriais reais ou serem implantados em vários projetos de pesquisa, o desempenho cai e o progresso desacelera. Falhas surgem quando os modelos enfrentam dados de entrada inconsistentes, carecem da base contextual necessária para interpretar resultados ou utilizam uma infraestrutura digital dividida que impede o fluxo contínuo de dados. Essas questões revelam que o gargalo não é o modelo em si, mas a prontidão dos dados, processos e infraestrutura ao seu redor. Entender onde ocorre essa falha ajuda a explicar por que alcançar a maturidade em IA na P&D científica continua sendo um desafio.
Variações nos dados científicos produzem resultados imprecisos e pouco confiáveis
“Lixo entra, lixo sai” é uma frase conhecida, mas na P&D científica ela reflete um desafio estrutural mais profundo. Os resultados experimentais originam-se de instrumentos, equipes de laboratório e sistemas de documentação que seguem convenções diferentes para formatação, terminologia e captura de metadados. Dois grupos podem realizar o mesmo ensaio, mas seus arquivos de saída podem diferir significativamente em estrutura, unidades, detalhes contextuais e até mesmo em práticas de nomenclatura. No entanto, a inconsistência estrutural é frequentemente secundária a um problema mais consequente: as próprias condições experimentais (temperatura, calibração de instrumentos, tempo, etc.) podem alterar drasticamente os resultados, e essas variáveis são frequentemente subdocumentadas ou registradas de forma inconsistente entre as equipes. Mesmo quando os valores numéricos parecem comparáveis, as condições que os produzem podem ser diferentes. Quando os dados de treinamento carregam essas inconsistências, um modelo não consegue distinguir de forma confiável a variação científica significativa dos artefatos de registro. Identificadores desalinhados, metadados ausentes e registros incompletos impedem que ele forme representações estáveis da ciência subjacente, produzindo assim um modelo cujos padrões aprendidos são imprecisos e cujas saídas não podem ser confiáveis.
Um segundo problema, igualmente grave, surge quando um modelo treinado é colocado em uso. Mesmo um modelo bem construído falhará se os dados que fluem para ele durante a aplicação no mundo real tiverem sido preparados sob premissas diferentes das do treinamento original. Diferenças em unidades, identificadores, contexto experimental ou estrutura de arquivo entre os pipelines de treinamento e de inferência fazem com que o modelo interprete mal as entradas, gerando previsões que não são confiáveis ou utilizáveis. Manter o alinhamento entre as premissas dos dados de treinamento e os pipelines de dados do mundo real é, portanto, um requisito contínuo para qualquer solução de IA implantada em ambientes de P&D ativos.
O raciocínio pouco claro reduz a confiança nas saídas da IA
A explicabilidade é outro fator importante para a adoção da tecnologia de IA. O uso de modelos de IA diminui quando o comportamento do modelo não se alinha ao que pesquisadores ou líderes esperam com base em resultados laboratoriais estabelecidos. Os cientistas confiam em previsões e resultados que podem ser validados por meio de experimentos. Quando uma previsão não pode ser rastreada até os dados estruturados (em geral) ou a um caminho de raciocínio claro, a confiança no sistema diminui. Sem clareza sobre o motivo pelo qual uma previsão foi feita, os pesquisadores hesitam em incorporá-la em experimentos em andamento.
A incerteza aumenta quando o sistema não indica quais entradas influenciaram suas previsões/resultados. Pequenas diferenças na configuração do ensaio, atributos da amostra ou descritores moleculares podem influenciar os resultados. Sem visibilidade sobre o que fundamentou a conclusão do modelo, as equipes não conseguem avaliar quando o resultado é cientificamente apropriado. Com o tempo, essas lacunas de explicabilidade limitam a adoção, dificultam a solução de problemas e reduzem a capacidade da IA de apoiar ou acelerar programas de pesquisa ativos de forma confiável.
A infraestrutura fragmentada interrompe a continuidade dos dados
Além de ser capaz de formar caminhos de raciocínio sólidos para conectar previsões à entrada, outro desafio surge da infraestrutura digital fragmentada. Muitos grupos de pesquisa dependem de softwares adotados em diferentes estágios de sua transição digital, resultando em dados e algoritmos espalhados por plataformas isoladas. Registros experimentais podem residir em um ambiente, enquanto resultados analíticos ou referências proprietárias são armazenados em outro local.
Essas divisões interrompem a continuidade dos dados, dificultando o rastreamento de como um modelo gerou seu resultado ou como esse resultado se relaciona com condições laboratoriais específicas. Quando os sistemas não conseguem trocar dados de forma confiável, as equipes são forçadas a transferir informações manualmente, copiando arquivos, exportando resultados ou reconstruindo registros entre plataformas. Essas transferências manuais aumentam o risco de erros e enfraquecem a confiança em previsões que dependem de informações movidas por fluxos de trabalho fragmentados. Com o tempo, a falta de integração de ponta a ponta limita a reprodutibilidade, retarda a iteração e restringe a eficácia da IA em programas de pesquisa ativos.
O framework Triângulo do Sucesso para P&D científico
Para enfrentar esses desafios, a CAS utiliza o Triângulo do Sucesso como um framework de parceria estruturado, adaptado para P&D científico. Este modelo explica como a revisão científica coordenada, o design técnico intencional e a gestão de conhecimento estruturada criam as condições necessárias para um comportamento estável do modelo. Ao alinhar a expertise nesses três pilares, as organizações podem fortalecer sistematicamente seus dados, infraestrutura e fundamentos científicos para acelerar seu progresso rumo a uma maior maturidade em IA.
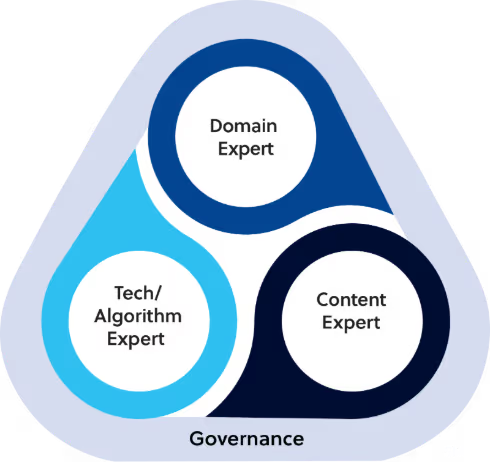
O Triângulo do Sucesso aplica-se a duas etapas críticas do ciclo de vida da IA. A primeira é a criação do modelo: garantir que o problema de previsão seja estruturado de forma correta e científica, que os dados de treinamento carreguem o contexto e a qualidade adequados e que a abordagem de IA seja bem compatível com o caso de uso. A segunda é a aplicação do modelo: uma vez que um modelo tenha sido treinado e validado, o framework orienta como ele é implantado em fluxos de trabalho de pesquisa do mundo real, verificando se as premissas originais ainda se sustentam, se os dados recebidos continuam a atender às condições nas quais o modelo foi construído e se os resultados permanecem confiáveis à medida que os ambientes de pesquisa evoluem. Juntas, essas duas aplicações do framework garantem que a capacidade de IA seja construída e utilizada com um propósito.
O framework destaca as contribuições distintas, porém interdependentes, de cada grupo: especialistas no domínio interpretam a variabilidade experimental, especialistas em conteúdo padronizam e estabilizam os dados, e especialistas em tecnologia unificam o ecossistema de infraestrutura digital. Juntos, eles fornecem a estabilidade e a base científica necessárias para que a IA influencie de forma confiável as decisões de P&D.
Especialista no domínio
Especialistas no domínio dentro de uma organização aplicam conhecimento científico e experiência de pesquisa no mundo real para avaliar se um modelo de IA se comporta com precisão. As principais responsabilidades incluem:
- Esclarecer quais fatores experimentais influenciam um resultado e como eles devem ser refletidos nos dados.
- Definir expectativas sobre o que o modelo deve aprender e onde as restrições científicas se aplicam.
- Verificar se os resultados são consistentes com o entendimento científico estabelecido, em vez de artefatos nos dados.
Especialista em conteúdo
Especialistas em conteúdo, como os especialistas da CAS, garantem que as informações científicas que entram em um sistema de IA sejam precisas e verificadas, e que cada entrada reflita relações estabelecidas em vez de registros inconsistentes ou incompletos. Eles fornecem orientação ao:
- Preparar conjuntos de dados que reflitam relações validadas abrangendo química, biologia e ciência dos materiais.
- Resolver identificadores conflitantes, metadados ausentes, terminologia inconsistente ou outros problemas que comprometam a estabilidade do modelo.
- Adicionar contexto de fontes científicas verificadas para que os dados de entrada representem o que é observado em ambientes reais de P&D.
- Manter sistemas de conteúdo que preservem a procedência e mantenham os conjuntos de dados alinhados com o conhecimento científico atual à medida que o campo evolui.
Especialista em tecnologia e algoritmos
Especialistas em tecnologia e algoritmos criam infraestrutura que permite que os sistemas de IA funcionem de forma confiável em programas de pesquisa. Eles apoiam o desenvolvimento de IA ao:
- Construir sistemas que automatizam o movimento de dados através de pipelines, eliminando a necessidade de trabalho manual e reduzindo as taxas de erro.
- Monitorar como os modelos se comportam quando novos dados atualizam o sistema e ajustar os fluxos de trabalho quando o desempenho muda.
- Integrar previsões a ferramentas de pesquisa existentes para que as equipes possam utilizá-las durante a tomada de decisão rotineira.
Por que dados melhores levam a modelos preditivos melhores
A maturidade da IA em P&D científico depende da qualidade e da consistência dos dados usados para treinar cada modelo. Quando o Triângulo do Sucesso é aplicado na prática, seu impacto é mais visível na qualidade dos dados de treinamento e no desempenho resultante. Entradas curadas fornecem aos modelos uma visão mais clara das relações que eles devem aprender, reduzindo assim o ruído que pode limitar sua confiabilidade em ambientes de pesquisa do mundo real. As descobertas do CAS demonstram que bases de dados mais sólidas produzem um comportamento de modelo mais estável e preciso.
Em um estudo de previsão de ligação fármaco-proteína, modelos treinados com dados do CAS curados por cientistas entregaram aproximadamente o dobro da precisão de previsão usando 50% menos pontos de dados. Essa melhoria reduziu o acompanhamento experimental desnecessário e ajudou as equipes a priorizar os candidatos a ligação mais plausíveis logo no início de seu fluxo de trabalho.*
Uma avaliação separada da previsão de rotas sintéticas mostrou ganhos semelhantes. Quando o mapeamento de átomos verificado por cientistas foi adicionado aos dados de treinamento, a precisão da rota aumentou em mais de 30%. Os mapeamentos verificados resolveram ambiguidades estruturais que anteriormente desviavam o modelo, levando a previsões que correspondiam mais fielmente às observações laboratoriais e exigiam menos iterações corretivas.**
Essas descobertas demonstram que os modelos de IA têm um desempenho mais eficaz quando treinados com dados científicos harmonizados que foram revisados por especialistas. Alcançar esses ganhos de forma consistente exige mais do que melhorias pontuais. Depende de práticas operacionais que reforcem a maturidade ao longo do tempo.
Passos operacionais que fortalecem a maturidade da IA
A maturidade da IA aumenta quando a estratégia de dados e IA de uma organização começa a fundamentar as decisões diárias de P&D, desde como as equipes preparam os dados até como usam as previsões dos modelos em projetos. O progresso depende da construção de sistemas que se adaptem às necessidades de pesquisa e mantenham um vínculo claro entre os dados que entram em um fluxo de trabalho e as projeções que emergem dele.
Três práticas operacionais ajudam as equipes a passar de pilotos iniciais para fluxos de trabalho habilitados por IA mais maduros e confiáveis.
Governança de dados
- Estabelece regras sobre como os dados devem ser preparados antes de entrar em um fluxo de trabalho
- Define verificações que confirmam se as entradas e previsões atendem às expectativas científicas
- Mantém a documentação de alterações em conjuntos de dados, atualizações de modelos e etapas de avaliação
- Atribui responsabilidade pela revisão de dados e aprovação de atualizações de fluxo de trabalho
Validação de fluxo de trabalho
- Armazena todas as etapas usadas para gerar uma previsão, incluindo pré-processamento e configurações de modelo, para que os resultados possam ser rastreados e repetidos
- Confirma a estabilidade por meio de execuções repetidas realizadas por diferentes equipes ou em momentos distintos
- Reúne equipes científicas e técnicas para revisar e resolver discrepâncias
- Define critérios claros para quando um fluxo de trabalho está estável o suficiente para apoiar projetos adicionais
Sustentabilidade de dados
- Adiciona dados novos e bem selecionados por meio de processos de entrada controlados para manter os modelos alinhados ao conhecimento científico atual
- Aplica formatação, metadados e regras de contexto padronizados a cada novo conjunto de dados antes que ele entre em um fluxo de trabalho
- Usa métodos de recuperação aumentada, permitindo que os modelos consultem fontes científicas atualizadas durante a inferência
- Monitora mudanças em padrões ou premissas de dados e atualiza conjuntos de dados ou modelos para evitar a queda na qualidade das previsões
Quando a governança de dados, a validação de fluxo de trabalho e a sustentabilidade dos dados são mantidas, a IA torna-se mais confiável e apoia o avanço rumo a uma maior maturidade.
Como a maturidade da IA fortalece os fluxos de trabalho e os resultados científicos
A maturidade da IA determina se as organizações científicas podem confiar nos resultados dos modelos para decisões que moldam experimentos e influenciam a direção de programas. Muitas equipes observam um bom desempenho em avaliações controladas, mas a confiabilidade cai quando os modelos operam em ambientes reais de P&D, onde a variação de medição e as diferenças nos fluxos de trabalho afetam o comportamento.
O progresso rumo a uma maior maturidade depende do fortalecimento da base científica sob cada modelo. Especialistas no domínio esclarecem as premissas de pesquisa e as restrições científicas que o sistema deve seguir, garantindo que o raciocínio do modelo esteja alinhado ao conhecimento estabelecido. Líderes de tecnologia mantêm os ambientes digitais que preservam a reprodutibilidade, rastreiam a linhagem dos dados e mantêm os resultados rastreáveis conforme os dados evoluem. Especialistas em conteúdo fornecem entradas harmonizadas e verificadas que refletem o comportamento no mundo real e eliminam inconsistências que desestabilizam o aprendizado.
Quando essas capacidades se alinham, os sistemas de IA apresentam um desempenho mais consistente sob escrutínio científico e podem apoiar decisões cotidianas com maior confiança.
Para saber como a CAS pode apoiar as próximas etapas da sua jornada de IA, explore estes recursos de IA com inteligência científica.
- - -
* Estudo de caso da CAS demonstrando o impacto de conteúdo de alta qualidade, selecionado por cientistas, na precisão preditiva da atividade biológica de um ligante contra um alvo proteico. Ao usar conteúdo selecionado pela CAS em vez de dados públicos ruidosos, o modelo aumentou em 2x a precisão da previsão, utilizando um conjunto de dados de treinamento com metade do tamanho do original.
** Estudo de caso desenvolvido em colaboração com a Molecule.One. Um modelo de retrossíntese treinado com dados de reações públicas foi retreinado usando dados da CAS, aproveitando os mapeamentos entre átomos de reagentes e produtos selecionados por cientistas, que são cruciais para previsões químicas precisas. Com os dados da CAS, a previsão precisa de rotas sintéticas válidas aumentou em 30%, conforme avaliado por químicos sintéticos especialistas.


