
执行摘要
- 许多 AI 模型在受控测试中表现良好,但在应用于真实的实验室数据时却会失效,从而拖慢研发进度并削弱研究人员的信任。
- 经过整理的科学数据能产生显著更优的模型。CAS 的研究结果表明,在药物-蛋白质结合研究中,使用经科学家验证的原子映射,训练数据减半即可获得约两倍的预测准确度,且合成路径预测的准确性提高了 30% 以上。
- 持续的 AI 成熟度取决于三项协同运作的运营实践:数据治理、工作流验证和数据可持续性。
AI 在科学研发领域持续获得关注。然而,许多机构发现,早期阶段的模型在应用于现实研究时表现各异。在受控评估中看似可靠的算法,在面对活跃研究环境中特有的多变性、记录习惯和实验多样性时,往往表现出不一致的行为。这种差异凸显了研发领域提升 AI 成熟度的必要性。
导致行为差异的一个主要因素是底层数据结构。实验结果取决于测量数据的生成方式以及结果的记录方式。这些细节在不同团队间差异巨大,从仪器和协议的变化,到单位、命名规范甚至实验记录中细节程度的不同,不一而足。此外,许多在有限、狭窄的数据切片上训练的 AI 系统,无法解读超出其初始静态范围的意外变化。若缺乏适当的准备,预测结果就会变得不稳定,并在实验室验证阶段失效。这些不一致性不断累积,在原型性能与实际部署之间造成了鸿沟,限制了早期 AI 工作的成效,并为更深层次的组织挑战埋下了隐患。
为何 AI 在科学研发中的进展停滞不前
这些挑战反映了许多研发机构普遍存在的更深层次的成熟度差距。早期的 AI 模型在受控测试环境中表现良好,但一旦遇到真实的实验室数据或在多个研究项目中部署,性能就会下降,进展也会放缓。当模型面临不一致的输入数据、缺乏解读结果所需的背景依据,或使用导致数据无法顺畅流动的割裂数字基础设施时,问题便会显现。这些问题表明,瓶颈不在于模型本身,而在于周边数据、流程和基础设施的就绪程度。了解这种失效发生的位置,有助于解释为何在科学研发中实现 AI 成熟度依然困难重重。
科学数据的差异导致结果不准确且不可信
“垃圾进,垃圾出”是一个耳熟能详的短语,但在科学研发中,它反映了一个更深层的结构性挑战。实验结果源自遵循不同格式、术语和元数据捕获规范的仪器、实验室团队和文档系统。两个小组可能进行相同的化验,但其输出文件的结构、单位、背景细节甚至命名习惯可能存在显著差异。然而,结构上的不一致往往次于一个更严重的问题:实验条件本身(温度、仪器校准、时间等)可能会剧烈改变结果,而这些变量往往记录不足或在团队间记录不一致。即使数值看起来相当,产生这些数值的条件也可能不同。当训练数据带有这些不一致性时,模型无法可靠地将有意义的科学变异与报告误差区分开来。不匹配的标识符、缺失的元数据和不完整的记录,阻碍了模型形成对底层科学的稳定表征,从而导致模型学习到的模式不准确,其输出结果也无法被信任。
当训练好的模型投入使用时,会出现第二个同样严重的问题。即使是一个构建良好的模型,如果其在现实应用中输入的数据是基于与原始训练数据不同的假设准备的,也会失效。训练管道与推理管道之间在单位、标识符、实验背景或文件结构上的差异,会导致模型误解输入内容,从而产生不可靠或无法使用的预测结果。因此,保持训练数据假设与现实数据管道之间的一致性,是任何在活跃研发环境中部署的 AI 解决方案必须持续进行的工作。
推理过程不透明降低了对 AI 输出的信任
可解释性是影响 AI 技术采用的另一个重要因素。当模型行为与研究人员或领导者基于既定实验室结果的预期不符时,AI 模型的使用率就会下降。科学家依赖于可以通过实验验证的预测和输出。当预测结果无法追溯到结构化数据(总体而言)或清晰的推理路径时,对系统的信任就会减弱。由于不清楚预测结果是如何得出的,研究人员会犹豫是否将其纳入正在进行的研究中。
当系统无法指出哪些输入影响了其预测或结果时,这种不确定性会加剧。化验设置、样本属性或分子描述符的细微差异都可能影响结果。如果无法洞察模型结论的依据,团队就无法评估输出结果在科学上是否合理。随着时间的推移,这些可解释性方面的差距限制了 AI 的采用,阻碍了故障排查,并降低了 AI 可靠支持或加速活跃研究项目的能力。
碎片化的基础设施中断了数据连续性
除了需要建立可靠的推理路径来连接预测与输入之外,另一个挑战源于碎片化的数字基础设施。许多研究小组依赖于在数字化转型不同阶段采用的软件,导致数据和算法分散在孤立的平台中。实验记录可能存在于一个环境中,而分析输出或专有参考资料则存储在另一个位置。
这些割裂导致数据连续性中断,使得追踪模型如何生成输出,或输出如何与特定实验室条件相关联变得困难。当系统无法可靠地交换数据时,团队被迫通过复制文件、导出结果或在不同平台间重建记录来手动传输信息。这些手动传输增加了出错风险,并削弱了对依赖于碎片化工作流所传输信息的预测结果的信心。长此以往,缺乏端到端的集成会限制可重复性,减缓迭代速度,并制约人工智能在活跃研究项目中的效能。
科学研发的“成功三角”框架
为应对这些挑战,CAS 采用了“成功三角”作为专为科学研发量身定制的结构化合作伙伴框架。该模型阐述了协调的科学审查、有目的的技术设计以及结构化的知识管理如何共同创造模型稳定运行所需的条件。通过整合这三大支柱的专业能力,组织能够系统性地强化其数据、基础设施和科学基础,从而加速迈向更高的人工智能成熟度。
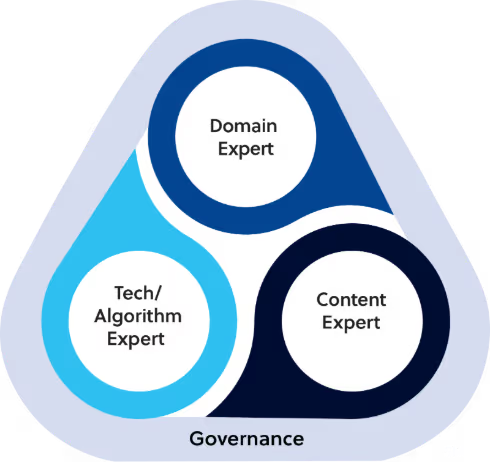
“成功三角”适用于人工智能生命周期的两个关键阶段。第一阶段是模型创建:确保预测问题在科学层面得到正确界定,训练数据具备适当的背景与质量,且人工智能方法与应用场景高度匹配。第二阶段是模型应用:模型经过训练和验证后,该框架通过核实原始假设是否依然成立、输入数据是否持续符合模型构建时的条件,以及输出结果在研究环境演变过程中是否依然可信,来指导模型如何部署到实际的研究工作流中。这两个阶段的结合,确保了人工智能能力的构建与应用均有的放矢。
该框架强调了各团队独特且相互依存的贡献:领域专家负责解读实验变异性,内容专家负责标准化和稳定数据,技术专家负责统一数字基础设施生态系统。他们共同为人工智能可靠地影响研发决策提供了稳定性和科学基础。
领域专家
组织内的领域专家运用科学知识和实际研究经验,评估人工智能模型的行为是否准确。其核心职责包括:
- 明确哪些实验因素会影响结果,以及这些因素应如何在数据中体现。
- 设定模型应学习的内容预期,以及科学约束适用的范围。
- 核查输出结果是否符合既定的科学认知,而非数据中的人为偏差。
内容专家
内容专家(如 CAS 的专家团队)确保进入人工智能系统的科学信息准确且经过验证,并确保每一项输入都反映了既定的科学关系,而非不一致或不完整的记录。他们通过以下方式提供指导:
- 准备能够反映化学、生物学和材料科学领域已验证关系的数据集。
- 解决冲突的标识符、缺失的元数据、不一致的术语或其他削弱模型稳定性的问题。
- 从经过验证的科学来源中添加背景信息,使输入数据能够代表实际研发环境中的观察结果。
- 维护内容系统,以确保数据来源的可追溯性,并随着科学领域的发展保持数据集与当前科学知识的一致性。
技术与算法专家
技术与算法专家负责构建基础设施,使人工智能系统能够在各项研究项目中可靠运行。他们通过以下方式支持人工智能开发:
- 构建能够实现数据流自动化传输的系统,消除手动操作需求并降低错误率。
- 监控模型在系统更新新数据时的表现,并在性能发生变化时调整工作流。
- 将预测结果整合到现有的研究工具中,以便团队能够在日常决策过程中使用这些预测。
为何更优质的数据能带来更出色的预测模型
科学研发领域的 AI 成熟度取决于训练模型所用数据的质量与一致性。当“成功三角”理论应用于实践时,其影响最直观地体现在训练数据的质量及随之而来的模型性能上。经过精选的输入数据能让模型更清晰地洞察其需要学习的关联性,从而减少可能限制其在实际研究场景中可靠性的干扰因素。CAS 的研究结果表明,更扎实的数据基础能带来更稳定、更准确的模型表现。
在一项药物-蛋白质结合预测研究中,基于科学家精选的 CAS 数据训练的模型,其预测准确率提高了约一倍,而使用的数据点却减少了 50%。这一改进减少了不必要的后续实验,并帮助团队在工作流程的早期阶段优先筛选出最可行的结合候选物。*
对合成路径预测的独立评估也显示出类似的成效。 当训练数据中加入经科学家验证的原子映射时, 路径准确率提升了超过 30%。 经过验证的映射解决了此前导致模型误判的结构歧义,使预测结果更贴近实验室观察,并减少了所需的修正迭代次数。**
这些发现表明,当 AI 模型使用经过专家评审的标准化科学数据进行训练时,其表现会更加有效。要持续获得这些收益,需要的不仅仅是一次性的改进,而是依赖于能够随时间推移不断强化成熟度的运营实践。
强化 AI 成熟度的运营步骤
当组织的 AI 和数据战略开始为日常研发决策提供指导时,AI 成熟度便会提升,这涵盖了从团队准备数据的方式到他们在项目中应用模型预测的方式。进步取决于构建能够适应研究需求,并保持工作流程输入数据与输出预测之间清晰关联的系统。
三种运营实践有助于团队从早期的试点项目转向更成熟、更可靠的 AI 赋能工作流程。
数据治理
- 制定数据在进入工作流程前的准备规则
- 定义检查机制,以确认输入数据和预测结果是否符合科学预期
- 维护数据集变更、模型更新及评估步骤的文档记录
- 明确数据审查和工作流程更新的审批责任人
工作流程验证
- 存储生成预测的所有步骤,包括预处理和模型设置,以确保结果可追溯、可重复
- 通过不同团队或在不同时间进行的重复运行来确认稳定性
- 组织科学与技术人员共同审查并解决差异
- 设定明确的标准,以判断工作流程是否足够稳定,从而支持更多项目
数据可持续性
- 通过受控的摄入流程添加经过精心筛选的新数据,确保模型与最新的科学知识保持同步
- 在每个新数据集进入工作流之前,对其应用标准化的格式、元数据和上下文规则
- 采用检索增强方法,使模型能够在推理过程中参考最新的科学来源
- 监测数据模式或假设的变化,并更新数据集或模型,以防止预测质量下降
当数据治理、工作流验证和数据可持续性在整个工作流中得到维护时,人工智能将变得更加可靠,并支持向更高的成熟度迈进。
人工智能成熟度如何增强科学工作流与成果
人工智能成熟度决定了科研机构能否依赖模型输出来制定影响实验和项目方向的决策。许多团队在受控评估中表现出色,但一旦模型进入测量差异和工作流差异会影响其行为的实际研发环境,其可靠性就会下降。
向更高成熟度迈进,取决于加强每个模型背后的科学基础。领域专家明确系统必须遵循的研究假设和科学约束,确保模型的推理符合既定知识。技术负责人维护数字环境,以保持可重复性、追踪数据血缘并确保数据演变时输出的可追溯性。内容专家提供经过协调和验证的输入,这些输入反映了真实世界的行为,并消除了破坏学习稳定性的不一致性。
当这些能力保持一致时,人工智能系统在科学审查下表现得更加稳定,并能更自信地支持日常决策。
如需了解 CAS 如何为您的人工智能之旅提供支持,请探索 这些科学智能人工智能资源。
- - -
* CAS 案例研究展示了高质量、经科学家策划的内容对配体针对蛋白质靶点的生物活性预测准确性的影响。通过使用 CAS 策划的内容而非嘈杂的公共数据,该模型在训练数据集仅为原始数据一半的情况下,预测准确率提高了 2 倍。
** 与 Molecule.One 合作开发的案例研究。一个基于公共反应数据训练的逆合成模型使用 CAS 数据进行了重新训练,利用了对准确化学预测至关重要的反应物和产物原子之间经科学家策划的映射。使用 CAS 数据后,经合成化学专家评估,有效合成路线的准确预测率提高了 30%。


