

科学的発見は、常に良質でクリーンなデータに支えられてきました。不正確なデータは、再現性のない結果や問題のある解決策を招き、最終的にはデータの再取得という手戻りを発生させます。AIを活用した予測モデルが初期創薬ワークフローで一般的になるにつれ、研究ワークフロー全体を通じて正確かつ一貫性のあるデータの重要性はかつてないほど高まっています。
現代の創薬において、乱雑なデータは依然として根深い課題であり、科学者はエンティティ命名の不一致の解消、データベース形式の不整合の修正、エラーの訂正に多大な時間を費やしています。機械は、曖昧さや不整合を解釈するために必要な文脈的理解が欠けているため、複雑なデータセットのニュアンスを扱うのに苦労します。そのため、テクノロジーでは十分に対処できないデータに潜む問題を特定し、修正するという作業が、頻繁に人間の科学者に委ねられています。
創薬チームにとって、乱雑なデータは波及効果を生み、研究者が誤った前提や不完全な情報に基づいて実験を設計したりモデルを構築したりする原因となり、最終的には貴重なリソースを浪費することになります。ここで、データクレンジングとデータハーモナイゼーションという補完的なプロセスが、ワークフローを最適化する上で極めて重要な役割を果たします。それぞれが、相互に関連しながらも異なる課題に対処します。
- データクレンジング:専門家がエラーを特定・修正し、欠損値を補完し、無関係な情報を削除することで、個々のデータセット内の正確性と信頼性を確保するプロセス
- データハーモナイゼーション:複数のソースからの情報を人間が統合し、標準化して一貫性のあるフレームワークに統一することで、シームレスな分析、比較可能性、コラボレーションを可能にするプロセス
クレンジングとハーモナイゼーションを成功させる鍵は、人間によるキュレーションにあります。
重要な第一歩、データクレンジング
科学者がデータをハーモナイズ(統合)するには、その前にクレンジングを行う必要があります。データ入力、計算ミス、センサーの誤作動、システム障害に起因するエラーを排除することで、科学者はハーモナイゼーションに必要なデータの基盤を構築できます。適切にクレンジングされたデータに依存するチームは、以下のメリットを得られます。
- 精度の向上、データから導き出される知見の信頼性と再現性を確保し、質の高い創薬候補の創出につなげます。
- 効率の向上、エラーによるトラブルシューティングや分析のやり直しに費やす時間を削減します。
- コラボレーションの強化、 データセット間の不一致を解消することで、チーム間、機関間、業界間での連携を円滑にします。
- 予測能力の洗練、クリーンなデータを活用して、薬物と標的の相互作用や疾患との関連性などを正確に予測できる予測モデルの基盤を構築します。
適切なデータクレンジングを伴わないハーモナイゼーションは、流砂の上に建物を建てるようなものであり、脆弱で持続不可能です。科学者がデータをクレンジングすることで、最も関連性が高く信頼できる情報のみが後続のプロセスに組み込まれるようになり、研究環境の正確な把握と強固なデータ基盤が実現します。
データハーモナイゼーションを成功させるための構造的アプローチ
データハーモナイゼーション(図1)は、権威ある構成要素(オーソリティ・コンストラクト)と命名基準を確立することから始まります。例えば、この緻密な作業により、創薬における標的同定を目的として、タンパク質などのエンティティがすべてのソースおよびデータセット間で統一された名称と分類で扱われるようになります。
ハーモナイゼーションの次のフェーズは物質の紐付け(サブスタンス・リンキング)です。ここでは、科学者が異なるデータセットやデータベース間で同一の化学物質への参照を特定し、接続します。このプロセスにより、異なる物質の表現、同義語、識別子が単一の一貫したエンティティに統合されます。この取り組みは、ソースごとに異なる慣習が用いられ、同じ化合物が異なる方法で記述されることが多い薬理学および創薬において不可欠です。
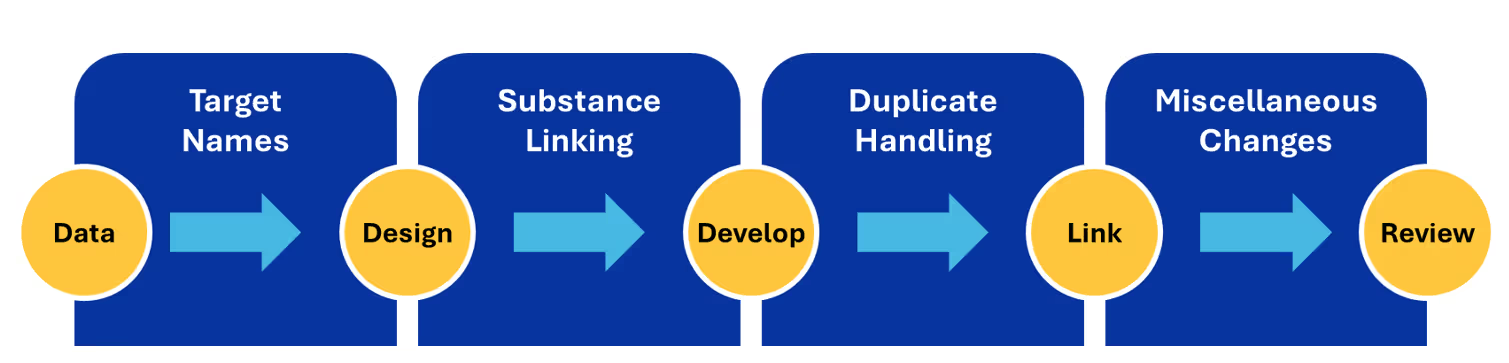
ハーモナイゼーション(統合)プロセスの過程で、データサイエンティストは同一または関連する文書を特定・管理し、データの重複を防ぐことで、最も関連性の高い情報のみを確実に保持します。最終段階では、データセット間でのデータ定義の整合性を確保することに重点を置きます。これは、複数のソースからのデータで構成される強固な基盤を構築するために不可欠です。
創薬チームは、専門家によるキュレーションに基づいたハーモナイゼーションのワークフローを導入することで、複雑なデータ環境を確実に把握できます。その結果、高度な分析や予測モデリングに適した信頼性の高いデータセットが得られます。この体系的なアプローチによりエラーが最小限に抑えられ、その後のあらゆる研究が、クリーンで強固なデータ基盤の上に構築されるようになります。
ハーモナイズされたデータが予測モデルの精度を向上させる
データハーモナイゼーションの最も具体的な利点の一つは、予測モデルへの影響です。予測精度へのプラスの効果を実証するため、CASの科学者は、新たにハーモナイズされたデータセットを使用して、リガンドとターゲットのペアの活性を予測する既存のアンサンブルモデルを再学習させました。
再学習されたモデルは大幅な精度の向上を示し、予測値と実験値の標準偏差は23%減少し、リガンドとターゲットの相互作用における予測値と実験値の乖離は56%減少しました(図2)。ターゲット名の正規化と物質のリンク付けの改善により、科学者は物質とターゲットの関係をより一貫性を持って正確に記述できるようデータを強化しました。

この予測モデリングは、モデルの性能を洗練させる上で、専門家によるデータハーモナイゼーションがいかに不可欠であるかを強調しています。スクリーニングの初期段階で有望な候補を特定し注力することで、チームはヒット・トゥ・リードのフェーズを迅速に進め、開発や試験へと移行することが可能になります。
ハーモナイズされたデータが高度な分析を促進する
データハーモナイゼーションは、予測モデルだけでなく、革新的な創薬ワークフローを推進するナレッジグラフや相互作用ネットワークといった高度な分析ツールも最適化します(図3)。これらのツールは、研究者がターゲット、物質、生物学的経路の関係を探索し、疾患との関連性や新しい治療モダリティを特定するのに役立ちます。


専門家がキュレーションした統一的なデータ基盤により、科学者は遺伝子発現、タンパク質相互作用、代謝経路など、さまざまな生物学的レベルにわたる複雑な相互作用を追跡できます。これにより、断片化されたデータソースでは見えなかった洞察が得られます。このアプローチは、既存の化合物と新たな治療ターゲットとの間の隠れたつながりを明らかにするため、創薬の精度を高め、ドラッグリポジショニングの機会の特定を加速させます。
専門家によるキュレーションがイノベーションの基盤となる
文脈のニュアンスを理解する能力がなければ、機械は生物学的データセットに固有の曖昧さや不整合を適切に処理できません。熟練した専門家は、微妙な差異を認識し、エラーを解決し、データを調整することで、自動化システムでは不可能な方法で正確性と関連性を確保する重要な役割を果たします。このプロセスは、科学研究を行う人々や関連サービスを提供する組織にとって不可欠です。例えば、数百名のCASの科学者が、世界最大の専門家キュレーションによる科学知識コレクションであるCAS Content Collection™を構築するために使用されるデータをクレンジング、ハーモナイズ、キュレーションしています。
この取り組みは、下流工程の分析の信頼性を高め、潜在的な創薬ターゲットや効果的な疾患治療法の発見を加速させるという成果をもたらします。
予測モデルやネットワーク図のような高度なツールに適用されると、専門家がキュレーションしたハーモナイズデータは、ライフサイエンス分野およびそれ以外の領域でブレイクスルーを促進します。組織が研究におけるデータクレンジングを優先し続けることで、研究結果の品質を確保し、イノベーションを加速させることができます。


