

科学发现始终依赖于优质、纯净的数据。劣质数据会导致结果无法复现、解决方案存在缺陷,并最终不得不重新获取更优质的数据。随着人工智能驱动的预测模型在早期药物研发工作流程中日益普及,确保整个研究流程中数据准确且一致的重要性从未如此凸显。
杂乱的数据仍然是现代药物研发中一个持续存在的挑战,导致科学家花费大量时间来解决实体命名不一致的问题、排查不匹配的数据库格式并纠正错误。机器难以处理复杂数据集中的细微差别,因为它们缺乏解读歧义和不一致性所需的背景理解能力。人类科学家经常需要负责识别并纠正隐藏在数据中、且现有技术尚无法充分解决的问题。
对于药物研发团队而言,杂乱的数据会产生连锁反应,导致研究人员基于错误的假设或不完整的信息来设计实验和构建模型,最终浪费宝贵的资源。正因如此,数据清洗和数据协调这两个相辅相成的过程在优化工作流程中发挥着关键作用,它们分别解决了不同但又相互关联的挑战。
- 数据清洗:由专家识别并纠正错误、填充缺失值并删除无关信息,以确保单个数据集内准确性和可靠性的过程
- 数据协调:人工整合来自多个来源的信息,将其标准化并统一为一个连贯的框架,从而实现无缝分析、可比性和协作
成功进行清洗和协调的关键在于人工管理。
数据清洗,至关重要的第一步
在科学家能够协调数据之前,必须先对其进行清洗。通过消除因数据录入、计算错误、传感器故障或系统漏洞而产生的错误,科学家可以构建协调所需的数据基础。依赖于经过妥善清洗的数据,团队可以获得:
- 更高的准确性,确保从这些数据中得出的结论可靠且可复现,从而获得高质量的候选药物。
- 更高的效率,减少因错误而进行故障排查和重新运行分析所花费的时间。
- 更强的协作, 通过消除数据集之间的差异,促进团队、机构和行业之间更好的合作。
- 更强的预测能力,利用形成的纯净数据为预测模型奠定基础,从而准确预测药物与靶点的相互作用、疾病关系等。
没有经过适当数据清洗的协调就像在流沙上盖楼——脆弱且不可持续。当科学家清洗数据时,他们确保只有最相关、最可靠的信息被纳入下游流程,从而提供对研究全貌的准确洞察,并构建稳固的数据基础。
实现成功数据协调的结构化方法
数据协调(图 1)始于建立权威结构和命名标准。例如,这项细致的工作确保了蛋白质等实体在所有来源和数据集中都被统一命名和分类,从而为药物开发中的靶点识别提供支持。
协调的下一阶段是物质关联,科学家在此阶段识别并连接不同数据集或数据库中对同一化学物质的引用。这一过程将不同的物质表述、同义词和标识符统一为一个单一、一致的实体。这项工作对于药理学和药物研发至关重要,因为不同来源之间惯例的差异往往会导致同一种化合物被以不同的方式描述。
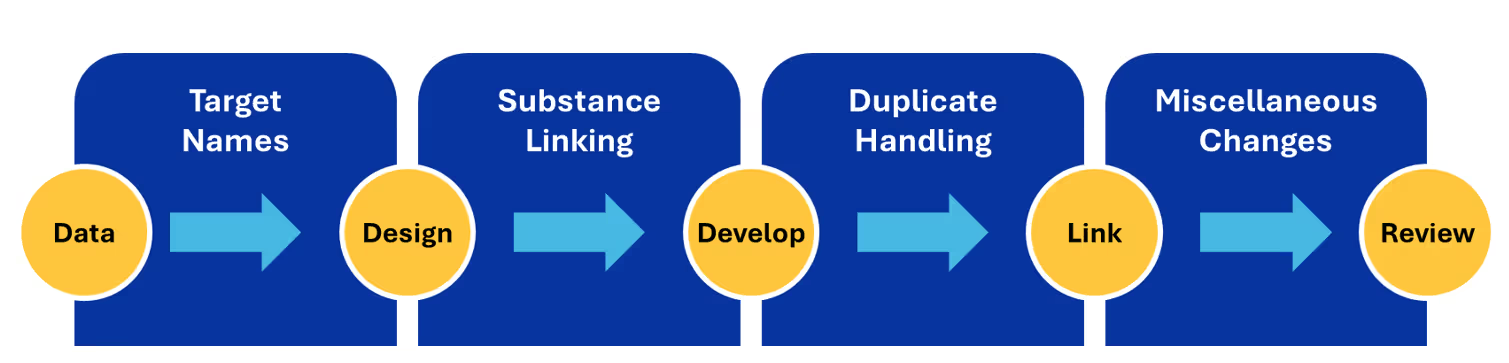
在协调流程的后续阶段,数据科学家会识别并管理精确及相关文档,防止数据重复,确保仅保留最相关的信息。最后一步侧重于确保跨数据集的数据定义一致性,这对于构建基于多源数据的统一基础至关重要。
药物研发团队通过实施由人工策划驱动的数据协调工作流,能够自信地驾驭复杂的数据环境,从而获得适用于高级分析和预测建模的可靠数据集。这种系统化方法最大限度地减少了错误,并确保所有后续研究都建立在坚实、整洁的数据基础之上。
协调后的数据可提高预测模型的准确性
数据协调最显著的优势之一在于其对预测模型的影响。为了证明其对预测准确性的积极作用,CAS 科学家使用经过重新协调的数据集,对一个现有的集成模型进行了再训练,该模型用于预测配体-靶点对的活性。
再训练后的模型准确性显著提升,预测结果与实验结果之间的标准差降低了 23%,预测的配体-靶点相互作用与实验结果之间的差异减少了 56%(图 2)。通过规范靶点名称并改进物质关联,科学家们增强了数据质量,从而更一致、更准确地描述了物质与其靶点之间的关系。

这种预测建模凸显了人工数据协调在优化模型性能方面的核心作用。通过在筛选过程的早期识别并聚焦于最有潜力的候选药物,团队可以加快从“命中”到“先导化合物”的转化阶段,并推进后续的开发与试验。
协调后的数据助力高级分析
数据协调还能优化预测模型以及知识图谱和相互作用网络等高级分析工具,从而推动创新的药物研发工作流(图 3)。这些工具能够帮助研究人员探索靶点、物质和生物通路之间的关系,进而识别疾病关联及新的治疗模式。


统一的人工策划数据基础使科学家能够追踪跨不同生物层面的复杂相互作用(如基因表达、蛋白质相互作用和代谢通路),从而获得碎片化数据源所无法提供的洞察。这种方法提高了药物研发的精确度,并加速了潜在药物重定位机会的识别,因为它揭示了已知化合物与新兴治疗靶点之间隐藏的联系。
人工策划是创新的基石
由于缺乏对语境细微差别的理解能力,机器难以妥善处理生物数据集中固有的歧义和不一致性。专业人员通过识别细微差异、解决错误并对齐数据,在确保数据准确性和相关性方面发挥着自动化系统无法替代的关键作用。这一过程对于从事科学研究的人员及提供相关服务的机构至关重要。例如,数百名 CAS 科学家对构建 CAS Content Collection™ 所使用的数据进行了清洗、协调和策划,这是全球最大的经人工策划的科学知识库。
这项工作带来了显著回报,不仅提高了下游分析的可靠性,还加速了潜在药物靶点和有效疾病疗法的发现。
当应用于预测模型和网络图等高级工具时,经人工策划的协调数据将推动生命科学及其他领域的突破。随着各机构持续重视研究中的数据清洗工作,他们将能够确保研究结果的质量并加速创新。


