

El descubrimiento científico siempre se ha basado en datos fiables y depurados. Los datos deficientes conducen a resultados irreproducibles, soluciones problemáticas y, en última instancia, a la necesidad de revisar y obtener mejores datos. Ahora que los modelos predictivos basados en IA son cada vez más comunes en los flujos de trabajo del descubrimiento temprano de fármacos, la importancia de contar con datos precisos y coherentes en todos los procesos de investigación es mayor que nunca.
Los datos desorganizados siguen siendo un desafío persistente en el descubrimiento moderno de fármacos, lo que obliga a los científicos a dedicar un tiempo considerable a resolver inconsistencias en la nomenclatura de entidades, detectar formatos de base de datos no coincidentes y corregir errores. Las máquinas tienen dificultades para manejar los matices de los conjuntos de datos complejos porque carecen de la comprensión contextual necesaria para interpretar la ambigüedad y las inconsistencias. A menudo, los científicos deben identificar y rectificar problemas ocultos en los datos que la tecnología no está equipada para abordar de manera suficiente.
Para los equipos de descubrimiento de fármacos, los datos desorganizados crean un efecto dominó que lleva a los investigadores a diseñar experimentos y construir modelos basados en suposiciones erróneas o información incompleta, lo que finalmente desperdicia recursos valiosos. Aquí es donde los procesos complementarios de limpieza y armonización de datos desempeñan un papel fundamental en la optimización de los flujos de trabajo, abordando cada uno desafíos distintos pero interconectados.
- Limpieza de datos: El proceso mediante el cual expertos identifican y corrigen errores, completan valores faltantes y eliminan información irrelevante para garantizar la precisión y fiabilidad dentro de los conjuntos de datos individuales
- Armonización de datos: La integración humana de información proveniente de múltiples fuentes, estandarizándola y unificándola en un marco coherente para permitir un análisis, una comparabilidad y una colaboración fluidos
La clave para una limpieza y armonización exitosas reside en la curación humana.
Limpieza de datos, el primer paso crítico
Antes de que los científicos puedan armonizar los datos, deben limpiarlos. Al eliminar los errores derivados de la entrada de datos, errores de cálculo, fallos en los sensores o problemas técnicos del sistema, los científicos pueden construir la base de datos necesaria para la armonización. Los equipos que confían en datos correctamente limpios obtienen:
- Mayor precisión, garantizando que los hallazgos extraídos de estos datos sean fiables y reproducibles, lo que conduce a candidatos a fármacos de alta calidad.
- Mayor eficiencia, reduciendo el tiempo dedicado a la resolución de problemas y a la repetición de análisis debido a errores.
- Colaboración mejorada, facilitando un mejor trabajo en equipo entre departamentos, instituciones e industrias al eliminar discrepancias entre conjuntos de datos.
- Poder predictivo refinado, utilizando los datos limpios resultantes para construir la base de modelos predictivos capaces de pronosticar con precisión las interacciones fármaco-objetivo, las relaciones con enfermedades y más.
La armonización sin una limpieza de datos adecuada es como construir sobre arenas movedizas: frágil e insostenible. Cuando los científicos limpian los datos, se aseguran de que solo la información más relevante y fiable se incorpore a los procesos posteriores, proporcionando una visión precisa del panorama de investigación y una base de datos sólida.
Un enfoque estructurado para una armonización de datos exitosa
La armonización de datos (Figura 1) comienza con el establecimiento de constructos de autoridad y estándares de nomenclatura. Por ejemplo, este minucioso trabajo garantiza que entidades como las proteínas se nombren y categoricen de manera uniforme en todas las fuentes y conjuntos de datos para fines de desarrollo de fármacos, permitiendo así la identificación de objetivos.
La siguiente fase en la armonización es la vinculación de sustancias, en la que los científicos identifican y conectan referencias a la misma sustancia química en conjuntos de datos o bases de datos dispares. Este proceso unifica diferentes representaciones, sinónimos e identificadores de sustancias en una entidad única y coherente. Este esfuerzo es esencial para la farmacología y el descubrimiento de fármacos, donde las variaciones en las convenciones entre fuentes a menudo resultan en que el mismo compuesto se describa de diferentes maneras.
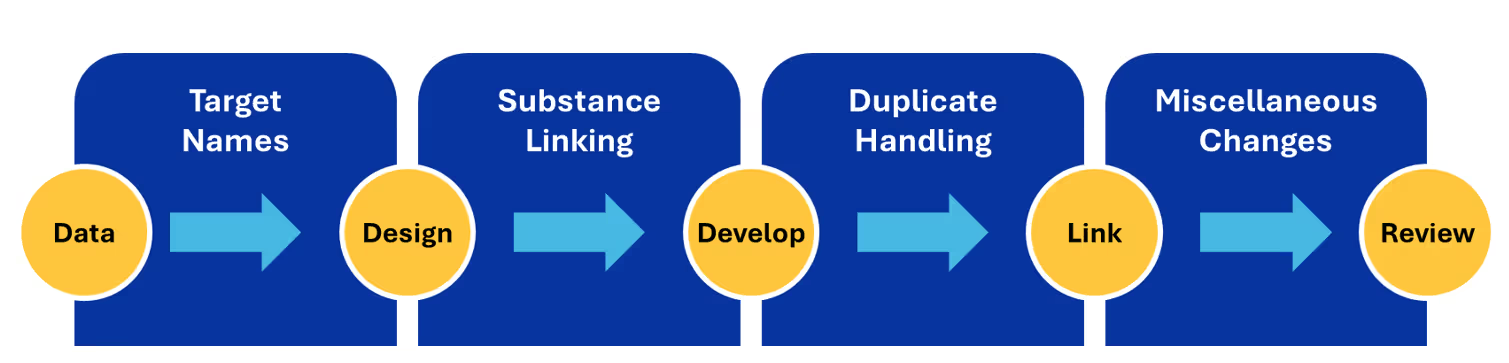
Más adelante en el proceso de armonización, los científicos de datos identifican y gestionan documentos exactos y relacionados, evitando la duplicación de datos y asegurando que solo se conserve la información más relevante. El paso final se centra en garantizar la coherencia de las definiciones de datos en todos los conjuntos de datos, lo cual es esencial para producir una base coherente construida con datos de múltiples fuentes.
Los equipos de descubrimiento de fármacos pueden navegar por complejos entornos de datos con confianza mediante la implementación de un flujo de trabajo de armonización basado en la curación humana, lo que genera conjuntos de datos fiables preparados para análisis avanzados y modelos predictivos. Este enfoque sistemático minimiza los errores y garantiza que toda investigación posterior se base en unos cimientos de datos sólidos y limpios.
Los datos armonizados mejoran la precisión de los modelos predictivos
Uno de los beneficios más tangibles de la armonización de datos es su impacto en los modelos predictivos. Para demostrar el efecto positivo en la precisión de las predicciones, los científicos de CAS utilizaron un conjunto de datos recién armonizado para reentrenar un modelo de conjunto existente que predice la actividad de un par ligando-objetivo.
El modelo reentrenado demostró mejoras significativas en la precisión, reduciendo la desviación estándar entre los resultados previstos y los experimentales en un 23 % y disminuyendo la discrepancia en las interacciones ligando-objetivo previstas frente a las experimentales en un 56 % (Figura 2). Al normalizar el nombre del objetivo y mejorar la vinculación de sustancias, los científicos mejoraron los datos para describir la relación entre una sustancia y su objetivo de forma más coherente y precisa.

Este modelado predictivo subraya el papel esencial de la armonización humana de datos en el perfeccionamiento del rendimiento de los modelos. Al identificar y centrarse en los candidatos más prometedores en las primeras etapas del proceso de cribado, los equipos pueden avanzar más rápidamente en la fase de hit-to-lead y proceder con el desarrollo y los ensayos.
Los datos armonizados impulsan los análisis avanzados
La armonización de datos también optimiza los modelos predictivos y las herramientas analíticas avanzadas, como los grafos de conocimiento y las redes de interacción, que impulsan flujos de trabajo innovadores en el descubrimiento de fármacos (Figura 3). Estas herramientas ayudan a los investigadores a explorar las relaciones entre objetivos, sustancias y rutas biológicas para identificar asociaciones con enfermedades y nuevas modalidades terapéuticas.


Una base de datos unificada y curada por humanos permite a los científicos rastrear interacciones complejas a través de diversos niveles biológicos —como la expresión génica, las interacciones proteicas y las rutas metabólicas—, proporcionando conocimientos que, de otro modo, quedarían ocultos por fuentes de datos fragmentadas. Este enfoque mejora la precisión del descubrimiento de fármacos y acelera la identificación de oportunidades de reposicionamiento de fármacos, al revelar conexiones ocultas entre compuestos establecidos y objetivos terapéuticos emergentes.
La curación humana constituye la base de la innovación
Sin la capacidad de apreciar los matices contextuales, las máquinas tienen dificultades para manejar adecuadamente la ambigüedad y las inconsistencias inherentes a los conjuntos de datos biológicos. Los profesionales cualificados desempeñan un papel vital al reconocer variaciones sutiles, resolver errores y alinear los datos para garantizar la precisión y la relevancia de formas que los sistemas automatizados no pueden. Este proceso es vital para quienes realizan investigación científica y para las organizaciones que prestan servicios relacionados. Por ejemplo, cientos de científicos de CAS limpian, armonizan y curan los datos utilizados para construir la CAS Content Collection™, la mayor colección mundial de conocimiento científico curado por humanos.
Este esfuerzo se traduce en una mayor fiabilidad de los análisis posteriores y en la aceleración del descubrimiento de posibles objetivos farmacológicos y tratamientos eficaces contra enfermedades.
Cuando se aplican a modelos predictivos y herramientas avanzadas como los diagramas de red, los datos armonizados y curados por humanos impulsan avances en las ciencias de la vida y más allá. A medida que las organizaciones siguen dando prioridad a la limpieza de datos en la investigación, pueden garantizar la calidad de sus hallazgos y acelerar la innovación.


