

エグゼクティブサマリー
現代の科学研究において、人工知能(AI)は変革をもたらす力として台頭し、研究者がどのように概念化し、実行し、検証を行うかというプロセスを根本から変えています。計算能力、高度なアルゴリズム、そして膨大なデータセットの融合により、AIは理論上の可能性から、あらゆる科学分野における実用的な必要不可欠なものへと進化しました。
この革命は、これまで科学の進歩を制限してきた長年の課題に対処するものです。ゲノミクス、医学、材料科学などの分野で生成される圧倒的なデータ量、創薬などのプロセスにかかる膨大な時間とコスト、そして仮説生成における認知の限界といった課題です。AIは、これらの課題を克服し、多くの科学分野でより迅速なブレークスルーを見出すための、新しく有望な道筋を提供します。
例えば、バイオメディカル科学において、AIはタンパク質構造予測に革命をもたらし、創薬プロセスを加速させ、個別化医療を実現しました。同様に、材料科学においても、AIは新しい材料の発見を加速させています。これらの進歩は、科学的手法そのものを変えつつある自律型実験室や逆設計フレームワークへの道を切り拓きました。また、AIは実験のリアルタイム調整を可能にすることでプロセス最適化を大幅に進歩させ、歩留まりと効率を向上させながら、廃棄物とコストを削減しています。
私たちは、人間がキュレーションした最大の科学情報リポジトリであるCAS Content CollectionTMの定量分析を行い、これらの技術的進歩が科学的発見に与える実装と影響を理解しようと試みました。2015年から2025年までのCAS Content Collectionに含まれる31万件以上の学術論文と特許を体系的に分析し、高度な分析手法を用いてAI関連の出版物と、それに関連する手法、機関、研究領域を特定しました。
本研究では、科学分野全体におけるAI手法の分布を調査し、バイオメディカル科学と材料科学という2つの重要な領域について詳細な分析を行っています。これらの分析では、主要な概念、AI手法の共起パターン、注目すべき物質クラスを詳述しています。さらに、産業プロセスの最適化におけるAIの役割と、新たな応用についても調査しました。
これらの知見は、科学研究におけるAI統合の現状と軌跡に関する重要な洞察を提供し、技術導入パターンの理解、コラボレーション機会の特定、そして将来のAI投資や研究の方向性に関する戦略的な意思決定を行う上で、研究者、機関、政策立案者に貴重なガイダンスを提供します。
科学におけるAIモデルの展望
特定のモデルが選択される背景とその影響を理解するために、AIベースの手法を取り入れた学術論文や特許ファミリーを含む科学出版物の包括的な分析を実施しました。全体像を可視化することで、モデルや機能の開発が進むにつれ、科学分野全体でこれらの技術の統合が加速していることが浮き彫りになりました(図1を参照)。

この可視化の主な分類は以下の通りです:
分類、回帰、およびクラスタリングモデル
分類モデルは、離散的なラベルやカテゴリを予測するように設計されており、高次元データの処理や解釈可能な結果の提供において特に効果的です。一般的なモデルには、データを再帰的に分岐させて結果を分類する決定木(DT)があります。ランダムフォレスト(RF)は、予測を平均化することで過学習を抑える決定木のアンサンブルです。また、クラス間の最適な境界を見つけるサポートベクターマシン(SVM)や、最も近い近傍の多数派クラスを分類するK近傍法(KNN)も一般的なモデルです。
これらのモデルは、分光法、顕微鏡法、オミクスデータなど、クラスが既知であるカテゴリー的結果を伴うラベル付きデータセット(教師あり学習)に広く適用されています。応用例としては、遺伝子発現や画像データからの疾患分類、材料クラスの予測、毒性や反応性に基づく化合物の分類などが挙げられます。
回帰モデルは連続的な数値を予測するため、予測や最適化に最適です。文献で見られる回帰モデルには、線形回帰、ロジスティック回帰、サポートベクター回帰(SVR)、シンボリック回帰などがあります。これらのモデルは、実験やシミュレーションから得られる数値データ、あるいはセンサーや計測機器からの時系列データに適しています。応用分野には、エネルギーレベル、崩壊率、粒子軌道の予測、反応収率の推定、分子特性、温度や降水量のモデリング、導電率、硬度、バンドギャップの予測などが含まれます。
分類や回帰とは異なり、クラスタリングモデルはラベルのないデータから自然なグループ分けを見つけ出し、隠れた構造を明らかにして探索的分析(教師なし学習)を支援します。これらのモデルは、画像、スペクトル、分子データといった高次元のラベルなしデータセットに対して有効です。このグループに適した科学データには、発現プロファイルに基づく遺伝子やサンプルのグループ化、構造データからの新しい材料ファミリーの発見などが含まれますが、これらに限定されません。
人工ニューラルネットワーク(ANN)
ANNは、相互接続された人工ニューロンの層を通じて複雑なパターンを学習するように設計された機械学習(ML)モデルの一種です。データ内の複雑で非線形な関係をモデル化する能力に優れています。その結果、ディープラーニングの基礎となり、現代のAIの基盤となっています。これには、シーケンシャルデータ用のリカレントニューラルネットワーク(RNN)、長期的な依存関係をより適切に捉える強化版RNNである長短期記憶(LSTM)、およびパラメータ数を減らしたLSTMの簡略版であるゲート付きリカレントユニット(GRU)といった特殊なアーキテクチャが含まれます。
これらのモデルは、遺伝子発現、タンパク質配列、生理学的信号、気候データ、素粒子物理学、センサーネットワークデータなどのシーケンスデータや時系列データに適しています。また、ドメイン固有の概念とその関係性を構造的に表現したナレッジマップを活用することで、画像とテキストの整合性を高めることが多く、視覚データ(医療画像など)とテキスト記述(臨床ノートや診断レポートなど)の間の意味的なギャップを埋めるのに役立ちます。その採用は、創薬・開発、精密医療、医療画像診断、材料探索・設計、エネルギー貯蔵、製造、品質管理などの分野で急増しています。
ハイブリッド手法
ANNと従来の機械学習モデル(分類、回帰、クラスタリングなど)の比較は、どちらが優れているかという問題ではなく、それらがどのように補完し合っているかを理解することが重要です。ANNは、データが複雑で非構造化されており、大規模なトレーニングデータセットが存在し、表現学習が必要な場合に威力を発揮します。対照的に、従来の機械学習は、データが小規模である場合や、研究課題において厳密な解釈可能性が求められる場合、また入力データが統計的に十分に理解されており、不確実性の定量化が必要な場合に強みを発揮します。
ドメイン固有モデル
ドメイン固有モデルに関する文献はまだ少ないものの、タンパク質構造予測において実験値に近い精度を達成したディープラーニング手法であるAlphaFoldのような画期的な研究が含まれています。ESMFoldも興味深いモデルで、タンパク質の言語モデルを直接活用し、単一のタンパク質配列から高品質な構造予測を生成します。
自然言語処理(NLP)
NLPは、人間の言語を分析、理解、解釈、生成するために使用されます。これには、アルゴリズムで処理可能なトークン(単語やサブワードなどの小さな単位)にテキストを分割するトークン化などのタスクが含まれます。テキストを表現する一般的な手法として、文法や語順を無視し、単語の出現頻度に基づいてテキストを数値ベクトルに変換するBag of Words(BoW)モデルがあります。もう一つの重要な技術は、テキスト内の人名、組織名、場所などのエンティティを識別・分類する固有表現抽出(NER)です。
NLPモデルは、生物医学分野のテキストマイニングや知識抽出において幅広く応用されています。生物医学文献で事前学習された専門的な言語モデル(BioBERT、BioGPTなど)や電子健康記録(EHR)の分析から、臨床記録からの疾患特性の自動抽出、言語モデルを用いた新規候補薬の創出まで多岐にわたります。材料科学や化学の分野では、NLPは合成プロトコルの抽出、材料特性の予測、知識ベースの構築、逆設計などに利用されています。
大規模言語モデル(LLM)
この変革的なAIシステムは、NLPに革命をもたらし、科学のあらゆる領域で幅広く応用されています。LLMは、膨大なテキストデータで学習し、言語の統計的パターンを習得するニューラルネットワークベースのシステムです。情報抽出、要約、ナレッジグラフの構築、ドメイン横断的な統合、および生成アプリケーションに使用されています。
広く採用されているLLMには、ChatGPT、GPT-3.5、GPT-4を支えるGenerative Pre-Trained Transformer(GPT)があります。Bidirectional Encoder Representations from Transformers(BERT)も依然として主要な言語モデルであり、双方向の文脈理解と質問応答や感情分析における優れた性能により、学術的な関心を集め続けています。
多言語モデルであるBLOOMは、研究環境において重要な貢献を果たしています。Google DeepMindが開発したGEMINIやMeta AIのLLAMA、Anthropicが開発したClaudeといった新しいモデルも人気を集めています。2023年から2025年にかけて発表されたGemma、Falcon、Mistral、Qwen、DeepSeekといった最新世代のモデルも、今後の発展に大きな期待が寄せられています。
化学、生命科学、材料科学向けの専門的なLLMも影響力を強めており、chemLLM、PharmaGPT、MatSciBERTなどがその例です。
科学におけるAIの影響を示す出版動向
前述の通り、2015年から2025年までの期間における科学研究でのAI関連のCASコンテンツコレクションの文書31万件を分析しました。全期間を通じて着実な成長が見られ、特に過去5年間で顕著な伸びを記録しています(図2参照)。特許ファミリーの増加は、AIが新興技術から、さまざまな産業において不可欠な研究ツールへと進化していることを示唆しています。

- 国・地域および組織別の分布:出版物数(学術論文および特許)では中国が首位に立ち、米国、インド、韓国、日本も着実な伸びを見せています(図3参照)。全体として、このデータは、AI分野における世界の科学イノベーションの新たな中心地としてアジアが台頭しており、欧米諸国が量的アウトプットの面で後塵を拝している現状を浮き彫りにしています。

- 特許ファミリーの分布:上位5カ国の学術論文および特許の出版傾向をさらに分析しました。中国とインドは、この分野における世界の特許の75%以上を占めており、特許出願数上位15機関はすべて中国とインドの機関です。学術論文数では中国の大学が圧倒しており、その多くは平均被引用数が10〜20回となっています。対照的に、MITとスタンフォード大学はそれぞれ32回、66回という非常に高い平均被引用数を誇ります。これは、中国が量で勝る一方で、AI分野の学術論文の質と影響力では米国の大学がリードしていることを示唆しています。
- 特定の出版物における分布:AIベースの研究を掲載する主要な科学ジャーナルの出版数と被引用による影響力を分析しました。出版数ではScientific Reports、Applied Sciences、およびPLoS Oneが上位を占めています。しかし、論文1本あたりの平均被引用数を考慮すると、Proceedings of the National Academy of Sciences (PNAS)が際立っており、出版数は比較的控えめながらも、1出版物あたり50回近い引用という卓越した影響力を示しています。その他、Journal of Chemical Information and Modelling (JCIM)、Bioinformatics、およびNature Communicationsも平均被引用数が非常に高く、膨大な出版数を誇るジャーナルを大きく上回っています。この傾向は、Scientific Reportsのような広範な分野を扱うジャーナルが最も多くのAI関連研究を掲載する一方で、PNAS、JCIM、Nature Communicationsのような専門性の高い、あるいは権威あるジャーナルが、より大きな科学的インパクトを生む影響力の高い研究を掲載していることを示唆しています。
- 科学分野別の傾向:多くの分野がAIの影響を大きく受けていますが、出版数が指数関数的に増加している分野がいくつかあります(図4参照)。

全分野の中で、工業化学・化学工学は学術論文数において最も劇的な成長を見せており、2024年までに全文書の約8%を占めるに至りました。この並外れた成長は、製造、プロセス最適化、産業イノベーションといった幅広い応用分野に加え、持続可能な産業プロセスやグリーンケミストリーのソリューション開発における重要な役割を反映していると考えられます。
Analytical Chemistry emerges as the second-fastest growing field in terms of journal publications, with the deep blue line showing robust growth throughout the period from 2019 onward. This strong growth pattern shows the field's fundamental importance across all areas of chemistry and its role in developing new measurement techniques, instrumentation, and analytical methods that support research across multiple disciplines.
Energy Technology & Environmental Chemistry demonstrates solid growth, jointly ranking third among the fastest-growing fields along with Biochemistry. This reflects urgent global focus on climate change, environmental sustainability challenges, and emerging events.
The remaining disciplines, including Physical Chemistry, Pharmacology, Toxicology and Pharmaceuticals, Organic Chemistry, Inorganic Chemistry, Natural Products, and Synthetic Polymers, all demonstrate modest but consistent increases in publication volume. These fields represent mature areas of scientific research where fundamental principles are well-established, yet continued investigation yields incremental advances and refinements.
The patent family data presents a strikingly different landscape compared to journal publications, with highly varied and concentrated innovation patterns rather than the uniform growth seen in academic output. This contrast highlights the fundamental difference between academic research productivity and commercially viable innovation, where market forces, practical applications, and economic incentives play decisive roles in determining which scientific advances translate into patentable intellectual property.
Among patents, Biochemistry shows exponential-like growth, reaching approximately 8% by 2024 and completely overshadowing all other disciplines. The biochemistry patent landscape is dominated by biomedical methods and shaped by innovations that merge molecular science with advanced healthcare technologies. Key domains include disease detection, medical imaging, wearable monitoring, and clinical decision support, all leveraging biochemical markers. Biochemistry also drives progress in neurological interfaces, genomics, biomarker discovery, signal processing, surgical guidance, and biomedical manufacturing, highlighting its central role in modern biomedical innovation This dramatic patent activity reflects the intense commercial interest and investment in life science research in general and further boosted in response to the COVID pandemic, where commercial research was given significant funding.
Based on our analysis, we found the majority of the AI-related publications are related to biomedical research and materials science. Hence, we conducted an in-depth analysis for these key research areas as these fields dominate the dataset, exhibit rapid AI adoption with notable annual growth rates, and yield higher citation impacts, indicating their scientific relevance.
生物医学研究におけるAIモデルの応用
概要
Biomedical research has faced ongoing challenges in complexity and costs that AI can now address. For example, decoding complex protein structures and interactions, the high costs and failure rates associated with drug development, and the intricacies of understanding multifactorial disease mechanisms all lend themselves to AI-based approaches.
AIを活用した科学研究のためのデータ整合性。AIのデータ処理能力と計算速度は人間の能力を凌駕しており、この技術は今後も「可能であること」の定義を塗り替えていくでしょう。しかし、科学におけるAIのあらゆる成功した応用において、データの整合性と調和は不可欠な要素です。
本分析の根拠は、文書の頻度を客観的な指標として主要な概念を特定することで、最も重要な研究領域の代表的なサンプリングを確実にすることでした。具体的には、生物医学分野において、いくつかのAI/ML手法を用いて、科学的な関心と研究投資を大きく集めている概念を特定しました(図5参照)。

In the Biochemistry domain, protein sequences and structures, gene and gene expression and DNA/genomics have emerged as the most extensively studied concepts, utilizing diverse machine learning approaches. ML models thrive in these areas due to data abundance and standardization, especially in complex systems like protein hierarchies and gene regulatory networks. ML excels in tasks such as sequence-function mapping, protein family classification, domain prediction, structure-function analysis, tumor feature selection, gene interaction prediction in cancer, and clustering genes by expression in patterns in oncology, leveraging high-dimensional expression data with thousands of genes measured simultaneously, complex non-linear relationships between genes and phenotypes, and hierarchical organization of genetic regulatory networks.
AlphaFoldやBERTのような高度な機械学習モデルは、タンパク質の構造予測に利用されており、アミノ酸配列や進化パターンから学習することで、3次元の折り畳み構造や機能ドメインを予測します。これらのモデルは、複雑な空間的関係や長距離依存性を持つ順序データ入力を効果的に処理します。
モデリングおよび創薬設計の分野では、QSAR(定量的構造活性相関)モデリングが主流です。この分野では、機械学習手法を用いて化学構造から分子記述子(物理化学的特性やフィンガープリントなど)を抽出し、教師あり学習アプローチを通じて生物学的活性や毒性のエンドポイントを予測します。これらの手法は、情報量の多い分子記述子、構造活性相関、および回帰タスクに適した定量的なエンドポイントを用いる場合に特に優れた性能を発揮します。
2番目に頻出する概念である分子ドッキングでは、3次元構造データや分子グラフに対してディープラーニング(CNNやGNN)のアプローチを用い、空間的コンフォメーション、エネルギーランドスケープ、分子間相互作用を活用して、タンパク質とリガンドの結合ポーズや親和性を予測します。次に注目されているのが薬物動態学であり、分子記述子、生理学的パラメータ、時系列データから学習する機械学習を用いて、ADMET特性(吸収、分布、代謝、排泄、毒性)や薬物クリアランス率を予測します。
診断分野ではバイオマーカーが支配的であり、機械学習手法は高次元のゲノミクス、プロテオミクス、メタボロミクスデータを解析して、特徴選択と分類を通じて疾患状態と健常対照を識別する分子シグネチャーを特定します。AI手法は予後研究にも用いられており、患者の臨床データや治療歴を解析することで、生存分析の手法を通じて生存期間や疾患の進行を予測します。
医用画像にはX線、CT、MRIからのデータや構造化された空間情報が含まれており、これらはディープラーニング手法に最適です。CNNは、自動パターン認識を通じて、腫瘍の検出、骨折の特定、疾患の分類、病理学的状態の診断を行うための放射線画像解析に広く利用されています。画像診断は、ディープラーニングが持つマルチスケールな特徴抽出能力やセグメンテーションタスクの実行能力からも恩恵を受けており、特にがん診断においては、腫瘍の検出、分類、悪性度評価、リスク予測を支援します。
疾患分野では、がん研究が最も注目を集めており、データタイプに応じて様々な機械学習モデルが適用されています。ゲノムデータやトランスクリプトームデータは、一般的にRF(ランダムフォレスト)やSVM(サポートベクターマシン)モデルを用いて解析され、がんのサブタイプ分類や治療予測が行われます。これらのタスクは、多様な分子層を捉えるマルチオミクスデータの統合や、不均一な腫瘍微小環境の複雑さをモデル化することから恩恵を受けています。
糖尿病研究では、縦断的なモニタリングデータ、ライフスタイル要因と遺伝学の間の複雑な相互作用、および血糖値の時系列予測問題を活用し、糖尿病合併症の予測や治療プロトコルの最適化のために様々なアルゴリズムが使用されています。アルツハイマー病の研究では、神経心理学的検査スコア、バイオマーカーレベル(アミロイドベータ、タウタンパク質)、人口統計学的データを解析して患者を健常または軽度認知障害のカテゴリーに分類するために、RFやSVMモデルが広く利用されています。アルツハイマー病の分野では、RFやSVMモデルが広く利用されています。
In the Therapy domain, antitumor agents received the most research attention, employing ML methods for drug screening and activity prediction by analyzing molecular descriptors and chemical properties to identify compounds with potential anticancer activity. In chemotherapy, these methods predict treatment responses and toxicity by analyzing patient clinical data, genetic profiles, and tumor characteristics for personalizing drug selection and dosing protocols. Similarly, these models support immunotherapy by analyzing patient immune profiles, tumor mutational burden, and biomarker expressions to predict response and optimize therapeutic outcomes, addressing the complexity of immune interactions and temporal dynamics.
AIモデルと生物医学的概念の共起
本分析では、生物医学的概念と様々なAI/機械学習手法との間の共起パターンを調査し、5つの領域におけるそれらの戦略的応用を明らかにします(図6を参照)。


ランダムフォレスト(RF)は生物医学研究における主要なAI手法として台頭しており、2つの期間の間に顕著な成長を見せ、サポートベクターマシン(SVM)を追い抜きました。RFは、生物医学のあらゆる領域、特に生化学、診断、疾患関連の研究において、概念との強い共起を示しています。RFは、アミノ酸組成、配列モチーフ、物理化学的特性を解析してタンパク質を機能ファミリーに分類することで、タンパク質の機能予測や分類に使用されています。バイオマーカー探索においては、高次元のゲノミクス、プロテオミクス、メタボロミクスデータの解析にRFが使用されています。
サポートベクターマシン(SVM)は、両期間を通じて着実に成長しつつ、タンパク質、遺伝子発現、DNAおよびゲノミクス、バイオマーカー、予後、医用画像、がん研究において重要な存在感を維持しています。タンパク質研究において、SVMはアミノ酸配列、構造的特徴、物理化学的特性を解析することで、タンパク質の分類や機能アノテーションに使用されています。また、カーネルベースの高次元特徴空間マッピングを用いて、細胞内局在の予測や酵素クラスの特定も行っています。
遺伝子発現において、SVMは特定の生化学プロセスに関与する遺伝子を特定し、代謝経路を分類し、異なる生化学的条件や細胞状態における発現パターンに基づいて酵素をコードする遺伝子を予測します。ゲノム変異の分類については、SVMはDNA配列の特徴やアノテーションを処理し、ヌクレオチドパターンやゲノムコンテキストの高次元特徴解析を通じて、病原性変異と良性変異を区別し、疾患に関連するゲノム領域を特定します。
バイオマーカー研究において、SVMは、診断、治療反応、疾患進行リスク評価のための予測モデルに複数のバイオマーカーを統合し、個別化医療アプローチに向けて患者を層別化することで、その特定、分類、検証をサポートします。がん研究では、がん組織と正常組織の識別、がんの種類の分類、特定のがん内における分子サブタイプの特定にSVMが使用されています。また、臨床パラメータ、バイオマーカープロファイル、ゲノム特徴を統合して、患者の生存転帰、治療反応、薬剤耐性パターン、再発リスクを予測することで、がんの予後や治療予測にも活用されています。図6Bは、後の期間において、タンパク質解析との関連性がRFと比較して弱まった一方で、SVMがQSARおよびSARモデリングにおける強みを維持していたことを示しています。
ロジスティック回帰(LR)は、生物医学研究において広く利用されている解釈可能な統計手法であり、タンパク質、遺伝子発現、バイオマーカー、予後、医用画像、がん、COVID-19といった主要な概念と頻繁に共起します。タンパク質機能予測において、LRはアミノ酸組成、配列特徴、構造的特性を解析し、タンパク質を機能的または構造的なカテゴリーに分類します。このモデルの主な利点は、各特徴が分類決定に与える相対的な寄与度を示す解釈可能な係数を提供することであり、研究者はどのタンパク質特性や構造的特徴が予測に最も強く影響しているかを特定できます。
この解釈可能性は、遺伝子発現の分類においても同様に価値があり、LRは発現変動遺伝子の特定に役立ちます。バイオマーカーの検証や診断において、LRモデルは疾患か健常か、あるいは反応者か非反応者かといった二値の結果を予測し、診断の意思決定に臨床的に意味のあるオッズ比を提供します。予後モデリングにおいて、LRは同様の二値結果予測を用い、臨床パラメータ、バイオマーカープロファイル、患者の人口統計学的データを評価することで、死亡/生存、疾患の再発/寛解、良好/不良な予後といった転帰を予測します。
LRは、併存疾患、バイタルサイン、バイオマーカーを統合することで、COVID-19の診断、重症度予測、死亡率予測に使用されており、リスク層別化や臨床的な意思決定を支援しています。これらの多様な応用は、LRが生物医学研究の核心的なテーマと強く整合していることを裏付けており、解釈可能で臨床的に関連性の高いモデリングのための基礎的なツールとなっています。図6Bは、ロジスティック回帰の適応性が向上していることを示しており、これは連続的な予測に限定される線形回帰とは異なり、多クラス分類や確率ベースの出力が可能であるためと考えられます。
図6Bに見られるように、2020〜2024年の期間には、それ以前にはほとんど存在しなかったAlphaFoldのような専門的なディープラーニングアプローチが登場しました。また、この期間には、分子相互作用モデリングのためのグラフニューラルネットワーク(GNN)、合成データ生成のためのグラフ敵対的ネットワーク(GAN)、および画像応用や診断課題のためのパターン認識の使用が急増しました。
近年におけるもう一つの大きな変化は、生物医学研究へのNLP(自然言語処理)技術の統合です。臨床レポートのマイニングや生物医学テキストの分析において、BERTのようなモデルの台頭がその象徴です。 この専門化は、汎用的なAI手法の適用という段階を超え、特定の生物医学的課題に向けた最適化されたアプローチの開発へと、この分野が成熟していることを反映しています。
研究の優先順位は、この2つの期間で大きく変化しました。2020年から2024年にかけては、タンパク質の配列・構造解析および遺伝子発現解析が大幅に増加しました(図6B)。バイオマーカーの発見や画像診断への応用も劇的な成長を遂げ、疾患特異的な研究も著しく拡大しました。特にCOVID-19が主要な焦点として浮上し、がん研究では複数のサブタイプにわたる多様化が進みました。
生物医学研究における物質
この比較は、十分に探求されていない治療機会に関する戦略的な洞察を提供し、科学的発見と臨床応用の間のギャップを埋めるために、研究投資の拡大や革新的なアプローチが求められる物質クラスを浮き彫りにします(図7を参照)。なお、「物質クラス」とは、治療への応用が認められているCAS登録物質のカテゴリーを指します。
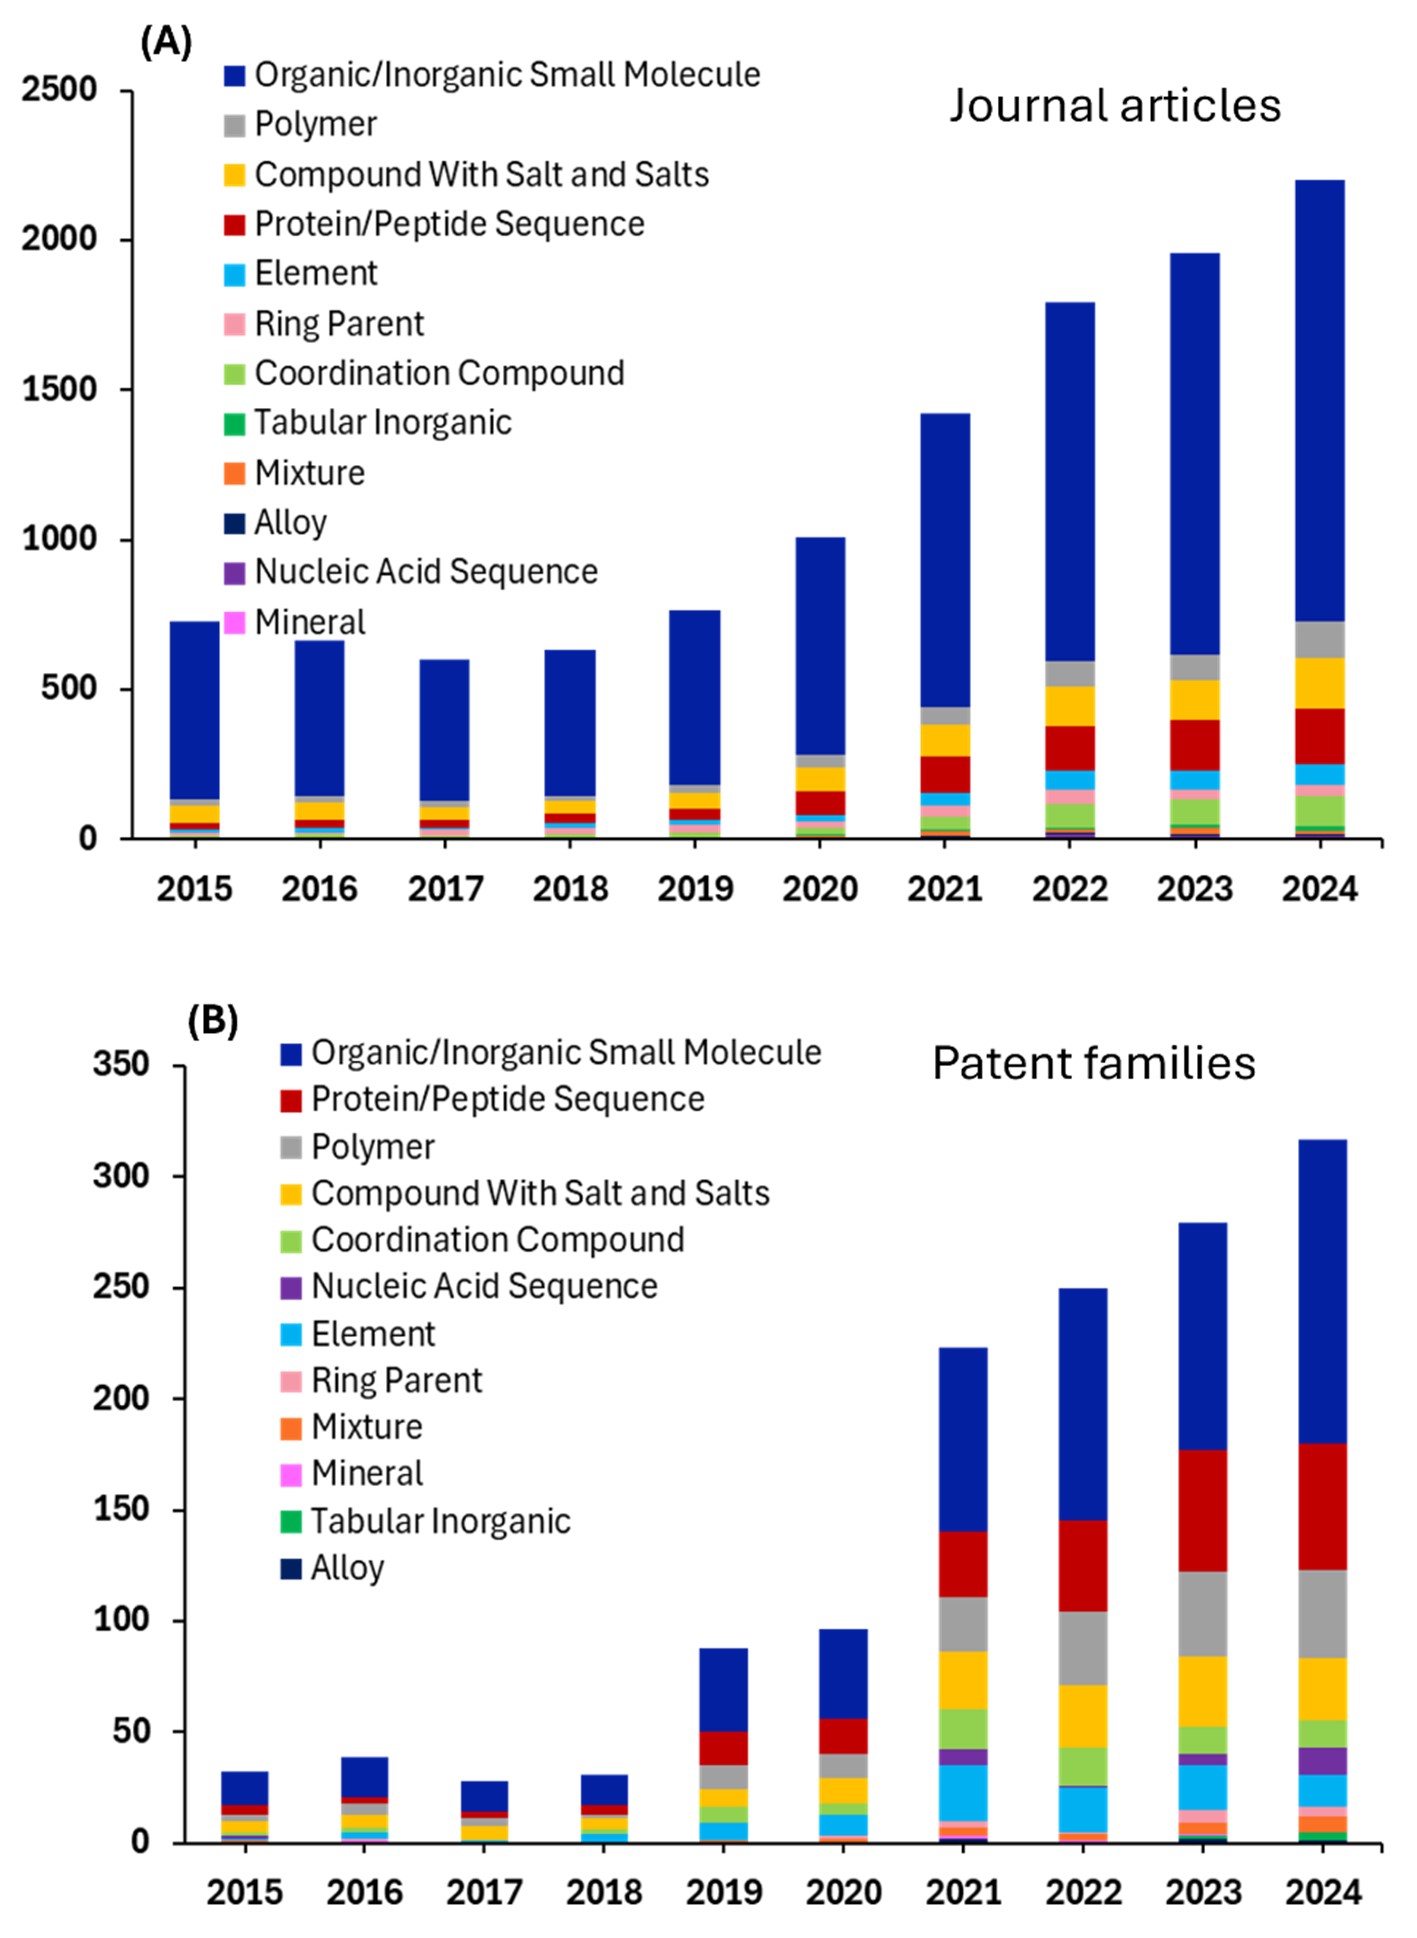
低分子医薬品は依然として医薬品の研究開発において主流であり、AI技術がその発見を加速させています。機械学習を用いたバーチャルスクリーニング、QSAR(定量的構造活性相関)モデリングによる薬物動態予測、そして合成経路を最適化するディープラーニングシステムが、現在このプロセスに不可欠なものとなっています。これらの革新は、確立された合成ルート、十分に解明された薬物動態、経口バイオアベイラビリティ、費用対効果の高い製造といった、低分子が本来持つ利点の上に成り立っています。
タンパク質・ペプチド医薬品は、2番目に研究が盛んなカテゴリーです。AlphaFoldのようなツールはタンパク質の構造予測に革命をもたらし、糖尿病治療のためのインスリン、脳卒中治療のための組織プラスミノーゲン活性化因子、がんや自己免疫疾患のためのモノクローナル抗体といった治療用タンパク質の設計と最適化を可能にしました。さらに機械学習モデルは、タンパク質間相互作用の予測やペプチドの安定性最適化を通じて、この分野をさらに強化しています。
塩および塩を含む化合物は、溶解性、バイオアベイラビリティ、安定性を予測するAI駆動型の製剤最適化アルゴリズムの恩恵を受けており、これは薬物製剤化とバイオアベイラビリティ最適化の重要性を反映しています。重要な治療用デリバリーシステムとして機能することが多いポリマーは、AIで設計されたナノ粒子製剤、機械学習で最適化されたハイドロゲルの特性、そして治療効果と組織特異性を向上させる標的薬物送達のための予測モデリングを通じて強化されています。
錯体は、AIが配位子の設計や金属有機構造体(MOF)の最適化を支援する、もう一つの有望なクラスです。これらの化合物は、金属と配位子の相互作用や生物活性を予測する計算化学およびAIモデルを通じて改良が進められています。
材料科学におけるAIモデルの応用
概要
材料科学において、材料科学、材料の組成、構造的特徴、および特性の間の複雑な関係を理解し予測することは、材料発見を加速させるために不可欠です。関連するデータは多くの場合、多次元的、階層的、かつ異種混合的であり、データ集約型のハイスループットプロセスを通じて生成されます。AI、特に機械学習は、こうした複雑なデータセットの分析を可能にすることで、この分野に革命をもたらしています。私たちはCAS Content Collectionを分析し、AI手法が適用されている主要な材料科学の概念を特定するとともに、材料発見と特性予測におけるそれらの重要性を評価しました(図8を参照)。

Energy storage is the most AI-intensive research area in Applications, reflecting the global need for advanced battery technologies and sustainable energy solutions. ML techniques have become potent tools for battery material innovation, with researchers utilizing three main strategies: direct property predictions, machine learning potentials, and inverse design. The high concentration of AI research in this field stems from the complex multi-scale nature of battery systems, where traditional experimental approaches often fall short in optimizing the intricate relationships between material composition, structure, and electrochemical performance.
In the Materials and the Devices categories, the significant AI activity in ceramics, piezoceramics, sensors, and field effect transistors reflects the sophisticated nature of these materials and their devices. These advanced materials often exhibit complex structure-property relationships that are ideal candidates for ML approaches.
In Structural Features, we found that convolutional neural networks (CNNs) along with computer vision are used for microstructural analysis by enabling automated classification, segmentation, and feature extraction from microscopy images. These tools are helping uncover structure-property relationships that were previously difficult to quantify. In metallurgy, targeted AI approaches are advancing superalloy development, while systems like CAMEO (Closed-Loop Autonomous Materials Exploration and Optimization) enable combinatorial metallurgy by integrating AI with high-throughput experimentation. Furthermore, machine learning tools for 3D tomography data are enhancing the analysis of porous materials, allowing for more accurate modeling of properties like permeability and mechanical strength.
Dielectric constant and electric conductivity are the leading concepts in Properties, while piezoelectricity leads in Phenomena. In Simulation and Modeling, computational modeling shows high AI adoption, which aligns with machine learning's natural compatibility with data analysis tasks.
図7で紫や混色で示されているAI活動が中程度の領域は、AIの導入が加速しているものの、改善の余地がある分野です。例えば、主に青色で示される一部の材料分野での活動の低さは、科学において最も確立された基礎的な領域であることを示しており、最も成熟した分野ほどAIの統合が進んでいないという逆説的な状況を生んでいます。複合材料やポリマーがこのカテゴリーの代表例です。
However, specialized AI models are being developed to address specific challenges. The model polyBERT, treats polymer structures as a chemical language, enabling more effective modeling of complex polymer systems. For crystalline materials, models like MEGNet, CGCNN, and SchNet incorporate crystal symmetry and quantum interactions, while ALIGNN captures higher-order atomic interactions essential for accurate alloy property prediction.
AIモデルと材料科学の概念の共起
バイオメディカル分析と同様に、材料科学におけるAI手法と共起する概念について詳細な調査を行いました。その結果、ランダムフォレスト(RF)、サポートベクターマシン(SVM)、勾配ブースティングマシン(GBM)、決定木(DT)といった従来の機械学習モデルが、予測や特徴量の重要度分析に広く利用されていることが判明しました。これは、材料インフォマティクスにおいて非線形関係を持つ高次元データが一般的であるためです(図9を参照)。


RFモデルは広く利用されており、あらゆる概念領域に分布しています。これらはGBMモデルとともに、非線形関係のモデル化や混合データ型の処理能力に優れているため、複雑で不均一な材料との強い共起性を示します。多くの場合、不均一な複合材料、機械的特性の予測、およびマトリックスと強化材の複雑な相互作用を捉えることによる破壊解析に用いられています。
これらは合金とも共起しており、RFは合金組成における非線形関係のマッピングに利用され、高エントロピー合金の設計、析出強化の予測、熱処理の最適化に貢献しています。GBは、降伏強度や耐食性の最適化など、精密な特性調整に向けて適用範囲が拡大しています。
SVMは、構造と特性の関係が明確に定義された材料に対してより頻繁に使用されます。この種のモデルは、固定次元の特徴ベクトルを用いて合金の種類や閾値を分類するのに有効です。温度依存性の特性も非線形パターンに従うことが多く、組成、加工履歴、環境条件に依存するため、決定木ベースの手法やSVMが効果的に捉えています。
微細構造のような構造的特徴に対しては、アンサンブルモデルを用いて複雑な画像から特徴を特定し、結晶粒界、相、欠陥を分類し、結晶構造を予測します。これらは多くの場合、対称性を考慮したモデルを必要とする分類問題として扱われます。原子スケールからマクロスケールに及ぶ表面特性には、表面エネルギーや反応性における複雑なパターンが含まれます。これらの応用には、画像データの前処理、マルチスケール特徴量の抽出、対称性や周期性のエンコーディングが必要であり、特に触媒、腐食、接着の研究では分子モデリングとの統合が求められます。
応用分野は大幅に拡大しており、特に電池研究の成長が著しい状況です。図9Aおよび9Bは、RFが電気化学プロセスと強く相関していることを裏付けており、電池容量の予測、電極材料の選定、時間依存プロセスにおける複雑な相互作用の処理に活用されています。
2020年から2024年にかけてエネルギー関連の応用(エネルギー貯蔵、発電)が出現したことは、この分野の多様化を示しています。長短期記憶(LSTM)は、電池の劣化予測やサイクル性能予測に不可欠な時間的ダイナミクスを捉えます。もう一つの新たな相関として、充電プロトコルや材料使用の最適化が可能で、バッテリー管理システムに利用できる強化学習(RL)が挙げられます。また、電池や二次電池に関連してカルマンフィルタも確認されており、加工中の材料状態の追跡や、電池の健全性評価および残寿命予測に用いられています。
Transformerは、科学文献から合成手順や材料特性を抽出したり、複雑な材料記述における長距離依存関係を捉えたりするために使用されています。畳み込みニューラルネットワーク(CNN)やGANは、2D/3D構造からの特徴抽出を自動化し、特性予測やパターン認識を支援します。これらは強力ですが、より多くのデータと計算量を必要とし、解釈性が低いため、従来のモデルを置き換えるのではなく補完する役割を果たしています。ニューラルネットワークは画像ベースの分析や生成設計にますます利用される一方、従来のモデルはデータセットが限られた組成と特性のマッピングにおいて優位性を維持しています。これが、ニューラルネットワークと従来のモデルが組み合わせて使用される理由の一つです。また、対称性や物理的制約を組み込んだ材料特有のCNNアーキテクチャの開発や、原子・分子構造に対するGNNの活用も進んでいます。
材料科学における物質
CASに登録された物質の分類に戻り、材料科学におけるこれらの物質に関連する論文数を分析しました(図10を参照)。

AI主導の研究において有機・無機小分子が優勢であることは、ポリマーのようなより大きな複雑なシステムと比較して、計算コストの面で小規模な構造を扱う際の計算上の利点とデータの豊富さを反映しています。約6,500件の学術論文を誇るこのカテゴリーは、数十年にわたって蓄積された化学データベースの恩恵を受けています。
小分子は、分子記述子、フィンガープリント、グラフベースの表現を用いて特性を効果的にエンコードできるため、機械学習アプローチに特に適しています。この分野における研究の多さは、創薬、触媒設計、分子特性予測に対する製薬・化学業界のAIへの強力な投資も示しています。
元素は、約5,500件の論文で2位にランクされており、同様に広範なデータベースと構造の相対的な単純さから恩恵を受けており、AI主導の特性予測や材料発見に理想的な候補となっています。
表形式の無機材料は、約4,500件の学術論文があり、AIが大きな応用を見出しているもう一つの分野です。セラミックス、酸化物、その他の構造化された無機化合物を含むこれらの材料は、結晶データベースや体系的な特性測定の恩恵を受けており、効果的な機械学習に必要な大規模データセットを提供しています。これらの材料の構造化された性質により、結晶構造、組成、結合特性に基づいた一貫した特徴量エンジニアリングが可能になります。このカテゴリーがAI研究で目立つのは、エネルギー貯蔵、触媒、電子・磁気応用向けの新しい機能性材料の発見に材料科学コミュニティが注力していることを反映していると考えられます。
ポリマー研究におけるAIの採用は、約1,800件の学術論文と中程度にとどまっており、ポリマーの産業的重要性を考えると少なく見えるかもしれません。これは、複雑な鎖構造、分子量分布、加工に依存する特性など、ポリマーがAI応用に対して提示する特有の課題を反映している可能性があります。しかし、研究量の増加は、ポリマーの特性予測、合成、加工最適化へのAI適用が成功を収めつつあることを示唆しています。
我々の分析から得られたもう一つの重要な知見は、すべての材料科学カテゴリーにおいて、特許ファミリーが学術論文のわずかな割合しか占めていないという点です。雑誌論文と特許の数の乖離は、材料科学におけるAI研究の多くが依然として基礎的または探索的な段階にあり、学術的な発見から商業段階で特許保護に値する実用的な応用までには、かなりのタイムラグがあることを示唆しています。
特許数が比較的少ないことは、AI主導の材料発見を商業的に実行可能な技術に変換することの難しさを反映している可能性もあります。この分野における多くのAI応用は、直ちに特許取得可能な発明よりも、特性予測や基礎的な理解に焦点を当てているためです。材料の種類を問わず一貫した比率であることは、学術から商業への橋渡しという課題が特定の材料クラスに限られたものではなく、材料科学全体に共通するものであることを示しています。
プロセス管理におけるAI
AIは、よりスマートで迅速、かつ適応性の高い意思決定を可能にすることで、プロセス管理を変革しています。この領域におけるAIの役割を分析すると、自動化、予測分析、リアルタイム最適化が、いかにして業界全体の卓越したオペレーションを推進できるかが明らかになります(図11を参照)。

AIを活用した最適化は、積層造形、石油化学産業、プラスチック加工、冶金、フロー化学、触媒プロセス、創薬・合成などの分野で広く利用されています。一般的に使用されるモデルには、応答曲面法(RSM)、実験計画法に加え、ANN、ハイブリッドモデル、PINN、LLM、強化学習などの機械学習手法があります。予測モデリングをリアルタイムの意思決定や自動化へと拡張している他の技術についても見ていきましょう。
- リアルタイムモニタリング:これらのシステムは、機械学習を用いてストリーミングデータを分析し、パターン、傾向、早期警告の兆候を検出することで、動的な予測とプロアクティブな意思決定を促進します。主なイノベーションには、リアルタイムの入力に基づいてパラメータが自動調整される自律的な意思決定、故障が発生する前に予兆を捉える予知保全、変化する状況に適応する自己改善型モデルなどがあります。さらに、リアルタイムのデータ可視化やインテリジェントなアラートシステムは、オペレーターがライブのプロセスデータと対話する方法を変革しています。これらの進歩は、自動クロマトグラフィーシステムや医薬品製造における薬物反応モニタリングなどの業界で応用されています。また、ポリマー製造における特性最適化、廃棄物管理における固形廃棄物分析、環境モニタリング、大規模な水素製造のためのエネルギー・リソース管理、老朽化したインフラのためのクラウドベースのエネルギー管理などでも活用が進んでいます。
- ソフトセンサー:物理センサーからのリアルタイムデータを使用し、AIや統計モデルを活用して、直接測定が困難またはコストのかかる変数を推定します。これらは、バイオプロセスモニタリングや廃水・大気質の監視など、さまざまな業界で広く応用されています。化学プロセス制御においては、複雑な硫化鉱石の浮選、異性化、反応蒸留、ガソリンブレンドの監視に使用されています。
- デジタルツイン:これらのイノベーションは物理システムの仮想レプリカであり、AIとの統合により急速に進化し、リアルタイムの最適化、予測分析、自律的な運用を可能にしています。AIは、過去およびリアルタイムのデータから学習して将来の状態をシミュレートし、異常を検出し、故障を予測することでデジタルツインを強化し、静的なモデルから回復力のある自己最適化システムへと変貌させています。製造業では、AI駆動のデジタルツインがセンサーや画像を使用して機器の故障を予測し、生産プロセスを最適化し、品質問題を検出します。ヘルスケア分野では、患者の状態をシミュレートし、個別化医療を支援し、疾患のモデル化や臨床試験のシミュレーション、免疫療法の最適化を行います。環境・持続可能性の領域では、地質学的炭素貯留、鉱石廃棄物処理、リソース管理に応用されています。また、材料科学も支援しており、自動化された発見、欠陥分析、逆分子設計を可能にしています。
科学研究におけるAI活用の課題
AIはあらゆる科学研究分野に多くの貢献をしており、今後もその進化とともに貢献し続けることは明らかです。しかし、これらのイノベーションには課題もあり、研究者やデータサイエンティストは、AIが科学においてその可能性を最大限に発揮できるよう、これらの課題に対処しなければなりません。最も差し迫った課題には以下のようなものがあります。
- データプライバシーとセキュリティ:AIの実装において、学習や運用のために大量の機密データを必要とするため、データプライバシーとセキュリティの確保は最大の課題の一つです。適切な許可なく機密情報が収集・使用されたり、AIシステムから機密情報が漏洩・盗難されたりすると問題が発生します。科学データセットには、未発表の実験結果、新規化合物の構造、重要な競争優位性をもたらす独自の合成方法が含まれている可能性があります。研究者がクラウドベースのAIプラットフォームを利用したり、共同研究環境に参加したりする場合、知的財産が露呈する重大なリスクに直面します。このリスクに対抗するため、一部の企業は顧客情報を保護し信頼を維持するための安全策を講じており、新しいスタートアップ企業が外部のAI脅威から保護するための市場ニッチを見出しています。finding市場ニッチを見出しています。
- データの品質とバイアス:データセットには体系的なバイアスが含まれていることが多く、それがAIモデルを通じて伝播し、予測の歪みを生じさせ、既存の研究における不平等を助長する可能性があります。成功した反応が過大評価され、失敗した実験が報告されないという、公開された反応データにおける歴史的なバイアスは、特に無機材料において、機械学習モデルが新しい化学空間を探索する能力を著しく損なう可能性があります。この「出版バイアス」は、AIシステムがすでに十分に研究されている化合物と類似したものを優先的に推奨するという、自己強化的なサイクルを生み出します。生成AIモデルは、既存のデータを操作したり、実際の証拠を犠牲にして顧客の要求を満たすためにハルシネーション(もっともらしい嘘)を起こしたりする可能性があるため、さらなる懸念をもたらしています。
- 透明性:これらのモデルの「ブラックボックス」的な性質は、予測の背後にある論理を不明瞭にし、研究者がその信頼性を評価したり、潜在的な故障モードを特定したりすることを困難にします。創薬における説明可能なAI手法のレビューでは、複雑なモデルの解釈可能性の欠如が、創薬化学者の信頼を損ない、医薬品開発におけるAI主導の意思決定に対する規制当局の承認を妨げる可能性があることが指摘されました。この課題は、高次元の化学表現を扱うグラフニューラルネットワークやトランスフォーマーモデルにおいて特に深刻であり、入力特徴量と予測の関係が高度に非線形になります。
- 自動化と人間の専門知識のバランス:AIシステムは膨大なデータセットを処理し、人間の認知能力を超えたパターンを特定できますが、経験豊富な科学者が研究課題にもたらす直感、創造性、文脈的理解が欠けています。これにより、基本的な研究スキルや概念的理解を欠いた科学者が生まれる可能性があります。逆に、AI主導の結論が直感と矛盾する場合、「アルゴリズム嫌悪」につながることもあります。
AIモデルと科学研究の未来
科学的探究においてAIの重要性は高まる一方であり、その革新的な能力はすでに生物医学や材料科学などの分野で実現されています。CAS Content Collectionの分析が示すように、困難な研究課題に対して新しいアプリケーション、モデル、手法が絶えず適用されています。創薬、疾患診断、材料開発などにおけるブレイクスルーは、AIを活用した技術によって影響を受けるか、あるいは完全に推進されることが期待されます。
AIがツールから科学的パートナーへと移行するにつれ、逆設計や自律型ラボのような新しいパラダイムが、自律的な発見エンジンへと科学的方法論を再定義していくでしょう。しかし、特許と論文の比率が低いことは、特に従来の材料科学分野において、多くの研究が依然として学術界にとどまっていることを示しています。
AIのさらなる導入には、不確実性の定量化やモデルの透明性といった技術的解決策を通じた適切な信頼の調整が必要です。AIが科学に与える影響の広範さと、それを実装する際の課題の範囲を考えると、科学の進歩のためにその利益を最大化するには、コラボレーションと可視性が鍵となります。
詳細については、当社の転載ジャーナル記事「The AI Revolution in Chemistry: Shaping the Future of Materials and Biomedical Sciences(化学におけるAI革命:材料科学と生物医学の未来を形作る)」をご覧ください。
本書におけるブランド名や第三者の製品・サービスへの言及は、教育目的のみを意図したものであり、CASまたは米国化学会による推奨、あるいは言及されていない類似のブランド、製品、サービスに対する差別を意味するものではありません。


