

요약
현대 과학 연구 환경에서 인공지능(AI)은 연구자가 연구를 구상하고 수행하며 검증하는 방식을 근본적으로 바꾸는 혁신적인 동력으로 부상했습니다. 컴퓨팅 성능, 고급 알고리즘, 방대한 데이터셋의 융합은 AI를 이론적 가능성의 영역에서 과학 전 분야에 걸친 실질적인 필수 요소로 발전시켰습니다.
이러한 혁명은 그동안 과학적 진보를 가로막았던 여러 고질적인 과제들을 해결하고 있습니다. 유전체학, 의학, 재료 과학과 같은 분야에서 생성되는 압도적인 데이터 양, 신약 개발과 같은 과정에 소요되는 막대한 시간과 비용, 그리고 가설 생성에 있어 인간이 가진 인지적 한계 등이 그것입니다. AI는 이러한 난관을 극복하고 다양한 과학 분야에서 더 빠른 돌파구를 찾을 수 있는 새롭고 유망한 경로를 제시합니다.
예를 들어, 생물의학 분야에서 AI는 단백질 구조 예측을 혁신하고 신약 개발 과정을 가속화했으며, 맞춤형 의학을 가능하게 했습니다. 마찬가지로 재료 과학 분야에서도 AI는 신소재 발견을 앞당기고 있습니다. 이러한 발전은 과학적 방법론 자체를 변화시키는 자율 주행 실험실과 역설계 프레임워크의 기반을 마련했습니다. 또한 AI는 실험의 실시간 조정을 가능하게 하여 수율과 효율성을 높이고 낭비와 비용을 줄임으로써 공정 최적화 분야에서도 상당한 진전을 이루었습니다.
저희는 과학적 발견에 대한 이러한 기술적 발전의 적용과 영향을 이해하기 위해 인간이 직접 큐레이션한 최대 규모의 과학 정보 저장소인 CAS Content CollectionTM에 대한 정량적 분석을 수행했습니다. 2015년부터 2025년까지의 CAS Content Collection에 수록된 31만 건 이상의 학술 논문과 특허를 체계적으로 분석했으며, 고급 분석 기법을 활용하여 AI 관련 출판물과 그에 따른 방법론, 기관, 연구 분야를 식별했습니다.
본 연구는 과학 분야 전반에 걸친 AI 방법론의 분포를 탐구하며, 생물의학 및 재료 과학이라는 두 가지 핵심 분야에 대한 심층 분석을 제공합니다. 이러한 분석은 주요 개념, AI 방법론의 동시 발생 패턴, 주목할 만한 물질 분류를 상세히 다룹니다. 또한 산업 공정 최적화 및 신흥 응용 분야에서 AI의 역할을 조사합니다.
이러한 결과는 과학 연구에서 AI 통합의 현주소와 향후 궤적에 대한 필수적인 통찰력을 제공합니다. 이는 연구자, 기관, 정책 입안자들이 기술 도입 패턴을 이해하고, 협력 기회를 포착하며, 향후 AI 투자 및 연구 방향에 대해 정보에 입각한 전략적 결정을 내리는 데 귀중한 지침이 될 것입니다.
과학 분야 AI 모델의 지형도
특정 모델이 선택되는 맥락과 그 영향을 이해하기 위해, AI 기반 방법론을 통합한 학술지 및 특허 패밀리를 포함한 과학 출판물에 대한 포괄적인 분석을 수행했습니다. 전체 지형도를 시각화한 결과, 더 많은 모델과 기능이 개발됨에 따라 과학 분야 전반에 걸쳐 이러한 기술의 통합이 가속화되고 있음을 확인할 수 있습니다(그림 1 참조).

이 시각화 자료의 주요 분류는 다음과 같습니다:
분류, 회귀 및 클러스터링 모델
분류 모델은 이산적인 라벨이나 범주를 예측하도록 설계되었으며, 고차원 데이터를 처리하고 해석 가능한 결과를 제공하는 데 특히 효과적입니다. 일반적인 모델로는 데이터를 재귀적으로 분할하여 결과를 분류하는 의사결정나무(DT)가 있습니다. 랜덤 포레스트(RF)는 의사결정나무의 앙상블로, 예측값을 평균화하여 과적합을 줄입니다. 또 다른 일반적인 모델인 서포트 벡터 머신(SVM)은 클래스 간의 최적 경계를 찾으며, K-최근접 이웃(KNN)은 가장 가까운 이웃의 다수 클래스를 기준으로 분류합니다.
이 모델들은 분광학, 현미경 검사, 또는 알려진 클래스를 가진 오믹스 데이터와 같이 범주형 결과를 도출하는 레이블이 지정된 데이터 세트(지도 학습)에 널리 적용됩니다. 주요 활용 사례로는 유전자 발현이나 영상 데이터를 통한 질병 유형 분류, 재료 등급 예측, 독성이나 반응성에 따른 화합물 분류 등이 있습니다.
회귀 모델은 연속적인 수치 값을 예측하므로 예측 및 최적화에 이상적입니다. 문헌에서 관찰되는 회귀 모델로는 선형 회귀, 로지스틱 회귀, 서포트 벡터 회귀(SVR), 기호 회귀 등이 있습니다. 이러한 모델은 실험, 시뮬레이션에서 얻은 수치 데이터나 센서 및 기기에서 수집된 시계열 데이터에 적합합니다. 활용 분야로는 에너지 준위, 붕괴율 또는 입자 궤적 예측, 반응 수율 추정, 분자 특성, 온도 및 강수량 모델링, 전도도, 경도 및 밴드갭 예측 등이 있습니다.
분류 및 회귀와 달리 클러스터링 모델은 레이블이 없는 데이터에서 자연스러운 그룹화를 찾아내어 숨겨진 구조를 밝히고 탐색적 분석(비지도 학습)을 지원합니다. 이 모델들은 영상, 분광, 분자 데이터와 같은 고차원의 레이블이 없는 데이터 세트에 효과적입니다. 이 그룹에 적합한 과학 데이터로는 발현 프로파일을 기반으로 한 유전자나 샘플 그룹화, 구조 데이터를 통한 새로운 재료군 발견 등이 포함되지만 이에 국한되지는 않습니다.
인공 신경망(ANN)
인공 신경망(ANN)은 상호 연결된 인공 뉴런 층을 통해 복잡한 패턴을 학습하도록 설계된 머신러닝(ML) 모델의 한 종류입니다. 데이터 내의 복잡하고 비선형적인 관계를 모델링하는 데 강력한 성능을 발휘합니다. 그 결과, 딥러닝의 기반이 되었으며 순차 데이터 처리를 위한 순환 신경망(RNN), 장기 의존성을 더 잘 포착하는 향상된 RNN인 장단기 메모리(LSTM), 그리고 매개변수가 적은 LSTM의 간소화 버전인 게이트 순환 유닛(GRU)과 같은 특수 아키텍처를 갖춘 현대 AI의 토대가 되었습니다.
이 모델들은 유전자 발현, 단백질 서열, 생체 신호, 기후 데이터, 입자 물리학, 센서 네트워크 데이터와 같은 시퀀스 및 시계열 데이터에 적합합니다. 이들은 도메인별 개념과 그 관계를 구조적으로 표현한 지식 맵을 활용하여 시각적 데이터(의료 영상 등)와 텍스트 설명(임상 기록이나 진단 보고서 등) 사이의 의미적 간극을 메움으로써 이미지-텍스트 정렬을 향상시키는 경우가 많습니다. 이들의 도입은 신약 발견 및 개발, 정밀 의료, 의료 영상, 재료 발견 및 설계, 에너지 저장, 제조 및 품질 관리 분야에서 급증하고 있습니다.
하이브리드 방식
ANN과 분류, 회귀, 클러스터링과 같은 기존 ML 모델 간의 비교는 어느 것이 더 나은가의 문제가 아니라, 이들이 가진 상호 보완적인 역할을 이해하는 것입니다. ANN은 데이터가 복잡하고 비정형적이며, 대규모 학습 데이터 세트가 존재하고, 표현 학습이 필요한 경우에 압도적인 성능을 보입니다. 반대로 기존 ML은 데이터 규모가 작고, 연구 문제에 엄격한 해석 가능성이 요구되며, 입력 데이터가 잘 알려진 통계적 관계를 가지고 있고 불확실성 정량화가 필요한 경우에 여전히 강력한 강점을 가집니다.
도메인 특화 모델
도메인 특화 모델은 관련 문헌 수는 적지만, 단백질 구조 예측에서 실험적 정확도에 근접한 성과를 거둔 딥러닝 접근 방식인 AlphaFold와 같은 획기적인 연구를 포함합니다. ESMFold는 단백질 언어 모델링을 직접 활용하여 단일 단백질 서열로부터 고품질 구조 예측을 생성하는 또 다른 흥미로운 모델입니다.
자연어 처리(NLP)
NLP는 인간의 언어를 분석, 이해, 해석 및 생성하는 데 사용됩니다. 여기에는 알고리즘이 처리할 수 있는 토큰(일반적으로 단어나 하위 단어)이라는 더 작은 단위로 텍스트를 분해하는 토큰화와 같은 작업이 포함됩니다. 텍스트를 표현하는 일반적인 방법으로는 문법과 단어 순서를 무시하고 단어 빈도를 기반으로 텍스트를 수치 벡터로 변환하는 Bag of Words(BoW) 모델이 있습니다. 또 다른 핵심 기술은 텍스트 내에서 사람, 조직, 위치와 같은 개체를 식별하고 분류하는 개체명 인식(NER)입니다.
생물의학 문헌을 사전 학습한 특화 언어 모델(BioBERT, BioGPT 등)과 전자 건강 기록(EHR) 분석부터 임상 기록에서 질병 특성을 자동 추출하고 언어 모델을 사용하여 새로운 후보 약물을 생성하는 것에 이르기까지, 생물의학 텍스트 마이닝 및 지식 추출 분야에서 NLP 모델의 광범위한 활용이 이루어지고 있습니다. 재료 과학 및 화학 분야에서 NLP는 합성 프로토콜 추출, 재료 특성 예측, 지식 베이스 구축 및 역설계에 사용되어 왔습니다.
거대 언어 모델(LLM)
이 혁신적인 AI 시스템 계열은 NLP를 완전히 바꾸어 놓았으며 과학 분야 전반에 걸쳐 광범위하게 적용되고 있습니다. LLM은 방대한 양의 텍스트 데이터를 학습하여 언어의 통계적 패턴을 익히는 신경망 기반 시스템입니다. 이들은 정보 추출, 요약, 지식 그래프 구축, 도메인 간 통합 및 생성형 애플리케이션에 사용됩니다.
널리 채택된 LLM으로는 ChatGPT, GPT-3.5, GPT-4를 구동하는 생성형 사전 학습 트랜스포머(GPT)가 있습니다. BERT(Bidirectional Encoder Representations from Transformers)는 양방향 문맥 이해와 질의응답 및 감성 분석에서의 뛰어난 성능으로 인해 여전히 학계의 높은 관심을 받고 있는 최고의 언어 모델입니다.
다국어 모델인 BLOOM은 연구 환경에서 중요한 기여자로 부상했습니다. Google DeepMind가 개발한 GEMINI, Meta AI의 LLAMA, Anthropic이 개발한 Claude와 같은 새로운 모델들도 인기를 얻고 있습니다. 2023년에서 2025년 사이에 출시된 Gemma, Falcon, Mistral, Qwen, DeepSeek와 같은 최신 세대 모델들은 향후 발전에 큰 가능성을 보여주고 있습니다.
chemLLM, PharmaGPT, MatSciBERT와 같이 화학, 생명 과학 및 재료 과학을 위한 여러 특화 LLM들도 영향력을 발휘하고 있습니다.
과학에 미치는 AI의 영향력을 보여주는 출판 동향
앞서 언급했듯이, 당사는 2015년부터 2025년까지 과학 연구 분야의 AI와 관련된 CAS 콘텐츠 컬렉션의 31만 건의 문서를 분석했습니다. 전체 기간 동안 꾸준한 성장을 확인했으며, 특히 최근 5년간 두드러진 성장을 보였습니다(그림 2 참조). 특허 패밀리 수의 증가는 AI가 신흥 기술에서 다양한 산업 전반에 걸친 필수적인 연구 도구로 진화하고 있음을 시사합니다.

- 국가/지역 및 기관별 분포: 중국이 출판물(학술지 및 특허) 수에서 선두를 달리고 있으며, 미국, 인도, 한국, 일본 또한 꾸준한 출판물 증가세를 보이고 있음(그림 3 참조). 전반적으로 이 데이터는 아시아가 글로벌 AI 과학 혁신의 새로운 중심지로 부상하고 있으며, 서구권 국가들은 양적 산출 측면에서 뒤처지고 있음을 보여줌.

- 특허 패밀리 분포: 상위 5개국의 학술지 및 특허 출판 추이를 추가로 분석함. 중국과 인도는 이 분야 전 세계 특허의 75% 이상을 차지하며, 특허 출원 수 기준 상위 15개 기관은 모두 중국과 인도에 속함. 중국 대학들은 학술지 출판물 수에서 압도적이며, 대부분의 평균 피인용 수는 10~20회 사이임. 반면, MIT와 스탠퍼드 대학은 각각 32회와 66회라는 월등히 높은 평균 피인용 수를 기록함. 이는 중국이 양적으로는 뛰어나지만, AI 분야 학술지 논문의 질과 영향력 측면에서는 미국 대학들이 앞서고 있음을 시사함.
- 주요 출판물 분포: AI 기반 연구를 출판하는 주요 과학 학술지의 출판물 수와 피인용 영향력을 분석함. 출판물 수는 Scientific Reports, Applied Sciences 및 PLoS One이 주도함. 그러나 논문당 평균 피인용 수를 고려할 때, Proceedings of the National Academy of Sciences (PNAS) 가 상대적으로 적은 출판물 수에도 불구하고 논문당 약 50회의 피인용을 기록하며 탁월한 영향력을 입증함. Journal of Chemical Information and Modelling (JCIM), Bioinformatics, 및 Nature Communications와 같은 다른 학술지들 또한 방대한 출판물을 내는 학술지들을 크게 앞지르는 놀라운 평균 피인용 수를 보여줌. 이러한 패턴은 Scientific Reports 와 같이 광범위한 주제를 다루는 학술지가 가장 많은 AI 관련 연구를 출판하는 반면, PNAS, JCIM 및 Nature Communications와 같은 전문적이고 권위 있는 학술지들이 더 큰 과학적 영향력을 창출하는 영향력 있는 연구를 출판하고 있음을 시사함.
- 과학 분야별 추이: 수많은 분야가 AI의 큰 영향을 받았으나, 그중에서도 출판물이 기하급수적으로 증가한 몇몇 분야가 두드러짐(그림 4 참조):

모든 학문 분야 중 산업 화학 및 화학 공학은 학술지 출판물에서 가장 극적인 성장을 보였으며, 2024년에는 전체 문서의 약 8%에 달하는 궤적을 기록함. 이러한 이례적인 성장은 제조, 공정 최적화, 산업 혁신 전반에 걸친 이 분야의 광범위한 응용과 더불어 지속 가능한 산업 공정 및 친환경 화학 솔루션 개발에서의 핵심적인 역할을 반영함.
분석 화학은 학술지 출판물 측면에서 두 번째로 빠르게 성장하는 분야로 부상했으며, 2019년 이후 진한 파란색 선이 강력한 성장세를 나타냄. 이러한 강력한 성장 패턴은 화학의 모든 영역에서 이 분야가 갖는 근본적인 중요성과, 여러 학문 분야의 연구를 뒷받침하는 새로운 측정 기술, 계측기 및 분석 방법 개발에서의 역할을 보여줌.
에너지 기술 및 환경 화학은 견고한 성장세를 보이며 생화학과 함께 가장 빠르게 성장하는 분야 3위에 공동으로 이름을 올림. 이는 기후 변화, 환경 지속 가능성 과제 및 최근의 사건들에 대한 전 세계적인 긴급한 관심을 반영함.
물리 화학, 약리학, 독성학 및 제약학, 유기 화학, 무기 화학, 천연물 및 합성 고분자를 포함한 나머지 분야들은 모두 완만하지만 일관된 출판물 증가세를 보임. 이 분야들은 기본 원리가 잘 확립된 성숙한 과학 연구 영역이지만, 지속적인 연구를 통해 점진적인 발전과 개선이 이루어지고 있음.
특허 패밀리 데이터는 학술지 출판물과는 확연히 다른 양상을 보이며, 학술적 성과에서 나타나는 균일한 성장과는 달리 매우 다양하고 집중된 혁신 패턴을 보여줌. 이러한 대조는 학술 연구 생산성과 상업적으로 실행 가능한 혁신 사이의 근본적인 차이를 강조하며, 시장의 힘, 실용적 응용 및 경제적 인센티브가 어떤 과학적 진보가 특허 가능한 지식 재산으로 전환될지를 결정하는 데 결정적인 역할을 함을 보여줌.
특허 분야에서 생화학은 기하급수적인 성장을 보이며 2024년에는 약 8%에 도달하여 다른 모든 분야를 압도함. 생화학 특허 환경은 생물의학적 방법이 주도하며 분자 과학과 첨단 헬스케어 기술을 융합한 혁신에 의해 형성됨. 주요 영역으로는 생화학적 표지자를 활용하는 질병 탐지, 의료 영상, 웨어러블 모니터링 및 임상 의사결정 지원 등이 있음. 또한 생화학은 신경 인터페이스, 유전체학, 바이오마커 발견, 신호 처리, 수술 안내 및 생물의학 제조 분야의 발전을 견인하며 현대 생물의학 혁신의 중심 역할을 함. 이러한 극적인 특허 활동은 생명 과학 연구 전반에 대한 강렬한 상업적 관심과 투자를 반영하며, 특히 상업적 연구에 상당한 자금이 지원되었던 코로나 팬데믹에 대응하여 더욱 촉진됨.
분석 결과, AI 관련 출판물의 대다수가 생물의학 연구 및 재료 과학과 관련이 있음을 확인함. 따라서 이 분야들이 데이터셋을 지배하고, 주목할 만한 연간 성장률과 함께 빠른 AI 도입을 보이며, 과학적 관련성을 나타내는 더 높은 피인용 영향력을 산출함에 따라 이 핵심 연구 분야들에 대한 심층 분석을 수행함.
생물의학 연구에서의 AI 모델 응용
개요
생물의학 연구는 그동안 AI로 해결할 수 있는 복잡성과 비용 문제에 직면해 왔음. 예를 들어, 복잡한 단백질 구조와 상호작용 해독, 신약 개발과 관련된 높은 비용과 실패율, 다요인 질병 메커니즘 이해의 복잡성 등은 모두 AI 기반 접근 방식에 적합한 과제들임.
AI 기반 과학 연구를 위한 데이터 무결성. 데이터에 대한 AI의 역량과 계산 속도는 인간의 능력을 능가하며, 이 기술은 앞으로도 가능한 것의 범위를 계속해서 재정의할 것임. 그러나 데이터 무결성과 조화는 과학 분야에서 AI를 성공적으로 적용하기 위한 핵심 요소임.
본 분석의 근거는 문서 빈도를 객관적인 지표로 사용하여 핵심 개념을 식별함으로써 가장 중요한 연구 영역을 대표적으로 샘플링하는 것이었음. 구체적으로, 생물의학 분야 내에서 여러 AI/ML 방법을 사용하여 상당한 과학적 관심과 연구 투자를 유발한 개념들을 식별함(그림 5 참조).

In the Biochemistry domain, protein sequences and structures, gene and gene expression and DNA/genomics have emerged as the most extensively studied concepts, utilizing diverse machine learning approaches. ML models thrive in these areas due to data abundance and standardization, especially in complex systems like protein hierarchies and gene regulatory networks. ML excels in tasks such as sequence-function mapping, protein family classification, domain prediction, structure-function analysis, tumor feature selection, gene interaction prediction in cancer, and clustering genes by expression in patterns in oncology, leveraging high-dimensional expression data with thousands of genes measured simultaneously, complex non-linear relationships between genes and phenotypes, and hierarchical organization of genetic regulatory networks.
AlphaFold 및 BERT와 같은 고급 머신러닝 모델은 아미노산 서열과 진화 패턴을 학습하여 3D 폴딩 및 기능적 도메인을 예측하는 단백질 구조 예측에 사용됩니다. 이러한 모델은 복잡한 공간 관계와 장기 의존성을 가진 순차적 입력을 효과적으로 처리합니다.
모델링 및 약물 설계 분야에서는 QSAR 모델링이 주를 이룹니다. 이 분야는 머신러닝 기법을 활용하여 화학 구조로부터 분자 기술자(예: 물리화학적 특성, 지문)를 추출하고, 지도 학습 접근 방식을 통해 생물학적 활성 및 독성 종말점을 예측합니다. 이러한 기법은 풍부한 분자 기술자, 구조-활성 관계, 회귀 작업에 적합한 정량적 종말점을 다룰 때 뛰어난 성능을 보입니다.
두 번째로 빈도가 높은 개념인 분자 도킹은 3D 구조 데이터와 분자 그래프에 딥러닝 접근 방식(CNN 및 GNN)을 사용하여 단백질-리간드 결합 자세와 친화도를 예측하며, 공간적 형태, 에너지 지형, 분자 상호작용을 활용합니다. 그 다음으로 중요한 분야는 약동학으로, 머신러닝을 사용하여 분자 기술자, 생리학적 매개변수, 시계열 데이터를 학습함으로써 ADMET 특성(흡수, 분포, 대사, 배설, 독성) 및 약물 청소율을 예측합니다.
Biomarkers dominate the Diagnostic domain where ML methods analyze high-dimensional genomics, proteomics, and metabolomics data to identify discriminative molecular signatures distinguishing disease states from healthy controls through feature selection and classification. AI methods are also used in prognosis research to analyze patient clinical data and treatment history for predicting survival times and disease progression through survival analysis techniques.
의료 영상에는 X-레이, CT, MRI 데이터와 딥러닝 기법에 이상적인 구조화된 공간 정보가 포함되어 있습니다. CNN은 자동화된 패턴 인식을 통해 종양 탐지, 골절 식별, 질병 분류 및 병리학적 상태를 파악하기 위한 방사선 영상 분석에 널리 사용됩니다. 영상 분석은 딥러닝의 다중 스케일 특징 추출 및 분할 작업 수행 능력을 통해 혜택을 얻을 수 있으며, 특히 암 진단 분야에서 종양 탐지, 분류, 악성도 평가 및 위험 예측을 지원합니다.
질병 분야에서는 암 연구가 가장 큰 주목을 받았으며, 데이터 유형에 따라 다양한 머신러닝 모델이 적용되었습니다. 유전체 및 전사체 데이터는 일반적으로 RF 및 SVM 모델을 사용하여 암 아형 분류 및 치료 예측을 위해 분석됩니다. 이러한 작업은 다양한 분자 층을 포착하는 다중 오믹스 데이터를 통합하고, 이질적인 종양 미세환경의 복잡성을 모델링함으로써 효과를 얻습니다.
당뇨병 연구에서는 종단적 모니터링 데이터, 생활 습관 요인과 유전학 간의 복잡한 상호작용, 혈당 수치에 대한 시계열 예측 문제를 활용하여 당뇨병 합병증을 예측하고 치료 프로토콜을 최적화하기 위해 다양한 알고리즘이 사용됩니다. 알츠하이머병 연구에서는 신경심리학적 검사 점수, 바이오마커 수치(아밀로이드-베타, 타우 단백질), 인구통계학적 데이터를 분석하여 환자를 건강한 그룹 또는 경도 인지 장애 그룹으로 분류하는 초기 예측에 RF 및 SVM 모델이 널리 사용됩니다.
In the Therapy domain, antitumor agents received the most research attention, employing ML methods for drug screening and activity prediction by analyzing molecular descriptors and chemical properties to identify compounds with potential anticancer activity. In chemotherapy, these methods predict treatment responses and toxicity by analyzing patient clinical data, genetic profiles, and tumor characteristics for personalizing drug selection and dosing protocols. Similarly, these models support immunotherapy by analyzing patient immune profiles, tumor mutational burden, and biomarker expressions to predict response and optimize therapeutic outcomes, addressing the complexity of immune interactions and temporal dynamics.
AI 모델과 생의학 개념의 동시 발생
본 분석은 생의학 개념과 다양한 AI/머신러닝 기법 간의 동시 발생 패턴을 탐구하여 5개 분야 전반에 걸친 전략적 적용 사례를 명확히 설명합니다(그림 6 참조).


랜덤 포레스트(RF)는 생의학 연구에서 지배적인 AI 기법으로 부상했으며, 두 기간 사이에 놀라운 성장을 보이며 서포트 벡터 머신(SVM)을 앞질렀습니다. RF는 생의학 과학의 모든 분야, 특히 생화학, 진단 및 질병 관련 연구 전반에 걸쳐 개념들과 강력한 동시 발생을 보입니다. RF는 아미노산 조성, 서열 모티프, 물리화학적 특성을 분석하여 단백질을 기능적 패밀리로 분류함으로써 단백질 기능 예측 및 분류에 사용됩니다. 바이오마커 발견 분야에서 RF는 고차원 유전체학, 단백질체학, 대사체학 데이터를 분석하는 데 사용됩니다.
서포트 벡터 머신(SVM)은 두 기간 사이에 꾸준히 성장하면서 단백질, 유전자 발현, DNA 및 유전체학, 바이오마커, 예후, 의료 영상, 암 연구 분야에서 중요한 입지를 유지하고 있습니다. 단백질 연구에서 SVM은 아미노산 서열, 구조적 특징, 물리화학적 특성을 분석하여 단백질 분류 및 기능 주석에 사용됩니다. 또한 커널 기반 고차원 특징 공간 매핑을 사용하여 세포 내 위치를 예측하고 효소 클래스를 식별합니다.
유전자 발현 분야에서 SVM은 특정 생화학적 과정에 관여하는 유전자를 식별하고, 대사 경로를 분류하며, 다양한 생화학적 조건과 세포 상태에 걸친 발현 패턴을 기반으로 효소 암호화 유전자를 예측합니다. 유전체 변이 분류를 위해 SVM은 DNA 서열 특징과 주석을 처리하여 병원성 돌연변이와 양성 돌연변이를 구별하고, 뉴클레오타이드 패턴과 유전체 맥락에 대한 고차원 특징 분석을 통해 질병 관련 유전체 영역을 식별합니다.
바이오마커 연구에서 SVM은 진단, 치료 반응, 질병 진행 위험 평가를 위한 예측 모델에 여러 바이오마커를 통합하고 개인 맞춤형 의학 접근 방식을 위해 환자를 계층화함으로써 식별, 분류 및 검증을 지원합니다. SVM은 암 연구에서 암 조직과 정상 조직을 구별하고, 암 유형을 분류하며, 특정 암 내의 분자 아형을 식별하는 데 사용됩니다. 또한 임상 매개변수, 바이오마커 프로필, 유전체 특징을 통합하여 환자의 생존 결과, 치료 반응, 약물 내성 패턴 및 재발 위험을 예측함으로써 암 예후 및 치료 예측에도 사용됩니다. 그림 6B는 SVM이 QSAR 및 SAR 모델링에서 강점을 유지한 반면, 후기에는 RF에 비해 단백질 분석과의 연결성이 약화되었음을 보여줍니다.
로지스틱 회귀(LR)는 생의학 연구에서 널리 사용되는 해석 가능한 통계 기법으로, 단백질, 유전자 발현, 바이오마커, 예후, 의료 영상, 암, 코로나19와 같은 주요 개념과 자주 동시 발생합니다. 단백질 기능 예측에서 LR은 아미노산 조성, 서열 특징, 구조적 특성을 분석하여 단백질을 기능적 또는 구조적 범주로 분류합니다. 이 모델의 핵심 장점은 각 특징이 분류 결정에 기여하는 상대적 비중을 나타내는 해석 가능한 계수를 제공하여, 연구자가 어떤 아미노산 특성이나 구조적 특징이 예측에 가장 큰 영향을 미치는지 파악할 수 있게 한다는 점입니다.
This interpretability is equally valuable in gene expression classification, where LR helps identify differentially expressed genes. For biomarker validation and diagnostics, LR models predict binary outcomes, such as disease/healthy or responder/non-responder and provide clinically meaningful odds ratios for diagnostic decision making. In prognostic modeling, LR uses a similar binary outcome prediction, by evaluating clinical parameters, biomarker profiles, and patient demographics to forecast outcomes like mortality/survival, disease recurrence/remission, favorable/unfavorable prognosis.
LR is used in COVID-19 diagnosis, severity prediction, and mortality by integrating comorbidities, vital signs, and biomarkers, supporting risk stratification and clinical decision-making. These diverse applications underscore LR’s strong alignment with core biomedical research themes, making it a foundational tool for interpretable and clinically relevant modeling. Figure 6B illustrates the increased adaptability of Logistic Regression, likely due to the capability for multi-class classification and probability-based outputs, unlike linear regression, which is limited to continuous predictions.
그림 6B에서 볼 수 있듯이, 2020-2024년 기간에는 이전에는 거의 존재하지 않았던 AlphaFold와 같은 전문화된 딥러닝 접근 방식이 등장했습니다. 또한 이 기간에는 분자 상호작용 모델링을 위한 그래프 신경망(GNN), 합성 데이터 생성을 위한 그래프 생성적 적대 신경망(GAN), 그리고 영상 응용 및 진단 과제를 위한 패턴 인식의 사용이 급증했습니다.
최근 몇 년간 나타난 또 다른 주요 변화는 생물의학 연구에 NLP 기술이 통합된 것으로, 임상 보고서 마이닝 및 생물의학 텍스트 분석을 위한 BERT와 같은 모델의 부상이 이를 잘 보여줍니다. 이러한 전문화는 이 분야가 범용 AI 방법을 적용하는 단계를 넘어 특정 생물의학적 과제를 위한 맞춤형 접근 방식을 개발하는 방향으로 성숙해졌음을 반영합니다.
두 기간 사이의 연구 우선순위는 크게 달라졌습니다. 2020~2024년에는 단백질 서열 및 구조 분석과 유전자 발현 분석이 크게 증가했습니다(그림 6B). 바이오마커 발굴 및 이미징 응용 분야 또한 급격한 성장을 보였으며, 질병별 연구도 상당히 확대되었습니다. 특히 코로나19가 주요 연구 분야로 부상했고 암 연구는 여러 하위 유형으로 다변화되었습니다.
생물의학 연구의 물질
이 비교 분석은 아직 충분히 탐구되지 않은 치료 기회에 대한 전략적 통찰력을 제공하며, 과학적 발견과 임상 적용 사이의 간극을 메우기 위해 더 많은 연구 투자나 혁신적인 접근이 필요한 물질군을 강조합니다(그림 7 참조). "물질군"은 치료적 잠재력을 인정받아 CAS에 색인된 물질 범주를 의미합니다.
저분자 약물은 여전히 제약 연구 개발을 주도하고 있으며, AI 기술이 그 발견을 가속화하고 있습니다. ML 기반 가상 스크리닝, 약동학 예측을 위한 QSAR 모델링, 그리고 합성 경로를 최적화하는 딥러닝 시스템이 이제 이 과정의 필수 요소가 되었습니다. 이러한 혁신은 확립된 합성 경로, 잘 규명된 약동학, 경구 생체 이용률, 비용 효율적인 제조 등 저분자 화합물이 가진 고유한 장점을 기반으로 합니다.
단백질/펩타이드 치료제는 두 번째로 많이 연구된 범주입니다. AlphaFold와 같은 도구는 단백질 구조 예측에 혁신을 가져왔으며, 당뇨병 치료를 위한 인슐린, 뇌졸중 치료를 위한 조직 플라스미노겐 활성제, 암 및 자가면역 질환 치료를 위한 단일클론항체와 같은 치료용 단백질의 설계 및 최적화를 가능하게 했습니다. ML 모델은 단백질-단백질 상호작용을 예측하고 펩타이드 안정성을 최적화함으로써 이 분야를 더욱 발전시키고 있습니다.
염 및 염 화합물은 용해도, 생체 이용률 및 안정성을 예측하는 AI 기반 제형 최적화 알고리즘의 혜택을 받고 있으며, 이는 약물 제형 및 생체 이용률 최적화의 중요성을 반영합니다. 중요한 치료 전달 시스템 역할을 하는 고분자는 AI로 설계된 나노입자 제형, ML로 최적화된 하이드로젤 특성, 그리고 치료 효능과 조직 특이성을 향상시키는 표적 약물 전달을 위한 예측 모델링을 통해 개선되고 있습니다.
배위 화합물은 또 다른 유망한 분야로, AI가 리간드 설계 및 금속-유기 골격체(MOF) 최적화를 지원합니다. 이러한 화합물은 금속-리간드 상호작용과 생물학적 활성을 예측하는 계산 화학 및 AI 모델을 통해 정교화되고 있습니다.
재료 과학 분야의 AI 모델 응용
개요
In materials science, understanding and predicting the complex relationships between material composition, structural features, and properties is essential for accelerating material discovery. The data involved are often multidimensional, hierarchical, heterogeneous, and generated through high-throughput, data-intensive processes. AI, particularly ML, is revolutionizing the field by enabling the analysis of these complex datasets. We analyzed the CAS Content Collection to identify key materials science concepts where AI methods are applied and assessed their significance in materials discovery and property prediction (see Figure 8).

에너지 저장 장치는 응용 분야에서 AI가 가장 활발하게 사용되는 연구 영역으로, 첨단 배터리 기술과 지속 가능한 에너지 솔루션에 대한 전 세계적인 수요를 반영합니다. ML 기술은 배터리 재료 혁신을 위한 강력한 도구가 되었으며, 연구자들은 직접적인 특성 예측, 머신러닝 포텐셜, 역설계라는 세 가지 주요 전략을 활용하고 있습니다. 이 분야에 AI 연구가 집중되는 이유는 배터리 시스템의 복잡한 다중 스케일 특성 때문이며, 기존의 실험적 접근 방식으로는 재료 조성, 구조, 전기화학적 성능 간의 복잡한 관계를 최적화하는 데 한계가 있기 때문입니다.
In the Materials and the Devices categories, the significant AI activity in ceramics, piezoceramics, sensors, and field effect transistors reflects the sophisticated nature of these materials and their devices. These advanced materials often exhibit complex structure-property relationships that are ideal candidates for ML approaches.
In Structural Features, we found that convolutional neural networks (CNNs) along with computer vision are used for microstructural analysis by enabling automated classification, segmentation, and feature extraction from microscopy images. These tools are helping uncover structure-property relationships that were previously difficult to quantify. In metallurgy, targeted AI approaches are advancing superalloy development, while systems like CAMEO (Closed-Loop Autonomous Materials Exploration and Optimization) enable combinatorial metallurgy by integrating AI with high-throughput experimentation. Furthermore, machine learning tools for 3D tomography data are enhancing the analysis of porous materials, allowing for more accurate modeling of properties like permeability and mechanical strength.
유전율과 전기 전도도는 특성 분야에서 선도적인 개념이며, 압전성은 현상 분야를 주도합니다. 시뮬레이션 및 모델링 분야에서는 계산 모델링이 높은 AI 도입률을 보이고 있는데, 이는 데이터 분석 작업에 머신러닝이 자연스럽게 부합하기 때문입니다.
그림 7에서 보라색과 혼합색 영역으로 표시된 중간 정도의 AI 활동 영역은 AI 도입이 가속화되고 있지만 개선의 여지가 있는 분야입니다. 예를 들어, 주로 파란색으로 표시된 일부 재료 분야의 낮은 활동도는 과학의 가장 확립되고 근본적인 영역을 나타내며, 가장 성숙한 분야가 오히려 AI 통합 수준은 가장 낮은 역설적인 상황을 보여줍니다. 복합 재료와 고분자가 이 범주의 대표적인 예입니다.
그러나 특정 과제를 해결하기 위한 전문 AI 모델이 개발되고 있습니다. polyBERT 모델은 고분자 구조를 화학적 언어로 취급하여 복잡한 고분자 시스템을 보다 효과적으로 모델링할 수 있게 합니다. 결정질 재료의 경우, MEGNet, CGCNN, SchNet과 같은 모델은 결정 대칭성과 양자 상호작용을 통합하며, ALIGNN은 정확한 합금 특성 예측에 필수적인 고차 원자 상호작용을 포착합니다.
AI 모델과 재료 과학 개념의 동시 출현
생물의학 분석과 마찬가지로, 재료 과학 분야의 AI 방법론과 관련 개념 간의 상관관계를 면밀히 살펴보았습니다. 그 결과, 재료 정보학에서 흔히 나타나는 비선형 관계를 포함한 고차원 데이터의 특성상 랜덤 포레스트(RF), 서포트 벡터 머신(SVM), 그래디언트 부스팅 머신(GBM), 의사결정 나무(DT)와 같은 전통적인 머신러닝 모델이 예측 및 특성 중요도 분석에 널리 활용되고 있음을 확인했습니다(그림 9 참조).


RF 모델은 모든 개념 영역에 걸쳐 널리 사용되고 있습니다. GBM 모델과 함께, 이들은 비선형 관계를 모델링하고 복합 데이터 유형을 처리하는 능력 덕분에 복잡하고 이질적인 재료와 강한 상관관계를 보입니다. 이러한 모델은 주로 이질적인 복합 재료, 기계적 물성 예측, 그리고 기재와 보강재 간의 복잡한 상호작용을 포착하는 파손 분석에 활용됩니다.
합금 분야에서도 이러한 상관관계가 나타나는데, RF는 합금 조성의 비선형 관계를 매핑하여 고엔트로피 합금 설계, 석출 강화 예측 및 열처리 최적화에 기여합니다. GB는 항복 강도나 내식성 최적화와 같은 정밀한 물성 조정을 위해 점점 더 많이 적용되고 있습니다.
SVM은 구조와 물성 간의 관계가 명확하게 정의된 재료에 더 자주 사용됩니다. 이 모델은 고정 차원의 특성 벡터를 사용하여 합금 유형과 임계값을 분류하는 데 효과적입니다. 온도 의존적 물성 또한 조성, 공정 이력, 환경 조건에 따라 비선형 패턴을 따르는 경우가 많으며, 트리 기반 방법론과 SVM은 이를 효과적으로 포착합니다.
미세 구조와 같은 구조적 특성의 경우, 앙상블 모델을 사용하여 복잡한 이미지에서 특징을 식별하고, 결정립계, 상, 결함을 분류하며, 대칭성을 고려해야 하는 분류 문제로 다루어지는 결정 구조를 예측합니다. 원자 단위에서 거시적 규모에 이르는 표면 물성은 표면 에너지와 반응성의 복잡한 패턴을 포함합니다. 이러한 응용 분야는 이미지 데이터 전처리, 다중 스케일 특징 추출, 대칭성 및 주기성 인코딩을 필요로 하며, 특히 촉매, 부식, 접착 연구에서는 분자 모델링과의 통합이 요구됩니다.
응용 분야는 상당히 확장되었으며, 특히 배터리 연구 분야의 성장이 두드러집니다. 그림 9A와 9B는 배터리 용량 예측, 전극 재료 선정, 시간 의존적 공정 등 복잡한 상호작용을 처리하는 데 있어 RF가 전기화학적 공정과 강한 상관관계를 가짐을 보여줍니다.
2020-2024년 기간 동안 에너지 관련 응용 분야(에너지 저장, 발전)의 등장은 해당 분야의 다변화를 입증합니다. LSTM(Long-Short Term Memory)은 배터리 열화 예측 및 사이클 성능 예측에 필수적인 시간적 역학 관계를 포착합니다. 또 다른 새로운 상관관계는 충전 프로토콜과 재료 사용을 최적화하고 배터리 관리 시스템에 활용될 수 있는 강화 학습(RL)입니다. 또한 배터리 및 이차 전지 분야에서는 공정 중 재료 상태를 추적하고 배터리의 상태 추정 및 잔여 수명을 예측하기 위해 칼만 필터(Kalman filters)가 사용되는 모습도 관찰됩니다.
트랜스포머(Transformers)는 과학 문헌에서 합성 절차와 재료 물성을 추출하고 복잡한 재료 설명에서 장기 의존성을 포착하는 데 사용됩니다. 합성곱 신경망(CNN)과 GAN은 2D/3D 구조에서 특징 추출을 자동화하고 물성 예측 및 패턴 인식을 지원합니다. 이러한 모델들은 강력하지만 더 많은 데이터와 연산 자원을 필요로 하며 해석 가능성이 낮기 때문에, 전통적인 모델을 대체하기보다는 보완하는 역할을 합니다. 신경망은 이미지 기반 분석과 생성적 설계에 점점 더 많이 사용되는 반면, 전통적인 방법론은 데이터셋이 제한적인 조성-물성 매핑 분야에서 여전히 강점을 유지합니다. 이것이 바로 신경망과 전통적인 모델이 결합되어 사용되는 이유입니다. 또 다른 발전 방향으로는 대칭성과 물리적 제약 조건을 통합한 재료 특화 CNN 아키텍처가 있으며, 원자 및 분자 구조 분석을 위해 GNN(그래프 신경망)이 주목받고 있습니다.
재료 과학 분야의 물질
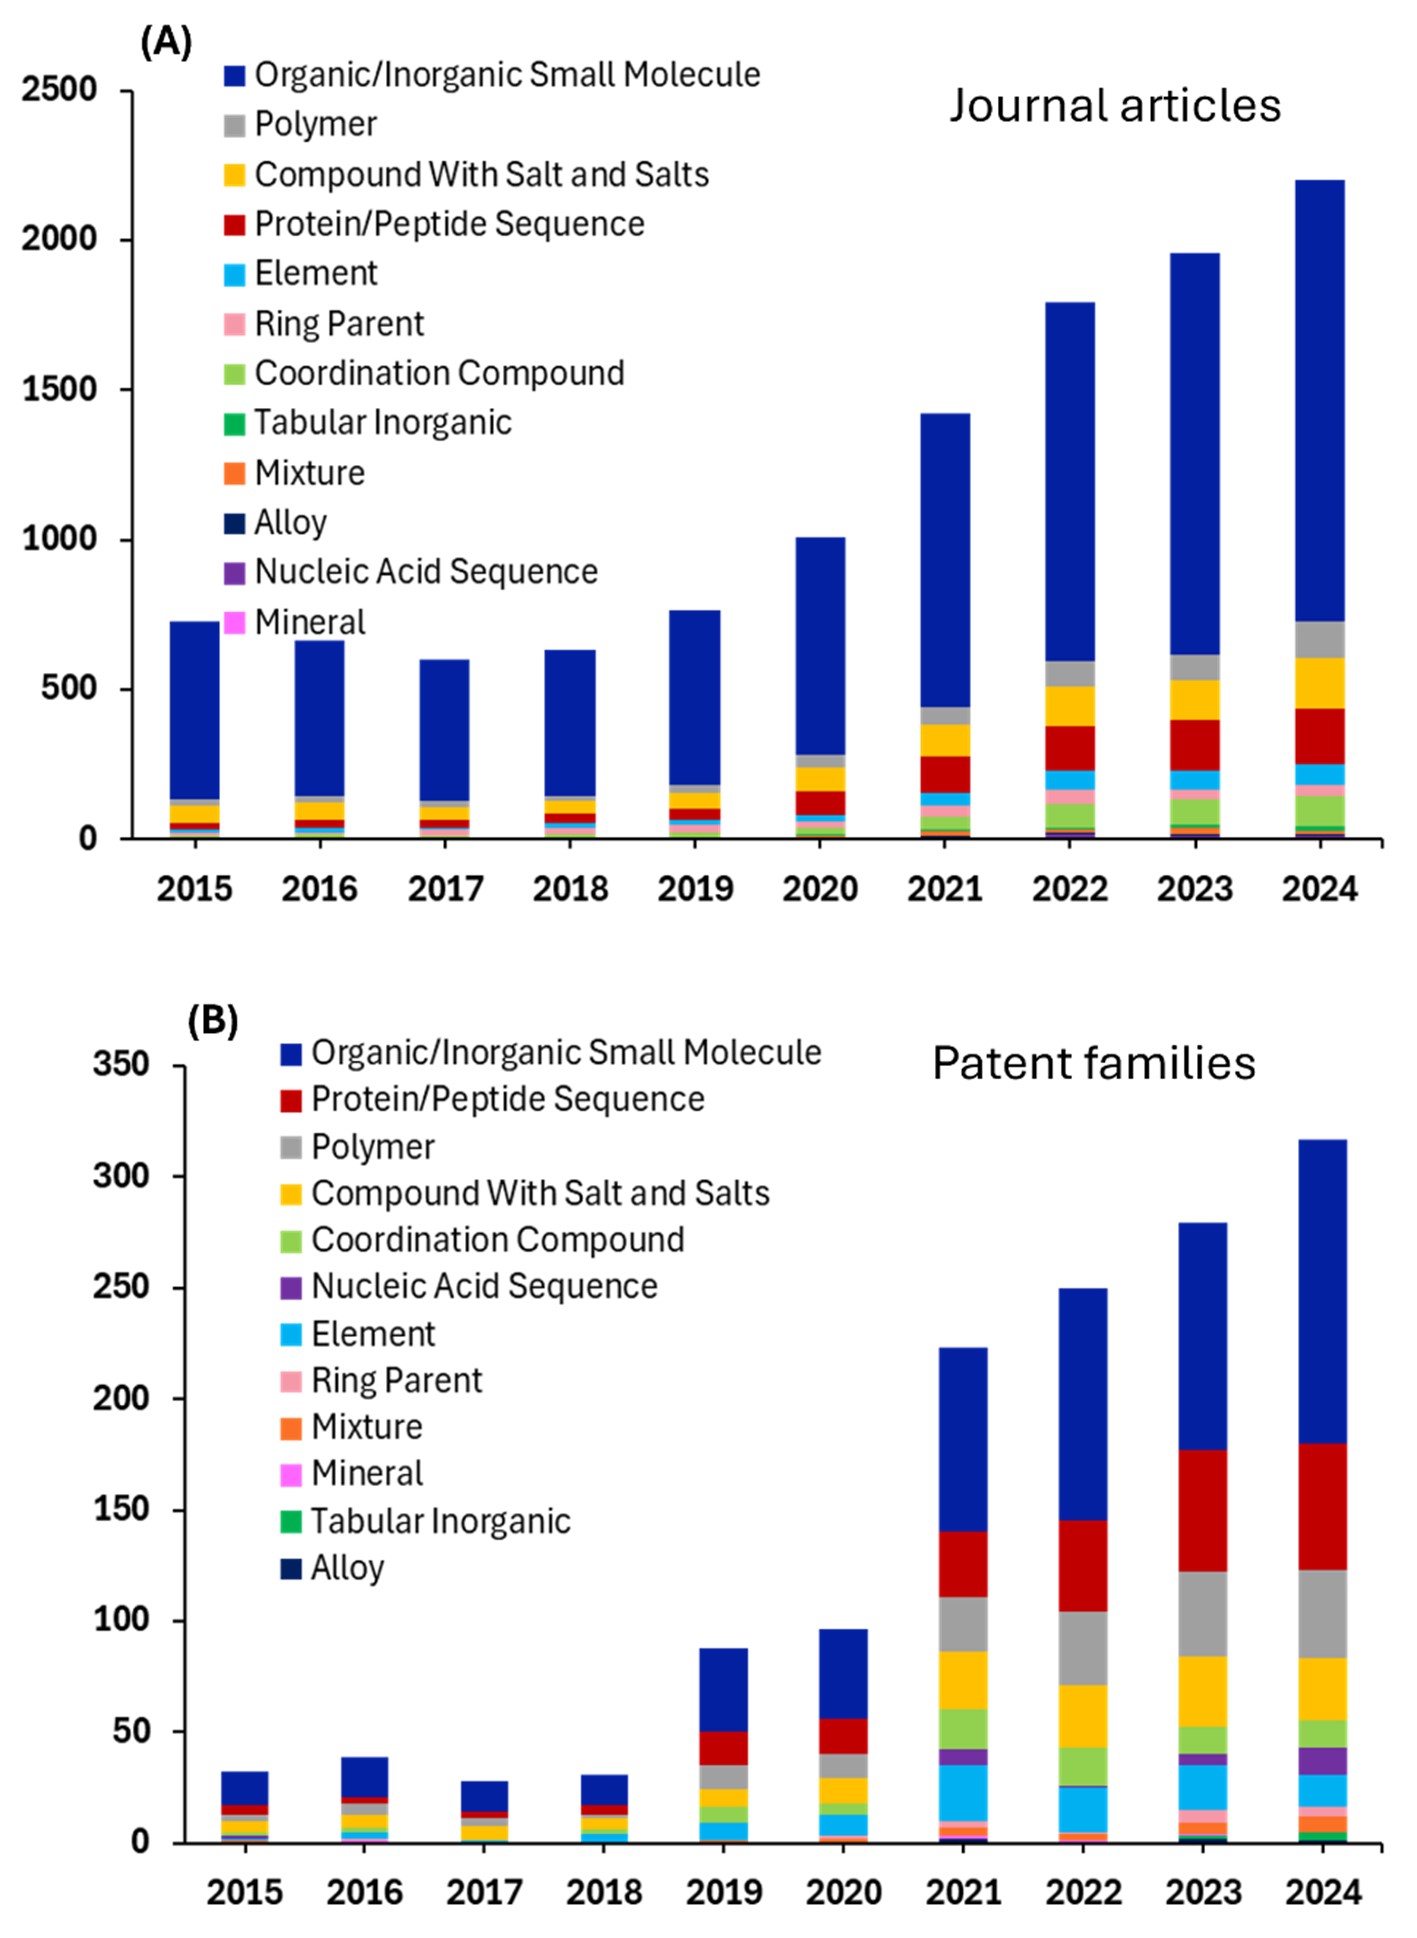
CAS에 색인된 물질 범주로 돌아와, 재료 과학 분야에서 이러한 물질과 관련된 출판물 수를 분석했습니다(그림 10 참조).

AI 기반 연구에서 유기/무기 저분자가 지배적인 이유는 폴리머와 같은 복잡한 대형 시스템에 비해 계산 비용 측면에서 유리하고 데이터가 풍부하기 때문입니다. 약 6,500건의 학술지 논문을 보유한 이 범주는 수십 년간 축적된 화학 데이터베이스의 혜택을 받고 있습니다.
저분자는 분자 기술자, 지문(fingerprints), 그래프 기반 표현을 사용하여 물성을 효과적으로 인코딩할 수 있기 때문에 머신러닝 접근 방식에 특히 적합합니다. 이 분야의 방대한 연구량은 신약 개발, 촉매 설계, 분자 물성 예측을 위한 제약 및 화학 산업의 강력한 AI 투자를 반영합니다.
원소는 약 5,500건의 논문으로 2위를 차지했으며, 마찬가지로 방대한 데이터베이스와 구조적 단순성 덕분에 AI 기반 물성 예측 및 재료 발견을 위한 이상적인 후보가 되고 있습니다.
표 형태의 무기 재료는 약 4,500건의 학술지 논문으로 AI가 상당한 응용 사례를 찾은 또 다른 분야입니다. 세라믹, 산화물 및 기타 구조화된 무기 화합물을 포함하는 이러한 재료는 결정학 데이터베이스와 체계적인 물성 측정의 이점을 누리며, 이는 효과적인 머신러닝에 필요한 대규모 데이터셋을 제공합니다. 이러한 재료의 구조적 특성 덕분에 결정 구조, 조성, 결합 특성에 기반한 일관된 특성 공학이 가능합니다. 이 범주가 AI 연구에서 두각을 나타내는 것은 에너지 저장, 촉매, 전자 및 자기 응용 분야를 위한 새로운 기능성 재료 발견에 재료 과학 커뮤니티가 집중하고 있음을 반영합니다.
폴리머 연구는 약 1,800건의 학술지 논문으로 완만한 AI 도입을 보이고 있는데, 이는 폴리머의 산업적 중요성을 고려할 때 낮아 보일 수 있습니다. 이는 복잡한 사슬 구조, 분자량 분포, 공정 의존적 물성 등 폴리머가 AI 응용 분야에 제시하는 고유한 과제를 반영하는 것으로 보입니다. 그러나 연구량의 증가는 폴리머 물성 예측, 합성 및 공정 최적화에 AI를 적용하는 사례가 점차 성공을 거두고 있음을 시사합니다.
본 분석에서 얻은 또 다른 중요한 발견은 모든 재료 과학 범주에서 특허 패밀리가 학술지 논문의 일부에 불과하다는 점입니다. 학술지와 특허 수의 격차는 재료 과학 분야의 AI 연구 상당수가 여전히 기초 또는 탐색 단계에 머물러 있으며, 학문적 발견이 상업적 단계에서 특허 보호를 받을 가치가 있는 실용적 응용으로 이어지기까지 상당한 시간 차이가 있음을 시사합니다.
상대적으로 적은 특허 수는 AI 기반 재료 발견을 상업적으로 실행 가능한 기술로 전환하는 데 따르는 어려움을 반영할 수도 있습니다. 이 분야의 많은 AI 응용 사례가 즉각적인 특허 대상이 되는 발명보다는 물성 예측과 기초적인 이해에 초점을 맞추고 있기 때문입니다. 재료 유형 전반에 걸친 일관된 비율은 학문적 성과를 상업적 성과로 전환하는 과제가 특정 재료군에 국한된 것이 아니라 재료 과학 전반에 걸친 보편적인 문제임을 나타냅니다.
공정 관리에서의 AI
AI는 더 스마트하고 빠르며 적응력이 뛰어난 의사결정을 가능하게 함으로써 공정 관리를 혁신하고 있습니다. 이 분야에서 AI의 역할을 분석해 보면 자동화, 예측 분석, 실시간 최적화가 어떻게 산업 전반에 걸쳐 운영 효율성을 극대화할 수 있는지 알 수 있습니다(그림 11 참조).

AI 기반 최적화는 적층 제조, 석유화학 산업, 플라스틱 가공, 야금, 흐름 화학, 촉매 공정, 신약 개발 및 합성 분야에서 널리 사용됩니다. 일반적으로 사용되는 모델로는 반응 표면 분석법(RSM), 실험 계획법과 함께 ANN, 하이브리드 모델, PINN, LLM 및 강화 학습과 같은 머신러닝 기법이 있습니다. 예측 모델링을 실시간 의사결정 및 자동화로 확장하고 있는 다른 기술들을 살펴보겠습니다.
- 실시간 모니터링:이 시스템은 머신러닝을 사용하여 스트리밍 데이터를 분석함으로써 패턴, 추세 및 조기 경보 신호를 감지하여 동적 예측과 선제적 의사결정을 촉진합니다. 주요 혁신 기술로는 실시간 입력값에 따라 매개변수가 자동으로 조정되는 자율 의사결정, 고장 발생 전 미리 예측하는 예지 보전, 변화하는 조건에 스스로 적응하는 자가 학습 모델이 있습니다. 또한 실시간 데이터 시각화와 지능형 경고 시스템은 운영자가 실시간 공정 데이터와 상호 작용하는 방식을 변화시키고 있습니다. 이러한 발전은 자동화된 크로마토그래피 시스템 및 제약 제조의 약물 반응 모니터링과 같은 산업 전반에 적용되고 있습니다. 또한 폴리머 생산의 물성 최적화, 폐기물 관리의 고형 폐기물 분석, 환경 모니터링, 대규모 수소 생산을 위한 에너지 및 자원 관리, 노후 인프라를 위한 클라우드 기반 에너지 관리 분야에서도 활용되고 있습니다.
- 소프트 센서:물리적 센서의 실시간 데이터를 활용하는 소프트 센서는 AI와 통계 모델을 사용하여 직접 측정하기 어렵거나 비용이 많이 드는 변수를 추정합니다. 이는 바이오 공정 모니터링, 폐수 및 대기질 모니터링을 포함한 다양한 산업 분야에 널리 적용됩니다. 화학 공정 제어에서 소프트 센서는 복잡한 황화광 부유 선광, 이성질화, 반응 증류 및 가솔린 혼합을 모니터링하는 데 사용됩니다.
- 디지털 트윈:이 혁신 기술은 물리적 시스템의 가상 복제본으로, AI 통합을 통해 실시간 최적화, 예측 분석 및 자율 운영을 가능하게 하며 빠르게 진화하고 있습니다. AI는 과거 및 실시간 데이터로부터 학습하여 미래 상태를 시뮬레이션하고, 이상 징후를 감지하며, 고장을 예측함으로써 디지털 트윈을 정적 모델에서 회복 탄력성을 갖춘 자가 최적화 시스템으로 변모시킵니다. 제조 분야에서 AI 기반 디지털 트윈은 센서와 이미지를 사용하여 장비 고장을 예측하고, 생산 공정을 최적화하며, 품질 문제를 감지합니다. 의료 분야에서는 환자 상태를 시뮬레이션하고, 맞춤형 의학을 지원하며, 질병 모델링, 임상 시험 시뮬레이션 및 면역 요법 최적화를 수행합니다. 환경 및 지속 가능성 분야에서는 지질 탄소 저장, 광석 폐기물 처리 및 자원 관리에 AI 기반 디지털 트윈이 적용됩니다. 또한 재료 과학을 지원하여 자동화된 발견, 결함 분석 및 역분자 설계를 가능하게 합니다.
과학 연구에서 AI 활용의 과제
AI는 모든 과학 연구 분야에 긍정적인 기여를 해왔으며, 앞으로도 발전함에 따라 그 기여도는 더욱 커질 것입니다. 그러나 이러한 혁신에는 연구자와 데이터 과학자가 AI의 잠재력을 완전히 실현하기 위해 해결해야 할 과제들이 있습니다. 가장 시급한 과제는 다음과 같습니다.
- 데이터 개인정보 보호 및 보안:데이터 개인정보 보호 및 보안을 보장하는 것은 AI 구현의 가장 큰 과제 중 하나입니다. AI는 학습과 운영을 위해 방대한 양의 민감한 데이터가 필요하기 때문입니다. 적절한 허가 없이 민감한 정보가 수집 및 사용되거나, AI 시스템에서 정보가 유출 또는 도난당할 때 문제가 발생합니다. 과학 데이터셋에는 미발표 실험 결과, 새로운 화합물 구조, 상당한 경쟁 우위를 점하는 독점적 합성 방법이 포함될 수 있습니다. 연구자가 클라우드 기반 AI 플랫폼을 사용하거나 협업 연구 환경에 참여할 때 지적 재산 노출이라는 상당한 위험에 직면하게 됩니다. 이러한 위험에 대응하기 위해 일부 기업은 고객 정보를 보호하고 신뢰를 유지하기 위한 안전장치를 구현하고 있으며, 새로운 스타트업들이 외부 AI 위협으로부터 보호하기 위한 시장 틈새를 찾고 있습니다.찾고 있습니다.
- 데이터 품질 및 편향성:데이터셋은 종종 체계적인 편향성을 겪으며, 이는 AI 모델을 통해 확산되어 예측을 왜곡하고 기존 연구의 불평등을 강화할 수 있습니다. 성공적인 반응은 과대평가되고 실패한 실험은 과소보고되는 출판된 반응 데이터의 역사적 편향성은 특히 무기 재료 분야에서 ML 모델이 새로운 화학 공간을 탐색하는 능력을 크게 저해할 수 있습니다. 이러한 "출판 편향"은 AI 시스템이 이미 잘 연구된 화합물과 유사한 것을 우선적으로 추천하게 만드는 자기 강화적 순환을 만듭니다. 생성형 AI 모델은 기존 데이터를 조작하거나 실제 증거를 희생하면서 고객의 요청을 충족하기 위해 환각 현상을 일으킬 수 있어 추가적인 우려를 낳고 있습니다.
- 투명성:이러한 모델의 "블랙박스" 특성은 예측의 근거를 불분명하게 만들어 연구자가 신뢰성을 평가하거나 잠재적인 실패 모드를 식별하기 어렵게 만듭니다. 신약 개발 분야의 설명 가능한 AI 방법에 대한 한 검토에서는 복잡한 모델의 해석 가능성 부족이 의약 화학자들 사이의 신뢰를 저해하고 제약 개발에서 AI 기반 의사결정에 대한 규제 승인을 방해할 수 있음을 강조했습니다. 이 문제는 고차원 화학 표현을 처리하는 그래프 신경망 및 트랜스포머 모델에서 특히 두드러지며, 입력 특성과 예측 간의 관계가 매우 비선형적으로 변합니다.검토에서는 복잡한 모델의 해석 가능성 부족이 의약 화학자들 사이의 신뢰를 저해하고 제약 개발에서 AI 기반 의사결정에 대한 규제 승인을 방해할 수 있음을 강조했습니다. 이 문제는 고차원 화학 표현을 처리하는 그래프 신경망 및 트랜스포머 모델에서 특히 두드러지며, 입력 특성과 예측 간의 관계가 매우 비선형적으로 변합니다.
- 자동화와 인간 전문 지식의 균형:AI 시스템은 방대한 데이터셋을 처리하고 인간의 인지 능력을 뛰어넘는 패턴을 식별할 수 있지만, 숙련된 과학자가 연구 문제에 가져오는 직관, 창의성 및 맥락적 이해는 부족합니다. 이는 근본적인 연구 기술과 개념적 이해가 부족한 과학자 세대를 양산할 수 있습니다. 반대로, AI 기반 결론이 직관과 상충할 때 "알고리즘 혐오"로 이어질 수도 있습니다.알고리즘 혐오가 발생할 수 있습니다.
AI 모델과 과학 연구의 미래
과학 탐구에서 AI의 중요성은 더욱 커질 것이며, 생물의학 및 재료 과학과 같은 분야에서 그 혁신적인 역량은 이미 실현되고 있습니다. CAS 콘텐츠 컬렉션 분석에서 볼 수 있듯이, 어려운 연구 질문에 적용되는 새로운 애플리케이션, 모델 및 방법이 끊임없이 등장하고 있습니다. 신약 개발, 질병 진단, 재료 개발 등에서 이루어질 획기적인 성과들이 AI 기반 기술에 의해 영향을 받거나 완전히 주도될 것으로 예상됩니다.
AI가 도구에서 협력적인 과학 파트너로 전환됨에 따라, 역설계 및 자율 주행 실험실과 같은 새로운 패러다임이 과학적 방법론을 자율적인 발견 엔진으로 재정의할 것으로 보입니다. 그러나 낮은 특허 대 출판 비율은 특히 전통적인 재료 과학 분야에서 많은 연구가 여전히 학계에 머물러 있음을 나타냅니다.
AI의 추가적인 도입을 위해서는 불확실성 정량화 및 모델 투명성과 같은 기술적 솔루션을 통한 적절한 신뢰 조정이 필요합니다. 과학에 미치는 AI 영향의 광범위한 특성과 구현 과정의 과제들을 고려할 때, 과학적 발전을 위한 혜택을 극대화하려면 협업과 가시성이 핵심이 될 것입니다.
더 자세한 내용은 재발행 저널 기사 "화학 분야의 AI 혁명: 재료 및 생물의학 과학의 미래 형성"을 읽어보시기 바랍니다.
본 문서에 언급된 브랜드 이름 및/또는 제3자 제품이나 서비스에 대한 언급은 교육적 목적으로만 사용되었으며, CAS 또는 미국화학회(American Chemical Society)의 보증을 의미하지 않으며, 언급되지 않은 유사한 브랜드, 제품 또는 서비스에 대한 차별을 의미하지 않습니다.


