

医疗领域的创新步伐不断加快,这意味着人类对自身健康状况的理解日益加深,也带来了开发更有效疗法的可能。然而,识别出某种病症、分子或治疗靶点并不意味着我们就能治愈疾病。人体结构复杂,每一项新发现都会引出更多关于如何开发合适疗法的问题。
幸运的是,技术可以助力加速科学突破的识别。在 CAS,我们应用机器学习算法开发了预测模型,旨在协助寻找治疗癌症、病毒感染和炎症性疾病等多种疾病的有效新药。我们重点关注了 TBK1(TANK 结合激酶 1),这是一种具有激酶活性的酶,在多种生物过程中发挥着关键作用。靶向 TBK1 有望推动针对危及生命疾病的新疗法开发,但其复杂性也给研究带来了挑战。
我们分析了 CAS Content CollectionTM,这是全球最大的经人工标引的科学信息库。分析发现,2020 年至 2023 年间,关于 TBK1 的期刊论文数量几乎翻了一番。这表明科研界对此兴趣浓厚,但专利申请数量的缓慢增长反映出靶向 TBK1 可能存在困难。
由于 TBK1 在免疫和细胞反应中起着至关重要的作用,它是极具前景的新药治疗靶点。研究人员需要相关工具来克服与该激酶相关的复杂性,从而更快地实现突破。我们的计算机建模方法展示了实现这一目标的路径。
TBK1 在癌症、自身免疫性疾病等领域发挥作用
激酶是一类催化磷酸基团从高能分子(如 ATP)转移到特定底物分子(通常是蛋白质、脂质或碳水化合物)的酶。激酶对于细胞内信号传导和外部刺激响应至关重要,并参与了许多生理过程。作为一种重要的激酶,TBK1 具有以下功能:
- 作为先天免疫系统应对病毒和细菌感染的关键调节因子。
- 参与炎症反应的调节。
- 对自噬过程的调节至关重要,自噬是细胞降解和回收受损细胞器及蛋白质的过程。
- 在多种环境下促进细胞存活和增殖。
- 参与代谢过程的调节,包括葡萄糖代谢和脂质稳态。
- 与细胞对 DNA 损伤的反应有关。
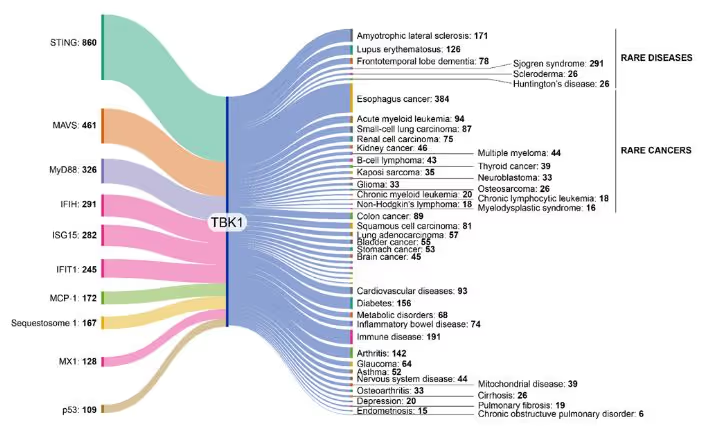
由于 TBK1 在众多生物过程中具有重要意义,它与多种疾病密切相关。在对 CAS Content Collection 的分析中,我们可视化了过去 20 年科学文献中 TBK1 与其他蛋白质及疾病的共现情况(见图 1)。值得注意的疾病共现包括:
- 自身免疫性疾病,如狼疮、多发性硬化症和肠易激综合征。
- 神经退行性疾病,如肌萎缩侧索硬化症 (ALS) 和额颞叶痴呆。
- 癌症的发生与发展,TBK1 可通过促进细胞增殖、抑制凋亡以及调节肿瘤微环境来导致肿瘤进展。
- 病毒感染,TBK1 的失调可能会影响免疫系统对病毒的反应。
- 代谢紊乱,但其确切机制仍有待进一步探索。
研究人员正在寻求能够选择性阻断该激酶活性的 TBK1 抑制剂。在 TBK1 失调或过度活跃的病症中进行靶向治疗,有望实现重大的临床突破,包括癌症治疗。尽管临床前研究结果令人鼓舞,但 TBK1 抑制剂的开发仍面临多重挑战,包括实现足够的选择性以最大限度减少脱靶效应、优化药代动力学特性以实现有效的药物递送和体内分布,以及确保临床环境中的安全性和耐受性。
QSAR 建模基于 IC50 值识别潜在疗法
在开发抑制剂药物时,研究人员会检测 IC50(半数抑制浓度)值。IC50 是量化抑制剂效力的一项指标,特别是在酶抑制研究中。它代表抑制 50% 生物或生化靶点(如酶或细胞过程)活性所需的抑制剂浓度。IC50 是衡量药物疗效最广泛使用且信息量最大的指标。
在计算机辅助药物设计中,预测潜在候选药物的 IC50 值对于评估其抑制目标酶或蛋白质的效力至关重要。定量构效关系 (QSAR) 模型通过建立化合物化学结构与生物活性(包括 IC50 值)之间的联系,成为实现此类预测的有效工具。通过分析已知抑制剂的实验 IC50 值数据集,QSAR 模型能够预测新化合物的 IC50 值。
为实现这一目标,我们利用 CAS 内容合集提取了所有关于 IC50、pIC50 和 TBK1 的可用数据。经过数据清洗,我们获得了包含 1,183 个化合物的训练集。其中约 40%(475 个)具有精确的 IC50 测量值,适用于开发回归模型。其余数据则以 IC50=1uM 和 IC50=0.1uM 两个断点表示为二元数据(活性/非活性),适用于开发二元分布模型和三分类模型。
鉴于科学家和监管机构对预测能力有着不同的需求,我们选择构建了这三种不同类型的模型。
片段功能分析描述符可实现最佳预测效果
在开发模型时,我们使用了三组不同的分子描述符:专有的 CAS 指纹、RdKit 中的可用描述符以及片段功能分析描述符。
研究发现,基于片段功能分析描述符构建的模型整体预测效果最佳(见图 2)。在此分析中,我们将训练集中的化学结构拆分为子片段,生成了超过 66,000 个单一片段。我们对所有三种模型类型(回归模型、二元分布模型和三分类模型)均进行了此项分析。


随后,我们利用机器学习算法确定了特定分子描述符的重要性(见表 1)。特征选择是任何机器学习技术中的关键环节,旨在提取最具信息量的特征,并剔除噪声以及无关和冗余的属性。表 1 展示了片段功能分析中排名前列的活性分子描述符,它们主要存在于效力最强的 TBK1 抑制剂中。
|
Structural alert |
Average pIC50 |
# of actives |
# of inactives |
 |
8.000 |
10 |
0 |
 |
8.000 |
4 |
0 |
 |
8.000 |
6 |
0 |
 |
8.003 |
11 |
0 |
 |
8.068 |
215 |
1 |
 |
8.000 |
3 |
0 |
 |
8.667 |
3 |
0 |
 |
8.000 |
21 |
0 |
 |
8.654 |
16 |
0 |
 |
8.000 |
8 |
0 |
QSAR 模型对新分子的预测结果仅在这些分子处于其适用域(由构建模型所用的所有分子描述符定义的化学空间)内时才有效。图 3 展示了 Williams 图,该图通过杠杆值 (h) 与标准化残差 (σ) 的关系图来表示适用域。我们模型的适用域定义在 ±3σ 以内,且预警杠杆阈值 h* = 0.25。

该分析表明,机器学习工具和计算机建模确实能够帮助研究人员从复杂的数据集中识别出有前景的药物疗法。通过应用多种建模方法,我们可以确定 TBK1 的潜在靶点,从而推动针对癌症、神经退行性疾病、自身免疫性疾病及更多病症的药物开发,助力医学研究不断取得新进展。
分析海量数据并处理化合物与分子的复杂性是完全可行的。通过利用尖端技术将这些数据转化为预测结果,我们能够在药物发现领域实现新的突破。
如需深入了解 TBK1 抑制剂和预测模型构建这一充满活力且令人振奋的领域,请阅读我们最新的 CAS 洞察报告,以及我们近期发表在《化学信息与建模杂志》上的文章。


