

El ritmo de innovación en el ámbito médico se acelera constantemente, lo que supone una mayor comprensión de las condiciones de salud humana y la posibilidad de tratamientos más eficaces. Sin embargo, identificar una afección, molécula o diana terapéutica no significa automáticamente que podamos curar una enfermedad. El cuerpo humano es complejo y cada nuevo descubrimiento plantea más interrogantes sobre cómo desarrollar las terapias adecuadas.
Afortunadamente, la tecnología puede favorecer una identificación más rápida de los avances científicos. En CAS, hemos aplicado algoritmos de aprendizaje automático para desarrollar modelos predictivos que ayuden a encontrar nuevos fármacos eficaces para tratar numerosas enfermedades, como el cáncer, las infecciones víricas y los trastornos inflamatorios. Nos hemos centrado en la TBK1 (quinasa 1 de unión a TANK), una enzima con actividad quinasa que desempeña un papel crucial en múltiples procesos biológicos. Dirigirse a la TBK1 tiene el potencial de impulsar nuevas terapias para enfermedades potencialmente mortales, aunque su complejidad plantea retos de investigación.
Hemos analizado la CAS Content CollectionTM, el mayor repositorio de información científica curado por expertos, y hemos observado que las publicaciones en revistas sobre la TBK1 casi se han duplicado entre 2020 y 2023. Esto sugiere un gran interés por parte de la comunidad investigadora, pero el escaso crecimiento observado en las publicaciones de patentes pone de manifiesto las posibles dificultades para dirigirse a la TBK1.
Dado que la TBK1 desempeña un papel fundamental en las respuestas inmunitarias y celulares, es una diana muy prometedora para nuevas terapias farmacológicas, y los investigadores necesitan herramientas para superar las complejidades relacionadas con esta quinasa y encontrar avances con mayor rapidez. Nuestro enfoque de modelado informático demuestra cómo puede lograrse.
La TBK1 interviene en el cáncer, las enfermedades autoinmunes y otros procesos
Las quinasas son enzimas que catalizan la transferencia de un grupo fosfato desde una molécula de alta energía, como el ATP, a una molécula sustrato específica, normalmente una proteína, un lípido o un carbohidrato. Las quinasas son esenciales para transmitir señales dentro de las células y ante estímulos externos. Intervienen en muchos procesos fisiológicos. Como quinasa importante, la TBK1 es:
- Un regulador clave de la respuesta inmunitaria innata frente a infecciones víricas y bacterianas.
- Interviene en la regulación de las respuestas inflamatorias.
- Importante para la regulación de la autofagia, un proceso celular implicado en la degradación y el reciclaje de orgánulos y proteínas dañados.
- Contribuye a la supervivencia y proliferación celular en diversos contextos.
- Interviene en la regulación de procesos metabólicos, incluido el metabolismo de la glucosa y la homeostasis lipídica.
- Está implicada en la respuesta celular al daño del ADN.
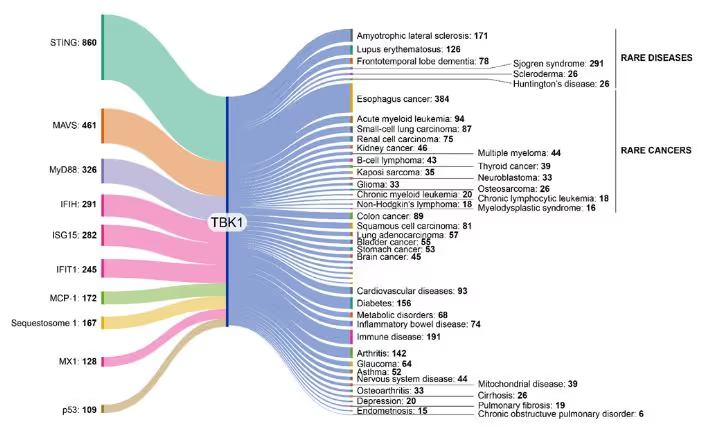
Debido a su importancia en tantos procesos biológicos, la TBK1 se ha relacionado con diversas enfermedades. En nuestro análisis de la CAS Content Collection, visualizamos las coocurrencias de la TBK1 con otras proteínas y enfermedades en la literatura científica durante los últimos 20 años (véase la Figura 1). Entre las coocurrencias de enfermedades más notables se incluyen:
- Enfermedades autoinmunes como el lupus, la esclerosis múltiple y el síndrome del intestino irritable.
- Trastornos neurodegenerativos como la ELA y la demencia frontotemporal.
- Desarrollo y progresión del cáncer, donde la TBK1 puede potenciar la proliferación celular, inhibir la apoptosis y modular el microambiente tumoral de formas que provocan la progresión del tumor.
- Infecciones víricas, que pueden verse afectadas por la desregulación de la TBK1, influyendo en la respuesta del sistema inmunitario frente a los virus.
- Trastornos metabólicos, aunque los mecanismos precisos aún están en fase de estudio.
Los investigadores están buscando inhibidores de la TBK1 que puedan bloquear selectivamente la actividad de esta quinasa. Dirigirse a la TBK1 en condiciones en las que está desregulada o hiperactiva podría dar lugar a importantes avances clínicos, incluso en el tratamiento del cáncer. A pesar de los prometedores resultados preclínicos, el desarrollo de inhibidores de la TBK1 se enfrenta a varios retos, como lograr una selectividad suficiente para minimizar los efectos fuera de diana, optimizar las propiedades farmacocinéticas para una administración y distribución eficaces en el organismo, y garantizar la seguridad y tolerabilidad en entornos clínicos.
El modelado QSAR identifica terapias potenciales basadas en valores de CI50
Al desarrollar un fármaco inhibidor, los investigadores examinan el valor de CI50 (concentración inhibitoria semimáxima). La CI50 es una medida que cuantifica la potencia de un inhibidor, especialmente en estudios de inhibición enzimática. Representa la concentración de un inhibidor necesaria para inhibir el 50% de la actividad de una diana biológica o bioquímica, como una enzima o un proceso celular. La CI50 es la medida de la eficacia de un fármaco más utilizada e informativa.
En el diseño de fármacos asistido por ordenador, predecir los valores de CI50 de posibles candidatos a fármacos es crucial para evaluar su potencia en la inhibición de la enzima o proteína diana. Los modelos de relación cuantitativa estructura-actividad (QSAR) son útiles para realizar estas predicciones, ya que relacionan la estructura química de los compuestos con su actividad biológica, incluidos los valores de CI50. Al analizar un conjunto de datos de inhibidores conocidos con valores de CI50 experimentales, los modelos QSAR pueden predecir los valores de CI50 de nuevos compuestos.
Para lograrlo, utilizamos la CAS Content Collection para extraer todos los datos disponibles sobre CI50, pCI50 y TBK1. Tras depurar los datos, obtuvimos un conjunto de entrenamiento de 1183 compuestos. Aproximadamente el 40 % (475) de ellos estaban representados con mediciones exactas de CI50, lo cual es adecuado para desarrollar modelos de regresión. El resto de los datos se representó de forma binaria (activo/inactivo) en dos puntos de corte diferentes: CI50=1uM y CI50=0,1uM. Estos fueron adecuados para desarrollar modelos de distribución binaria y clasificadores de tres categorías.
Dado que los científicos y los organismos reguladores tienen necesidades diferentes en cuanto a capacidades predictivas, decidimos crear estos tres tipos de modelos distintos.
Los descriptores de análisis funcional de fragmentos ofrecen los mejores resultados
Al desarrollar nuestros modelos, utilizamos tres conjuntos diferentes de descriptores moleculares: la huella digital patentada de CAS, los descriptores disponibles en RdKit y el análisis funcional de fragmentos.
De ellos, descubrimos que los mejores modelos predictivos generales se derivaron de los descriptores de análisis funcional de fragmentos (véase la Figura 2). Para este análisis, se generaron más de 66 000 fragmentos individuales tras dividir las estructuras químicas del conjunto de entrenamiento en subfragmentos. Realizamos este análisis en los tres tipos de modelos (regresión, distribución binaria y clasificadores de tres categorías).


A continuación, utilizamos algoritmos de aprendizaje automático para determinar la importancia de determinados descriptores moleculares (véase la Tabla 1). La selección de características es una parte fundamental de cualquier técnica de aprendizaje automático. Su objetivo es extraer las características más informativas y eliminar el ruido, así como los atributos irrelevantes y redundantes. La Tabla 1 muestra los principales descriptores moleculares activos del análisis funcional de fragmentos que están presentes principalmente en los inhibidores de TBK1 más potentes.
|
Structural alert |
Average pIC50 |
# of actives |
# of inactives |
 |
8.000 |
10 |
0 |
 |
8.000 |
4 |
0 |
 |
8.000 |
6 |
0 |
 |
8.003 |
11 |
0 |
 |
8.068 |
215 |
1 |
 |
8.000 |
3 |
0 |
 |
8.667 |
3 |
0 |
 |
8.000 |
21 |
0 |
 |
8.654 |
16 |
0 |
 |
8.000 |
8 |
0 |
Las predicciones para nuevas moléculas obtenidas a partir de un modelo QSAR solo son aceptables si las nuevas moléculas se encuentran dentro de su dominio de aplicabilidad (el espacio químico definido por todos los descriptores moleculares utilizados para construir el modelo). La Figura 3 muestra el gráfico de Williams que representa el dominio de aplicabilidad como un gráfico de apalancamiento (h) frente a residuos estandarizados (σ). El dominio de aplicabilidad de nuestro modelo se define dentro de ±3σ y un umbral de apalancamiento de advertencia h* = 0,25.

Este análisis demuestra que las herramientas de aprendizaje automático y el modelado informático pueden ayudar a los investigadores a identificar terapias farmacológicas prometedoras a partir de conjuntos de datos complejos. Al aplicar diversos enfoques de modelado, podemos identificar posibles dianas para TBK1, lo que puede impulsar el desarrollo de fármacos para tratar el cáncer, enfermedades neurodegenerativas, afecciones autoinmunes y más a medida que continúen los descubrimientos médicos.
Es posible analizar grandes cantidades de datos y tener en cuenta la complejidad de los compuestos y las moléculas. Al utilizar tecnología de vanguardia para sintetizar esos datos en predicciones, podemos alcanzar nuevos avances en el descubrimiento de fármacos.
Para obtener más información sobre el apasionante y dinámico campo de los inhibidores de TBK1 y la creación de modelos predictivos, lea nuestro nuevo informe de CAS Insights y nuestro reciente artículo en el “Journal of Chemical Information and Modeling”.


