

A prontidão para IA nem sempre exige um algoritmo melhor. Às vezes, requer apenas uma melhor curadoria e análise de dados.
Um estudo de caso publicado na PNAS ilustra bem esse ponto. Pesquisadores classificaram quase 10.000 compostos químicos usando uma abordagem padrão de aprendizado de máquina e alcançaram apenas 10% de precisão. Quando a CAS refez a análise com descritores químicos de maior qualidade, a precisão saltou para 45% (melhoria mediana: 33%). O mesmo modelo, uma base mais sólida.
Quando os dados são mais bem aproveitados, as equipes de pesquisa conseguem identificar os melhores compostos em horas, em vez de semanas. No entanto, chegar a esse ponto exige requisitos específicos.
Quando a IA que você implementa falha
Existe uma história que se repete frequentemente em equipes de P&D científico encarregadas de aplicar IA em suas pesquisas. A equipe:
- Investe em infraestrutura.
- Contrata cientistas de dados.
- Executa projetos-piloto.
- Testa os sistemas de IA.
- Analisa os resultados brilhantes dos testes.
E só então descobrem que seus modelos de IA tropeçam ao encontrar condições do mundo real. Pior ainda? Os resultados brilhantes nunca se concretizam.
Eles ajustam o algoritmo, adicionam mais dados, alteram parâmetros. Ainda assim, nada. O instinto é culpar o modelo.
Resultados como esse apontam para uma lacuna na prontidão para IA.
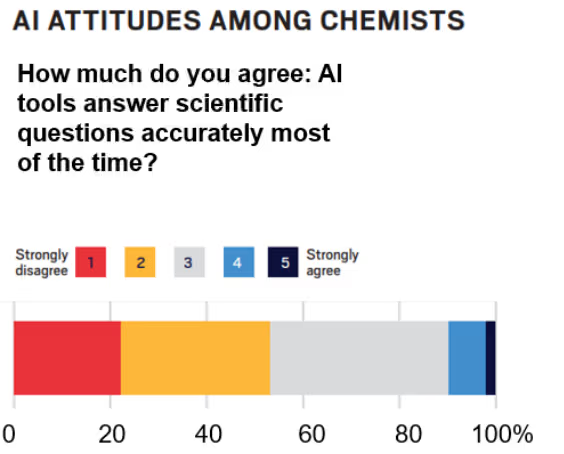
Figura 1: Fonte: Relatório da Pesquisa de Marketing para Ciências Químicas do C&EN BrandLab 2025.
Embora a equipe possa fortalecer sua infraestrutura digital, muitas vezes ainda enfrenta dificuldades para fazer com que a IA em P&D se comporte de maneira consistente na pesquisa do dia a dia.
Dados científicos frequentemente variam em estrutura ou qualidade, e essa variação afeta a precisão com que os algoritmos interpretam as informações que recebem. Como resultado, modelos que apresentam bom desempenho em testes controlados muitas vezes têm um desempenho inferior quando expostos às condições irregulares de experimentos reais. Por exemplo, conjuntos de dados de avaliação podem ser "limpos demais" ou muito semelhantes aos dados de treinamento. Eles também podem falhar ao refletir ruídos do mundo real, valores discrepantes, desvios experimentais ou a diversidade total de casos que os pesquisadores encontram.
Modelos treinados com dados incompletos ou inconsistentes nunca apresentam um bom desempenho. A falta de contexto específico do domínio em pipelines de IA, como ontologias químicas precisas, restrições mecanísticas ou anotações curadas por especialistas, também pode causar problemas de precisão que não decorrem da qualidade dos dados em si, mas da ausência de estruturas científicas. Essa lacuna introduz incerteza, tornando desafiadora a integração da IA nos fluxos de trabalho de P&D.
Não se trata apenas de ajustar os processos atuais para funcionarem em um ambiente ligeiramente diferente. Preparar-se para usar a IA como parte da sua infraestrutura central de P&D é um empreendimento de grande porte. Errar nisso pode desperdiçar orçamentos, causar o fracasso de projetos-piloto, desencorajar a liderança de investir os recursos necessários e deixar seus cientistas pesquisadores céticos quanto aos benefícios.
Três áreas onde as organizações enfrentam dificuldades para usar IA em fluxos de trabalho de P&D
Muitas organizações que trabalham para implementar IA em P&D científico encontram obstáculos operacionais semelhantes.
A maioria desses problemas se enquadra em um pequeno conjunto de padrões recorrentes que limitam a prontidão para a IA. As áreas a seguir representam as fontes mais comuns de atrito:
1. O alinhamento de sistemas torna-se um desafio quando as ferramentas que armazenam e processam dados científicos não conseguem trocar informações de forma clara. Esse desalinhamento geralmente se manifesta de várias maneiras:
- ELNs (Cadernos de Laboratório Eletrônicos) e LIMS (Sistemas de Gerenciamento de Informações Laboratoriais) frequentemente armazenam informações em formatos incompatíveis.
- As equipes precisam ajustar manualmente os registros quando os dados são movidos entre sistemas.
- Ajustes manuais tornam o trabalho piloto mais lento e aumentam o risco de erros.
- Os pipelines tornam-se instáveis quando os metadados são recriados ou renomeados durante as transferências.
Juntas, essas falhas interrompem o fluxo de informações e impedem que os modelos operem de forma consistente em tarefas científicas rotineiras.
2. Transferências manuais e interrupções de processo corroem a rastreabilidade em todo o fluxo de trabalho. Quando os dados se movem entre sistemas ou equipes por meio de canais informais como exportações, e-mails e planilhas, o contexto é perdido:
- Os registros chegam sem os metadados necessários para interpretá-los.
- Quando um modelo produz um resultado inesperado, as equipes têm dificuldade em reconstruir como as entradas foram geradas.
- Torna-se difícil determinar se um problema originou-se nos dados ou em uma lacuna no processo.
- As investigações se arrastam e os cientistas gastam mais tempo buscando a procedência do que analisando os resultados.
A fragmentação do fluxo de trabalho cria lacunas de comunicação. Isso é especialmente custoso quando os dados cruzam as fronteiras dos departamentos. No Calibr-Skaggs, as equipes de biologia e química medicinal verificavam manualmente até 1.000 novos compostos por dia, atrasando as decisões de seguir ou não com os projetos. O CAS otimizou seu pipeline com uma integração de API que permitiu que ambas as equipes trabalhassem em paralelo, eliminando atrasos causados por transferências sequenciais.
3. A falta de coordenação entre as equipes pode enfraquecer a prontidão para IA ao longo do tempo.
Outro desafio comum ocorre quando grupos de ciência, dados e TI baseiam suas expectativas quanto à estrutura, aos padrões e ao significado dos dados em metas, processos e plataformas distintos. Embora algumas dessas desconexões possam ser tão simples quanto regras inconsistentes de nomenclatura, versionamento ou organização de registros, outros casos resultam de diferenças fundamentais de significado. Essas inconsistências tendem a surgir quando:
- Cada grupo aplica suas próprias convenções para definições, estrutura e organização de dados.
- As diferenças exigem um esforço manual substancial para harmonização, o que retarda o fluxo de dados e cria oportunidades para erros.
- As equipes de IA não têm conhecimento das diferenças de padrões nas etapas anteriores, resultando em soluções de IA imprecisas e inutilizáveis.
Com o tempo, essas inconsistências tornam-se mais difíceis de gerenciar e afetam a confiança nos resultados da IA. Observamos esse tipo de situação quando cientistas experimentais são encarregados de desenvolver uma estratégia de dados completa, mas precisam de treinamento adicional para lidar com diversos formatos de dados. Esta é outra forma pela qual a equipe do CAS trabalha com parceiros como a Toray, ajudando a formalizar processos de governança de dados.
Cinco indicadores de prontidão para IA em P&D
Organizações bem posicionadas para escalar a IA compartilham um conjunto consistente de características de fluxo de trabalho. Essas cinco características refletem como dados, ferramentas e revisões científicas eficazes sustentam modelos capazes de se adaptar a condições experimentais em evolução, resolver ambiguidades específicas do domínio e incorporar mudanças contínuas ao conhecimento subjacente.
1. Governança de dados que orienta decisões científicas e técnicas
Uma governança sólida é um indicador fundamental de prontidão para IA, pois esclarece o processo pelo qual as decisões sobre dados e modelos são tomadas. Em ambientes maduros, a propriedade dos conjuntos de dados e suas regras de organização são definidas, e as equipes sabem quem é responsável por aprovar mudanças no comportamento do modelo. Essas expectativas são incorporadas aos fluxos de trabalho científicos existentes, garantindo que as decisões ocorram no contexto apropriado.
Também é importante manter um registro compartilhado de todos os conjuntos de dados e atualizações de modelos, completo com carimbos de data/hora e justificativas, para criar a trilha de auditoria que a supervisão estruturada exige. Quaisquer alterações que afetem fluxos de trabalho subsequentes também devem acionar uma revisão multifuncional, garantindo que as decisões tomadas em uma parte do pipeline não introduzam falhas em outras.
Quando a governança funciona dessa maneira, as equipes podem rastrear o que mudou, por que mudou e como essas atualizações afetam o desempenho da IA em todo o fluxo de trabalho de P&D.
2. Metadados completos e cientificamente significativos
Organizações prontas para IA tratam os metadados como as informações que tornam os registros científicos interpretáveis e acionáveis. Os metadados descrevem como as amostras foram preparadas, como as estruturas foram representadas, quais identificadores foram atribuídos e a origem de cada registro. Equipes com alto nível de prontidão garantem que esses detalhes sejam completos e expressos de forma consistente, para que os registros não entrem em conflito ao serem transferidos entre sistemas. Elas também mantêm um histórico de como cada registro evoluiu. Metadados estáveis e bem estruturados permitem que os sistemas de IA interpretem as entradas com mais precisão, reduzindo a incerteza que frequentemente surge mais adiante no fluxo de trabalho.
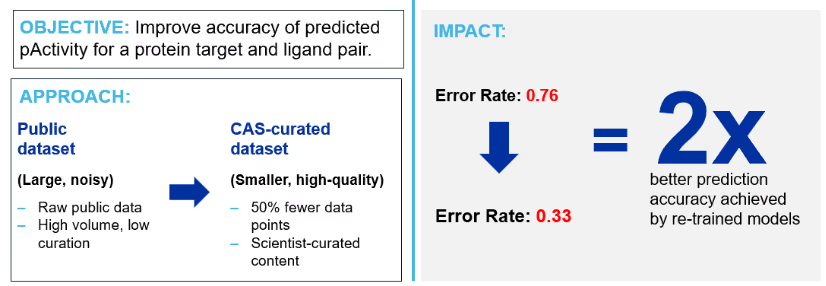
Figura 2: Estudo de caso do CAS demonstrando o impacto de conteúdo de alta qualidade, curado por cientistas, na precisão preditiva da atividade biológica de um ligante contra um alvo proteico. Ao usar conteúdo curado pelo CAS em vez de dados públicos ruidosos, o modelo aumentou em 2x a precisão da previsão, utilizando um conjunto de dados de treinamento com metade do tamanho do original.
3. Interoperabilidade entre ELNs, LIMS e ambientes de modelagem
A interoperabilidade é outro indicador de prontidão, pois reflete a fluidez com que as informações circulam pelos sistemas de P&D. Em ambientes maduros, os dados são transmitidos por meio de APIs mantidas, em vez de transferências manuais, e as estruturas dos conjuntos de dados permanecem consistentes à medida que as informações são trocadas entre ELNs, LIMS e ferramentas de modelagem. Isso evita alterações inesperadas em campos ou rótulos que, de outra forma, interromperiam os pipelines.
A terminologia consistente entre os sistemas garante que os registros mantenham seu significado à medida que avançam pelo fluxo de trabalho. Soluções como uma API personalizada podem aplicar padrões de metadados entre as equipes para melhorar a consistência, uma estratégia que tem demonstrado sucesso em organizações de descoberta de medicamentos que possuem equipes multifuncionais fornecendo dados.
Quando a interoperabilidade funciona bem, os modelos recebem entradas que correspondem às condições reais de laboratório, o que melhora a estabilidade durante a implementação.
4. Sistemas que mantêm a confiabilidade à medida que os fluxos de trabalho evoluem
Outro sinal de prontidão para IA é a capacidade de uma organização manter a confiabilidade do modelo à medida que o volume de dados aumenta e o conhecimento científico evolui. Ambientes maduros mantêm conjuntos de dados versionados, permitindo a reprodução de resultados anteriores, e conservam registros que armazenam os dados, configurações e resultados de avaliação associados a cada modelo. O monitoramento automatizado detecta mudanças inesperadas no desempenho, e os logs de configuração permitem que as equipes entendam como os modelos foram criados.
Essas práticas proporcionam visibilidade sobre o comportamento do modelo, o que apoia a tomada de decisão científica fundamentada à medida que os fluxos de trabalho evoluem. Isso também garante que os resultados científicos e as avaliações dos modelos possam ser reproduzidos meses ou anos depois, um requisito para padrões regulatórios e de publicação.
5. Validação com intervenção humana integrada aos fluxos de trabalho científicos
Organizações prontas para IA garantem que a revisão científica permaneça no centro de seu fluxo de trabalho. Como a IA não pode determinar se suas previsões estão alinhadas com as condições laboratoriais, os pesquisadores revisam os resultados em pontos definidos para confirmar se eles condizem com as expectativas experimentais. Os critérios de validação refletem o que é viável em laboratório e as restrições aplicáveis aos métodos subjacentes. Essas verificações ocorrem antes que os resultados sejam processados, e os revisores documentam o raciocínio por trás de cada decisão. A comparação regular das previsões com os resultados experimentais oferece às equipes uma compreensão mais clara de como os modelos se comportam ao longo do tempo e fortalece a confiança em seu uso.
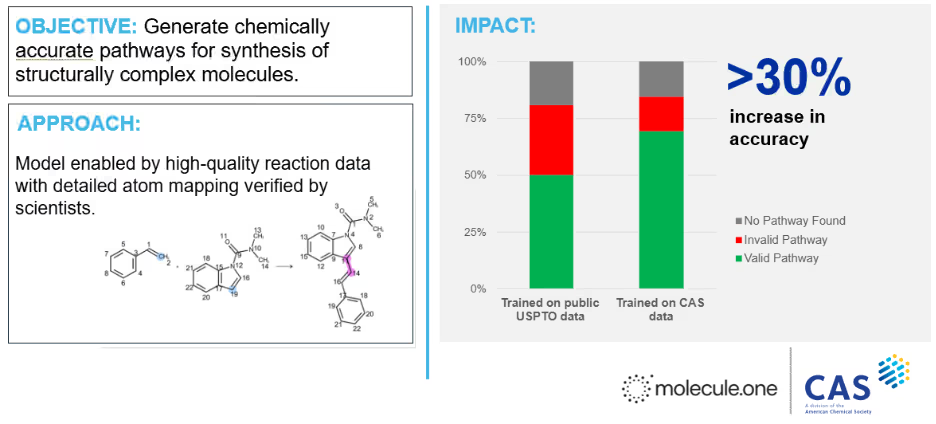
Figura 3: Estudo de caso desenvolvido em colaboração com a Molecule.One. O modelo de retrossíntese da Molecule.One, treinado com dados de reações públicas, foi retreinado usando dados da CAS, aproveitando os mapeamentos entre átomos de reagentes e produtos curados por cientistas, que são cruciais para previsões químicas precisas. Com os dados da CAS, a previsão precisa de rotas sintéticas válidas aumentou 30%, conforme avaliado por químicos sintéticos especialistas.
Em conjunto, mudanças criteriosas nessas cinco áreas podem aumentar a consistência do fluxo de trabalho, permitindo que a IA produza resultados nos quais os pesquisadores possam confiar e que possam reproduzir.
Perdendo oportunidades devido a dados desorganizados? Descubra como podemos conectar todos os seus dados e liberar todo o seu potencial.
Entre em contato com a equipe CAS
Construindo a base para uma IA cientificamente inteligente
Quando a IA está pronta para uso em P&D científico, suas previsões fornecem aos pesquisadores informações que eles podem interpretar, confiar e utilizar. Os sistemas atingem esse ponto quando apresentam desempenho consistente sob a variabilidade de experimentos reais, e não apenas durante testes controlados. Quando os modelos permanecem estáveis apesar das diferenças em instrumentos, formatos, condições ou fluxos de trabalho, a IA deixa de ser um projeto piloto exploratório e se torna uma ferramenta prática que fortalece a tomada de decisão científica. Nesse ponto, os pesquisadores podem confiar nos resultados da IA como parte previsível de seu trabalho diário, e as organizações podem começar a escalar seu uso em pipelines de P&D mais amplos.
Explore como esses princípios se traduzem em melhorias reais de P&D nos recursos de IA cientificamente inteligente da CAS.


