

La preparación para la IA no siempre requiere un mejor algoritmo. A veces, solo requiere una mejor curación y análisis de los datos.
Un estudio de caso publicado en PNAS lo demuestra. Los investigadores clasificaron casi 10.000 compuestos químicos utilizando un enfoque de aprendizaje automático estándar y solo lograron un 10% de precisión. Cuando CAS volvió a realizar el análisis con descriptores químicos de mayor calidad, la precisión aumentó al 45% (mejora media: 33%). El mismo modelo, una base más sólida.
Cuando los datos se aprovechan mejor, los equipos de investigación pueden identificar los mejores compuestos en horas en lugar de semanas. Sin embargo, llegar a ese punto tiene requisitos específicos.
Cuando la IA que implementas falla
Es una historia que se repite a menudo en los equipos de I+D científica encargados de aplicar la IA a sus investigaciones. El equipo:
- Invierte en infraestructura.
- Contrata a científicos de datos.
- Realiza pruebas piloto.
- Prueba los sistemas de IA.
- Revisa los brillantes resultados de las pruebas.
Y solo entonces descubren que sus modelos de IA fallan al enfrentarse a condiciones reales. ¿Y lo que es peor? Los brillantes resultados nunca se materializan.
Ajustan el algoritmo, añaden más datos, modifican los parámetros. Sigue sin funcionar. El instinto es culpar al modelo.
Resultados como esos señalan una brecha en la preparación para la IA.
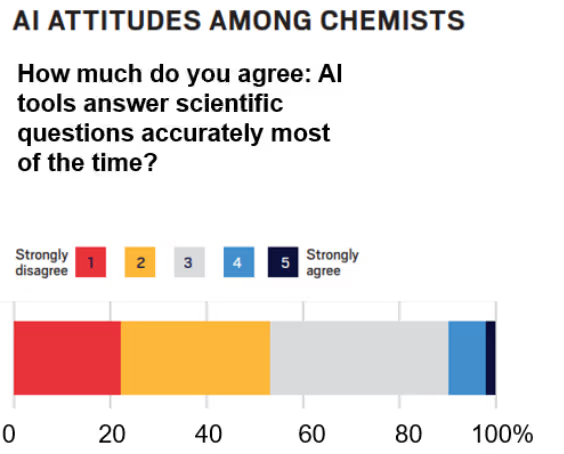
Figura 1: Fuente: Informe de la encuesta C&EN BrandLab Marketing for the Chemical Sciences 2025.
Aunque los equipos fortalezcan su infraestructura digital, a menudo siguen teniendo dificultades para lograr que la IA en I+D funcione de manera coherente en la investigación diaria.
Los datos científicos varían con frecuencia en estructura o calidad, y esta variación afecta a la precisión con la que los algoritmos pueden interpretar la información que reciben. Como resultado, los modelos que funcionan bien en pruebas controladas a menudo ofrecen un rendimiento inferior cuando se exponen a las condiciones irregulares de los experimentos reales. Por ejemplo, los conjuntos de datos de evaluación pueden ser «demasiado limpios» o demasiado similares a los datos de entrenamiento. También pueden no reflejar el ruido del mundo real, los valores atípicos, la deriva experimental o la diversidad total de casos con los que se encuentran los investigadores.
Los modelos entrenados con datos incompletos o incoherentes nunca funcionan bien desde el principio. La falta de contexto específico del dominio en los procesos de IA, como ontologías químicas precisas, restricciones mecanísticas o anotaciones seleccionadas por expertos, también puede causar problemas de precisión que no se derivan de la calidad de los datos en sí, sino de la ausencia de estructuras científicas. Esta brecha introduce incertidumbre, lo que dificulta la integración de la IA en los flujos de trabajo de I+D.
No se trata solo de ajustar los procesos actuales para que funcionen en un entorno ligeramente diferente. Prepararse para utilizar la IA como parte de su infraestructura central de I+D es una tarea importante. Hacerlo mal puede desperdiciar presupuestos, provocar el fracaso de proyectos piloto, disuadir a la dirección de invertir los recursos necesarios y hacer que sus investigadores se muestren escépticos sobre los beneficios.
Tres áreas en las que las organizaciones tienen dificultades para utilizar la IA en los flujos de trabajo de I+D
Muchas organizaciones que trabajan para implementar la IA en la I+D científica se encuentran con obstáculos operativos similares.
La mayoría de estos problemas se agrupan en un pequeño conjunto de patrones recurrentes que limitan la preparación para la IA. Las siguientes áreas representan las fuentes de fricción más comunes:
1. La alineación de sistemas se convierte en un desafío cuando las herramientas que almacenan y procesan datos científicos no pueden intercambiar información de forma limpia. Esta falta de alineación suele manifestarse de varias maneras:
- Los ELN (cuadernos de laboratorio electrónicos) y los LIMS (sistemas de gestión de información de laboratorio) suelen almacenar información en formatos incompatibles.
- Los equipos deben ajustar manualmente los registros cuando los datos se mueven entre sistemas.
- Los ajustes manuales ralentizan el trabajo piloto y aumentan el riesgo de errores.
- Los procesos se vuelven inestables cuando los metadatos se recrean o renombran durante las transferencias.
En conjunto, estas interrupciones cortan el flujo de información e impiden que los modelos funcionen de forma coherente en las tareas científicas rutinarias.
2. Las transferencias manuales y las interrupciones de procesos erosionan la trazabilidad a lo largo del flujo de trabajo. Cuando los datos se mueven entre sistemas o equipos a través de canales informales como exportaciones, correos electrónicos y hojas de cálculo, se pierde el contexto:
- Los registros llegan sin los metadatos necesarios para interpretarlos.
- Cuando un modelo produce resultados inesperados, los equipos tienen dificultades para reconstruir cómo se generaron las entradas.
- Resulta difícil determinar si un problema se originó en los datos o en una brecha del proceso.
- Las investigaciones se prolongan y los científicos pasan más tiempo buscando la procedencia que analizando los resultados.
La fragmentación del flujo de trabajo crea brechas de comunicación. Esto es especialmente costoso cuando los datos cruzan las líneas departamentales. En Calibr-Skaggs, los equipos de biología y química medicinal verificaban manualmente hasta 1000 compuestos nuevos al día, lo que ralentizaba las decisiones de continuar o no con un proyecto. CAS optimizó su proceso con una integración de API que permitió a ambos equipos trabajar en paralelo, eliminando los retrasos causados por las transferencias secuenciales.
3. Una coordinación deficiente entre equipos puede debilitar la preparación para la IA con el paso del tiempo.
Otro desafío común surge cuando los grupos de ciencia, datos y TI basan sus expectativas sobre la estructura, los estándares y el significado de los datos en objetivos, procesos y plataformas distintos. Si bien algunas de estas desconexiones pueden ser tan simples como reglas inconsistentes para nombrar, versionar u organizar registros, otros casos son el resultado de diferencias fundamentales en el significado. Estas inconsistencias tienden a aparecer cuando:
- Cada grupo aplica sus propias convenciones para las definiciones, la estructura y la organización de los datos.
- Las diferencias requieren un esfuerzo manual considerable para armonizarlas, lo que ralentiza el flujo de datos e introduce posibilidades de error.
- Los equipos de IA carecen de conocimiento sobre las diferencias en los estándares iniciales, lo que da lugar a soluciones de IA imprecisas e inutilizables.
Con el tiempo, estas inconsistencias se vuelven más difíciles de gestionar y afectan a la confianza en los resultados de la IA. Hemos observado este tipo de situaciones cuando se encarga a científicos experimentales el desarrollo de una estrategia de datos completa, pero requieren formación adicional para manejar diversos formatos de datos. Esta es otra forma en la que el personal de CAS colabora con socios como Toray, ayudando a formalizar los procesos de gobernanza de datos.
Cinco indicadores de preparación para la IA en I+D
Las organizaciones bien posicionadas para escalar la IA comparten un conjunto coherente de características de flujo de trabajo. Estas cinco características reflejan cómo unos datos, herramientas y revisiones científicas eficaces respaldan modelos capaces de adaptarse a condiciones experimentales cambiantes, resolver ambigüedades específicas del dominio e incorporar cambios continuos al conocimiento subyacente.
1. Gobernanza de datos que dirige las decisiones científicas y técnicas
Una gobernanza sólida es un indicador clave de la preparación para la IA, ya que aclara el proceso mediante el cual se toman las decisiones sobre datos y modelos. En entornos maduros, la propiedad de los conjuntos de datos y sus reglas de organización están definidas, y los equipos saben quién es responsable de aprobar los cambios en el comportamiento del modelo. Estas expectativas se integran en los flujos de trabajo científicos existentes, garantizando que las decisiones se tomen en el contexto adecuado.
También es importante mantener un registro compartido de todos los conjuntos de datos y actualizaciones de modelos, completo con marcas de tiempo y justificaciones, para crear la pista de auditoría que requiere la supervisión estructurada. Cualquier cambio que afecte a los flujos de trabajo posteriores también debería activar una revisión interfuncional, garantizando que las decisiones tomadas en una parte del proceso no introduzcan fallos en otras.
Cuando la gobernanza funciona de esta manera, los equipos pueden realizar un seguimiento de qué cambió, por qué cambió y cómo afectan esas actualizaciones al rendimiento de la IA en todo el flujo de trabajo de I+D.
2. Metadatos completos y científicamente significativos
Las organizaciones preparadas para la IA tratan los metadatos como la información que hace que los registros científicos sean interpretables y procesables. Los metadatos describen cómo se prepararon las muestras, cómo se representaron las estructuras, qué identificadores se asignaron y cuál fue el origen de cada registro. Los equipos con un alto nivel de preparación se aseguran de que estos detalles estén completos y se expresen de forma coherente, de modo que los registros no entren en conflicto cuando se transfieran entre sistemas. También mantienen un historial de cómo evolucionó cada registro. Unos metadatos estables y bien estructurados permiten a los sistemas de IA interpretar las entradas con mayor precisión, reduciendo la incertidumbre que a menudo surge más adelante en el flujo de trabajo.
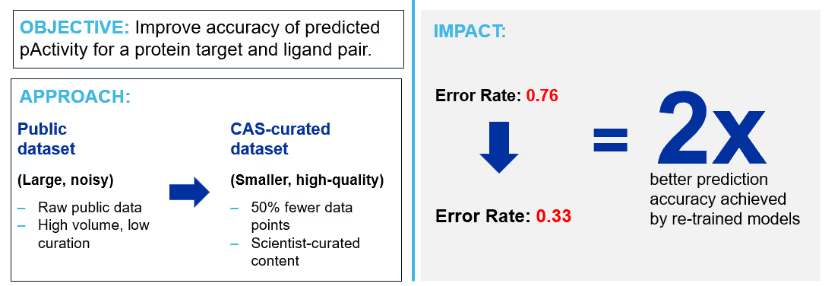
Figura 2: Caso práctico de CAS que muestra el impacto del contenido de alta calidad, curado por científicos, en la precisión predictiva de la actividad biológica de un ligando frente a una diana proteica. Al utilizar contenido curado por CAS en lugar de datos públicos ruidosos, el modelo duplicó su precisión de predicción utilizando un conjunto de datos de entrenamiento que era la mitad del tamaño del original.
3. Interoperabilidad entre ELN, LIMS y entornos de modelado
La interoperabilidad es otro indicador de preparación, ya que refleja la fluidez con la que circula la información a través de los sistemas de I+D. En entornos maduros, los datos se transmiten a través de API mantenidas en lugar de transferencias manuales, y las estructuras de los conjuntos de datos permanecen coherentes a medida que la información se intercambia entre ELN, LIMS y herramientas de modelado. Esto evita cambios inesperados en campos o etiquetas que, de otro modo, interrumpirían los procesos.
Una terminología coherente en todos los sistemas garantiza que los registros conserven su significado a medida que avanzan por el flujo de trabajo. Soluciones como una API personalizada pueden aplicar estándares de metadatos entre equipos para mejorar la coherencia, una estrategia que ha demostrado su éxito en organizaciones de descubrimiento de fármacos que cuentan con equipos interfuncionales que proporcionan datos.
Cuando la interoperabilidad funciona bien, los modelos reciben entradas que coinciden con las condiciones reales de laboratorio, lo que mejora la estabilidad durante la implementación.
4. Sistemas que mantienen la fiabilidad a medida que evolucionan los flujos de trabajo
Otro indicador de la preparación para la IA es la capacidad de una organización para mantener la fiabilidad de los modelos a medida que aumenta el volumen de datos y evoluciona el conocimiento científico. Los entornos maduros mantienen los conjuntos de datos versionados, lo que permite reproducir resultados anteriores, y conservan registros que almacenan los datos, las configuraciones y los resultados de evaluación asociados a cada modelo. La supervisión automatizada detecta cambios inesperados en el rendimiento y los registros de configuración permiten a los equipos comprender cómo se crearon los modelos.
Estas prácticas proporcionan visibilidad sobre el comportamiento del modelo, lo que respalda la toma de decisiones científicas informadas a medida que evolucionan los flujos de trabajo. Esto también garantiza que los resultados científicos y las evaluaciones de los modelos puedan reproducirse meses o años después, un requisito para las normas reglamentarias y de publicación.
5. Validación con intervención humana integrada en los flujos de trabajo científicos
Las organizaciones preparadas para la IA garantizan que la revisión científica siga siendo el centro de su flujo de trabajo. Dado que la IA no puede determinar si sus predicciones se ajustan a las condiciones de laboratorio, los investigadores revisan los resultados en puntos definidos para confirmar que se alinean con las expectativas experimentales. Los criterios de validación reflejan lo que es factible en el laboratorio y las limitaciones de los métodos subyacentes. Estas comprobaciones se realizan antes de que los resultados pasen a la siguiente fase y los revisores documentan el razonamiento de cada decisión. La comparación periódica de las predicciones con los resultados experimentales proporciona a los equipos una comprensión más clara del comportamiento de los modelos a lo largo del tiempo y refuerza la confianza en su uso.
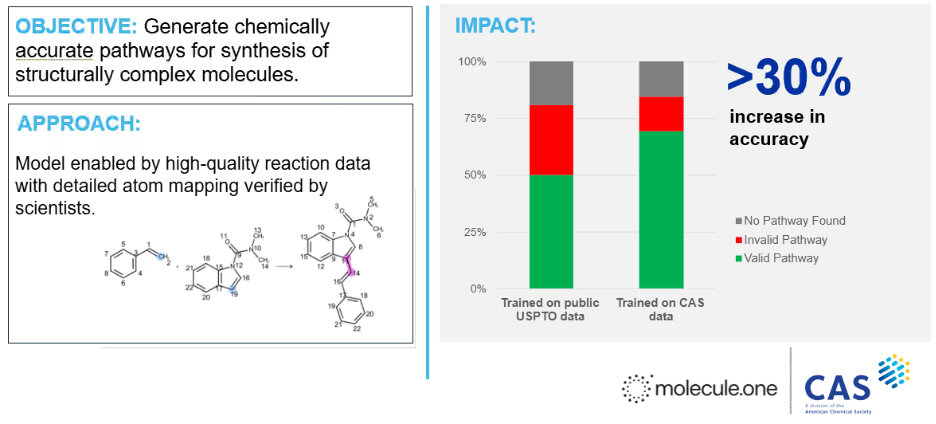
Figura 3: Caso práctico desarrollado en colaboración con Molecule.One. El modelo de retrosíntesis de Molecule.One, entrenado con datos de reacciones públicas, se volvió a entrenar utilizando datos de CAS, aprovechando los mapeos entre átomos de reactivos y productos curados por científicos, fundamentales para realizar predicciones químicas precisas. Con los datos de CAS, la predicción precisa de rutas sintéticas válidas aumentó un 30%, según la valoración de químicos sintéticos expertos.
En conjunto, realizar cambios meditados en estas cinco áreas puede mejorar la coherencia del flujo de trabajo, permitiendo que la IA produzca resultados en los que los investigadores puedan confiar y que puedan reproducir.
¿Pierde oportunidades debido a datos desorganizados? Descubra cómo podemos conectar todos sus datos y liberar todo su potencial.
Contacte con el equipo de CAS
Sentar las bases para una IA inteligente aplicada a la ciencia
Cuando la IA está lista para su uso en I+D científica, sus predicciones ofrecen a los investigadores información que pueden interpretar, en la que pueden confiar y sobre la que pueden actuar. Los sistemas alcanzan este punto cuando funcionan de forma coherente bajo la variabilidad de los experimentos reales, y no solo durante las pruebas controladas. Cuando los modelos permanecen estables a pesar de las diferencias en instrumentos, formatos, condiciones o flujos de trabajo, la IA pasa de ser un proyecto piloto exploratorio a una herramienta práctica que refuerza la toma de decisiones científicas. Es entonces cuando los investigadores pueden confiar en los resultados de la IA como una parte predecible de su trabajo diario, y las organizaciones pueden empezar a ampliar su uso a través de canales de I+D más amplios.
Descubra cómo se traducen estos principios en mejoras reales de I+D en los recursos de IA inteligente de CAS.


