


Resumo executivo
- A qualidade dos dados é o fator decisivo para a IA na ciência.
- A integridade e a harmonização de dados são disciplinas conduzidas por humanos, e não puramente automatizadas.
- Dados harmonizados produzem melhorias mensuráveis no desempenho de modelos de IA.
- "Dados obscuros" representam um recurso significativo e inexplorado para pesquisas impulsionadas por IA.
- A adoção de IA em campos científicos está acelerando rapidamente, mas a infraestrutura de dados continua sendo o fator limitante.
Não há dúvida de que a inteligência artificial (IA) revolucionou a investigação científica com sua capacidade de analisar conjuntos de dados incrivelmente vastos. A capacidade da IA para dados e sua velocidade computacional superam o que os humanos são capazes de fazer, e a tecnologia continuará a redefinir o que é possível na descoberta científica.
No entanto, também não há dúvida de que o conceito de "lixo entra, lixo sai" é verdadeiro — algoritmos e modelos de IA só podem produzir resultados tão confiáveis quanto os dados que os alimentam. O problema da qualidade dos dados é tão antigo quanto a própria ciência — nenhuma hipótese pode ser validada repetidamente se for baseada em dados falhos —, mas o estabelecimento da investigação impulsionada por IA, juntamente com o volume absoluto de dados disponíveis hoje, torna essa questão exponencialmente mais desafiadora.
Uma grande parte da solução é a harmonização de dados, que fornece a modelos de conjunto, grandes modelos de linguagem (LLMs) e outros tipos de sistemas de IA dados corretos e consistentes. Dados de qualidade fazem a diferença, por exemplo, em casos de uso bem-sucedidos de IA na biomedicina e na ciência dos materiais. Essas são duas áreas onde a complexidade dos dados — em estruturas proteicas, estruturas atômicas, DNA e muito mais — ressalta a necessidade de dados limpos e harmonizados para modelos de IA.
Nossa curadoria da CAS Content CollectionTM, o maior repositório de informações científicas com curadoria humana, nos oferece insights inigualáveis sobre as melhores práticas de harmonização de dados. Vamos explorar como isso funciona e examinar o papel frequentemente negligenciado da experiência humana ao impulsionar descobertas bem-sucedidas com o auxílio da IA:
Modelos de IA para química: o cenário atual e o que está por vir
A IA impulsiona a descoberta mais rápida de medicamentos e a identificação de novos materiais. Estamos vendo uma proliferação de tipos de modelos tanto na biomedicina quanto na ciência dos materiais e, ao realizar análises de coocorrência de conceitos, os pesquisadores podem identificar tendências emergentes em abordagens de modelagem. Este olhar aprofundado sobre as ferramentas e técnicas específicas para aplicar a IA às ciências da vida e à ciência dos materiais revela onde a tecnologia de IA está causando impacto agora e para onde ela está indo:

Integridade e harmonização de dados: a base para construir o sucesso da IA
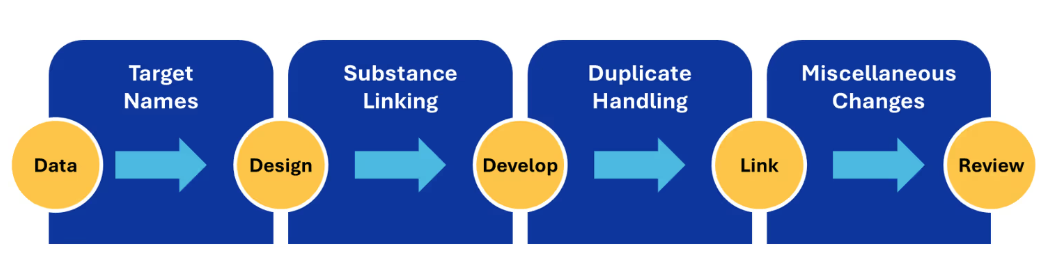
Aproveitar a IA para a investigação científica requer dados limpos e padronizados. A correção de erros e a orquestração de fluxos de trabalho são etapas críticas para construir a base de dados necessária, mas a experiência humana continua sendo uma parte fundamental desses esforços ao padronizar e validar as entradas de dados. Vemos benefícios tangíveis em modelos preditivos e análises avançadas ao usar dados harmonizados — um lembrete de que as pessoas ainda são uma parte vital para aproveitar as tecnologias mais avançadas.
IA na indústria farmacêutica: liderando esforços no reposicionamento de medicamentos
Pesquisadores farmacêuticos têm acesso a grandes volumes de dados sobre formulações de medicamentos, ensaios clínicos arquivados e registros eletrônicos de saúde, para citar apenas algumas fontes. Aproveitar esses dados adequadamente pode revelar insights importantes para o reposicionamento de medicamentos existentes, uma estratégia poderosa para atender às necessidades dos pacientes. Como eles podem fazer isso? Com uma solução de gestão de conhecimento que resulta em dados limpos e padronizados para potencializar ferramentas de IA de forma eficaz.
Ter uma grande variedade de dados pode aumentar significativamente o potencial da IA no desenvolvimento farmacêutico e acelerar seu pipeline de reposicionamento. No entanto, mais dados não significam necessariamente dados melhores.
Modelos preditivos: acelerando a descoberta de medicamentos com qualidade de dados
Prever a atividade ligante-alvo ou perfis de metabólitos são resultados críticos da modelagem na descoberta de medicamentos, mas obter resultados confiáveis exige uma ampla harmonização de dados. Esta conversa entre cientistas da CAS explica por que a curadoria humana de dados desempenha um papel tão importante na preparação das informações que impulsionam a modelagem preditiva. Descubra quais são alguns dos principais desafios no desenvolvimento de modelos e como a CAS aborda o treinamento contínuo de modelos para manter nossas soluções atualizadas.
White Paper
Cinco estratégias de gestão de conhecimento para o seu fluxo de trabalho de P&D
Os pesquisadores entendem a importância de eliminar silos de dados e garantir que as informações científicas sejam limpas e consistentes. Mas quais são as melhores práticas para implementar essas etapas? Neste white paper, compartilhamos cinco dicas de gestão de conhecimento para melhorar os fluxos de trabalho de P&D científico. Baixe o white paper hoje mesmo:
O que vem a seguir na harmonização de dados
Não sendo mais uma inovação distante, as soluções baseadas em IA são hoje uma parte central da descoberta científica. Modelos de IA podem identificar novos compostos e materiais, detectar oportunidades de reposicionamento de medicamentos e analisar a extraordinária quantidade de dados disponíveis em todas as disciplinas científicas. Mas esses modelos exigem dados limpos e padronizados para gerar insights de qualidade, e chegar a esse estado depende tanto da experiência humana quanto da capacidade tecnológica.
Dados científicos existem em tabelas, diagramas e materiais suplementares de publicações. Organizações de pesquisa possuem todos os tipos de "dados obscuros" (dark data) que não são estruturados, mas contêm insights valiosos. Ao colaborar com especialistas em dados e construir uma base sólida de dados harmonizados, os pesquisadores podem utilizar plenamente todas as informações que possuem e obter benefícios significativos de modelos e algoritmos de IA.
Links
Mais recursos
Organizações que enfrentam desafios de harmonização de dados, seja digitalizando registros legados, normalizando bibliotecas de compostos ou preparando conjuntos de dados para modelagem de IA, podem discutir soluções de dados personalizadas projetadas em torno de domínios científicos específicos e da infraestrutura existente.
Leitura complementar
- Estabelecendo novos padrões para a precisão de previsão de IA com dados de treinamento personalizados
- Transforme dados farmacêuticos inexplorados em P&D.
- Conjunto de dados de treinamento de aprendizado de máquina com curadoria personalizada acelera a otimização do fluxo de trabalho de síntese orgânica
- Como modelos de IA de conjunto entregam melhores resultados científicos
- Seis exemplos que demonstram como a IA está ajudando a impulsionar pesquisas científicas de ponta


