


Resumen ejecutivo
- La calidad de los datos es el factor determinante para la IA en la ciencia.
- La integridad y la armonización de los datos son disciplinas dirigidas por humanos, no puramente automatizadas.
- Los datos armonizados producen mejoras medibles en el rendimiento de los modelos de IA.
- Los "datos oscuros" representan un recurso significativo sin explotar para la investigación impulsada por IA.
- La adopción de la IA en los campos científicos se está acelerando rápidamente, pero la infraestructura de datos sigue siendo el factor limitante.
No cabe duda de que la inteligencia artificial (IA) ha revolucionado la investigación científica gracias a su capacidad para analizar conjuntos de datos increíblemente vastos. La capacidad de la IA para procesar datos y su velocidad computacional superan lo que los humanos pueden lograr, y la tecnología seguirá redefiniendo lo que es posible en el descubrimiento científico.
Sin embargo, tampoco hay duda de que el concepto de "basura entra, basura sale" es cierto: los algoritmos y modelos de IA solo pueden producir resultados tan fiables como los datos que los alimentan. El problema de la calidad de los datos es tan antiguo como la propia ciencia —ninguna hipótesis puede validarse repetidamente si se basa en datos erróneos—, pero el establecimiento de la investigación impulsada por IA, junto con el enorme volumen de datos disponibles hoy en día, hace que este problema sea exponencialmente más difícil.
Una gran parte de la solución es la armonización de datos, que proporciona a los modelos de conjunto, los modelos de lenguaje extensos (LLM) y otros tipos de sistemas de IA datos correctos y coherentes. Los datos de calidad marcan la diferencia, por ejemplo, en casos de uso exitosos de IA en biomedicina y ciencia de materiales. Estos son dos campos donde la complejidad de los datos (en estructuras proteicas, estructuras atómicas, ADN y más) subraya la necesidad de contar con datos limpios y armonizados para los modelos de IA.
Nuestra curación de la CAS Content CollectionTM, el repositorio de información científica curado por humanos más grande del mundo, nos brinda una perspectiva inigualable sobre las mejores prácticas de armonización de datos. Exploremos cómo funciona y examinemos el papel, a menudo pasado por alto, de la experiencia humana a la hora de impulsar descubrimientos exitosos mediante IA:
Modelos de IA para la química: el panorama actual y lo que está por venir
La IA impulsa un descubrimiento de fármacos más rápido y la identificación de nuevos materiales. Estamos viendo una proliferación de tipos de modelos tanto en biomedicina como en ciencia de materiales, y al realizar un análisis de coocurrencia de conceptos, los investigadores pueden detectar tendencias emergentes en los enfoques de modelado. Este análisis detallado de las herramientas y técnicas específicas para aplicar la IA a las ciencias de la vida y la ciencia de materiales revela dónde está teniendo impacto la tecnología de IA ahora y hacia dónde se dirige:

Integridad y armonización de datos: la base para construir el éxito de la IA
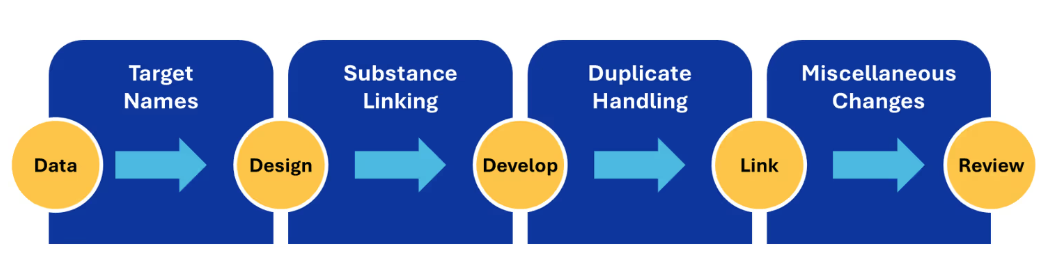
Aprovechar la IA para la investigación científica requiere datos limpios y estandarizados. La corrección de errores y la orquestación de flujos de trabajo son pasos críticos para construir la base de datos necesaria, pero la experiencia humana sigue siendo una parte clave de estos esfuerzos al estandarizar y validar las entradas de datos. Observamos beneficios tangibles en los modelos predictivos y el análisis avanzado cuando utilizamos datos armonizados, lo que nos recuerda que las personas siguen siendo una parte vital para aprovechar las tecnologías más avanzadas.
IA en la industria farmacéutica: liderando los esfuerzos en el reposicionamiento de fármacos
Los investigadores farmacéuticos tienen acceso a grandes volúmenes de datos sobre formulaciones de medicamentos, ensayos clínicos archivados y registros médicos electrónicos, por mencionar solo algunas fuentes. Aprovechar estos datos adecuadamente puede revelar información valiosa para el reposicionamiento de fármacos existentes, una estrategia eficaz para atender las necesidades de los pacientes. ¿Cómo pueden lograrlo? Con una solución de gestión del conocimiento que genere datos limpios y estandarizados para potenciar las herramientas de IA de manera efectiva.
Disponer de una gran variedad de datos puede mejorar significativamente el potencial de la IA en el desarrollo farmacéutico y acelerar su proceso de reposicionamiento. Sin embargo, más datos no significan necesariamente mejores datos.
Modelos predictivos: acelerar el descubrimiento de fármacos mediante la calidad de los datos
Predecir la actividad ligando-objetivo o los perfiles de metabolitos son resultados críticos del modelado en el descubrimiento de fármacos, pero obtener resultados fiables requiere una armonización exhaustiva de los datos. Esta conversación entre científicos de CAS explica por qué la curación humana de datos desempeña un papel tan importante en la preparación de la información que impulsa el modelado predictivo. Descubra cuáles son algunos de los desafíos clave en el desarrollo de modelos y cómo CAS aborda el entrenamiento continuo de modelos para mantener nuestras soluciones actualizadas.
Libro blanco
Cinco estrategias de gestión del conocimiento para su flujo de trabajo de I+D
Los investigadores comprenden la importancia de eliminar los silos de datos y garantizar que la información científica sea limpia y coherente. Pero, ¿cuáles son las mejores prácticas para implementar estos pasos? En este libro blanco, compartimos cinco consejos de gestión del conocimiento para mejorar los flujos de trabajo de I+D científica. Descargue el libro blanco hoy mismo:
El futuro de la armonización de datos
Las soluciones basadas en IA, que ya no son una innovación lejana, son una parte fundamental del descubrimiento científico actual. Los modelos de IA pueden identificar compuestos y materiales novedosos, detectar oportunidades de reposicionamiento de fármacos y analizar la extraordinaria cantidad de datos disponibles en todas las disciplinas científicas. Sin embargo, estos modelos requieren datos limpios y estandarizados para generar información de calidad, y alcanzar ese estado depende tanto de la experiencia humana como de la capacidad tecnológica.
Los datos científicos existen en tablas, diagramas y materiales complementarios de publicaciones. Las organizaciones de investigación poseen todo tipo de "datos oscuros" que no están estructurados pero que contienen información valiosa. Al colaborar con expertos en datos y construir una base sólida de datos armonizados, los investigadores pueden utilizar plenamente toda la información de la que disponen y obtener beneficios significativos de los modelos y algoritmos de IA.
Enlaces
Más recursos
Las organizaciones que se enfrentan a retos de armonización de datos, ya sea digitalizando registros antiguos, normalizando bibliotecas de compuestos o preparando conjuntos de datos para modelos de IA, pueden consultar soluciones de datos personalizadas diseñadas en torno a dominios científicos específicos y a la infraestructura existente.
Lecturas adicionales
- Establecimiento de nuevos estándares de precisión en predicciones de IA con datos de entrenamiento personalizados
- Transforme los datos farmacéuticos sin explotar en I+D.
- Un conjunto de datos de entrenamiento de aprendizaje automático seleccionado a medida acelera la optimización del flujo de trabajo de síntesis orgánica
- Cómo los modelos de IA de conjunto ofrecen mejores resultados científicos
- Seis ejemplos que demuestran cómo la IA ayuda a impulsar la investigación científica de vanguardia


