

执行摘要
在现代科学研究领域,人工智能(AI)已成为一股变革力量,从根本上改变了研究人员构思、开展和验证工作的方式。计算能力、先进算法和海量数据集的融合,推动人工智能从理论上的可能性转变为各科学学科的实际需求。
这场革命解决了长期以来限制科学进步的若干挑战:基因组学、医学和材料科学等领域产生的数据量过大;药物研发等流程耗时且成本高昂;以及在生成假设时的认知局限。人工智能为克服这些挑战并加速各科学学科的突破提供了充满希望的新路径。
例如,在生物医学领域,人工智能彻底改变了蛋白质结构预测,加速了药物研发进程,并实现了个性化医疗。同样,在材料科学领域,人工智能正在加速新型材料的发现。这些进展为自动驾驶实验室和逆向设计框架铺平了道路,正在改变科学研究方法本身。人工智能还通过实现实时实验调整来提高产量和效率,同时减少浪费和成本,从而显著推进了流程优化。
我们对CAS Content CollectionTM进行了定量分析,这是全球最大的人工标引科学信息库,旨在了解这些技术进步在科学发现中的应用与影响。我们系统地分析了 CAS Content Collection 中 2015 年至 2025 年间的 31 万多篇期刊论文和专利,运用先进的分析技术识别出与人工智能相关的出版物及其关联的方法论、机构和研究领域。
我们的研究探讨了人工智能方法在各科学领域的分布情况,并对生物医学和材料科学这两个关键领域进行了深入分析。这些分析详细阐述了主导概念、人工智能方法的共现模式以及重要的物质类别。此外,我们还调查了人工智能在优化工业流程和新兴应用中的作用。
这些研究结果为当前人工智能在科学研究中的整合现状及发展轨迹提供了重要见解,为研究人员、机构和政策制定者了解技术采用模式、识别合作机会以及就未来人工智能投资和研究方向做出明智的战略决策提供了宝贵指导。
科学领域人工智能模型的版图
为了理解特定模型被选用的背景及其影响,我们对包含人工智能方法的科学出版物(包括期刊和专利族)进行了全面分析。整个版图的可视化展示了随着更多模型和功能的开发,这些技术在各科学学科中的整合程度日益加深(见图 1)。

该可视化图表的主要分支包括:
分类、回归和聚类模型
分类模型旨在预测离散标签或类别,在处理高维数据和提供可解释结果方面尤为有效。常见模型包括决策树(DT),该模型通过递归地将数据拆分为分支来对结果进行分类。随机森林(RF)是决策树的集合,通过平均预测结果来减少过拟合。另一种常见模型是支持向量机(SVM),它能找到类别之间的最优边界,而 K-近邻算法(KNN)则根据最近邻居的多数类别进行分类。
这些模型广泛应用于具有分类结果的标记数据集(监督学习),例如光谱学、显微学或已知类别的组学数据。应用示例包括根据基因表达或成像数据对疾病类型进行分类、预测材料类别,以及根据毒性或反应性对化合物进行分类。
回归模型用于预测连续数值,是预测和优化的理想选择。文献中常见的回归模型包括线性回归、逻辑回归、支持向量回归(SVR)和符号回归。这些模型适用于来自实验、模拟的数值数据,或来自传感器和仪器的时序数据。应用领域包括预测能级、衰变率或粒子轨迹、估算反应产率、分子性质、模拟温度、降水量,以及预测电导率、硬度和带隙。
与分类和回归不同,聚类模型可以发现未标记数据中的自然分组,揭示隐藏结构并支持探索性分析(无监督学习)。这些模型对于高维、未标记的数据集(如成像、光谱和分子数据)非常有效。适用于此类模型的科学数据包括但不限于根据表达谱对基因或样本进行分组,以及从结构数据中发现新的材料家族。
人工神经网络(ANNs)
人工神经网络(ANNs)是一类旨在通过互连的人工神经元层来学习复杂模式的机器学习(ML)模型。它们在建模数据中复杂的非线性关系方面表现出色。因此,它们构成了深度学习的基础,也是现代人工智能的基石,并衍生出多种专用架构,例如用于序列数据的循环神经网络(RNNs)、能够更好地捕捉长距离依赖关系的增强型RNN——长短期记忆网络(LSTM),以及参数更少、结构更简化的门控循环单元(GRUs)。
这些模型适用于序列和时序数据,如基因表达、蛋白质序列、生理信号、气候数据、粒子物理和传感器网络数据。它们通常利用知识图谱(即针对特定领域概念及其关系的结构化表示)来增强图像与文本的对齐,从而弥合视觉数据(如医学影像)与文本描述(如临床记录或诊断报告)之间的语义鸿沟。它们在药物发现与开发、精准医疗、医学影像、材料发现与设计、能源存储、制造业和质量控制等领域的应用已呈激增之势。
混合方法
ANN与传统机器学习模型(如分类、回归和聚类)之间的比较,重点不在于孰优孰劣,而在于理解它们互补的作用。ANN在处理复杂、非结构化数据、大规模训练数据集以及需要表征学习的场景中占据主导地位。相反,传统机器学习在数据量较小、研究问题需要严格可解释性,以及输入数据具有明确统计关系且需要量化不确定性的情况下依然具有优势。
领域专用模型
尽管领域专用模型的相关文献较少,但其中不乏开创性成果,例如AlphaFold,这是一种在蛋白质结构预测方面达到近实验精度水平的深度学习方法。ESMFold是另一个引人注目的模型,它直接利用蛋白质语言建模,仅根据单个蛋白质序列即可生成高质量的结构预测。
自然语言处理(NLP)
NLP用于分析、理解、解释和生成人类语言。它涉及诸如分词(将文本分解为称为词元的较小单位,通常是单词或子词)等任务,以便算法进行处理。表示文本的一种常用方法是词袋(BoW)模型,它根据词频将文本转换为数值向量,而忽略语法和词序。另一项关键技术是命名实体识别(NER),用于识别并分类文本中的人名、组织机构和地点等实体。
NLP模型在生物医学文本挖掘和知识提取方面有着广泛的应用,范围涵盖了在生物医学文献上预训练的专用语言模型(如BioBERT、BioGPT)和电子健康记录(EHR)分析,到从临床记录中自动提取疾病特征,以及利用语言模型创建新型候选药物。在材料科学和化学领域,NLP已被用于合成方案提取、材料性质预测、知识库构建和逆向设计。
大语言模型(LLMs)
这一变革性的人工智能系统彻底改变了NLP,并在各个科学领域得到了广泛应用。大语言模型是基于神经网络的系统,通过在海量文本数据上进行训练来学习语言的统计模式。它们被用于信息提取、摘要生成、知识图谱构建、跨领域整合以及生成式应用。
被广泛采用的大语言模型包括生成式预训练变换器(GPT),它是ChatGPT、GPT-3.5和GPT-4背后的驱动力。双向编码器表示变换器(BERT)依然是顶尖的语言模型,凭借其双向上下文理解能力以及在问答和情感分析方面的卓越表现,在学术界保持着极高的关注度。
多语言模型BLOOM已成为研究领域的重要贡献者。谷歌DeepMind开发的GEMINI、Meta AI的LLAMA以及Anthropic开发的Claude等新模型也日益普及。2023年至2025年间推出的最新一代模型Gemma、Falcon、Mistral、Qwen和DeepSeek,展现出巨大的未来发展潜力。
一些针对化学、生命科学和材料科学的专用大语言模型也正在产生影响,例如chemLLM、PharmaGPT和MatSciBERT。
出版趋势显示人工智能对科学的影响
如前所述,我们分析了2015年至2025年间CAS内容合集中与科学研究中人工智能相关的310,000份文档。我们注意到整个期间呈现稳步增长,且在过去五年中增长尤为显著(见图2)。专利族数量的增加进一步表明,人工智能正从一种新兴技术演变为各行各业必不可少的研究工具。

- 按国家/地区及机构分布:中国在出版物(期刊和专利)数量上处于领先地位,而美国、印度、韩国和日本的出版物数量也呈现稳步增长(见图 3)。总体而言,数据凸显了亚洲已成为全球人工智能科学创新的新中心,而西方国家在定量产出方面目前处于落后位置。

- 专利族分布:我们进一步分析了前五大国家的期刊和专利出版趋势。中国和印度合计贡献了该领域全球 75% 以上的专利——专利申请量排名前 15 位的机构均来自中国和印度。中国高校在期刊出版数量上占据主导地位,其中大多数高校的平均被引频次在 10 到 20 次之间。相比之下,麻省理工学院 (MIT) 和斯坦福大学的平均被引频次显著更高,分别为 32 次和 66 次。这表明,尽管中国在数量上表现优异,但美国高校在人工智能领域期刊文章的质量和影响力方面仍处于领先地位。
- 特定出版物分布:我们分析了发表人工智能相关研究的领先科学期刊的出版数量和引文影响力。出版数量主要集中在 Scientific Reports、Applied Sciences 和 PLoS One。然而,若考量单篇文章的平均被引频次,《美国国家科学院院刊》(PNAS) 脱颖而出,尽管其出版数量相对适中,但每篇出版物的被引频次接近 50 次,展现出卓越的影响力。其他期刊如 《化学信息与建模杂志》(JCIM)、《生物信息学》(Bioinformatics) 和 《自然-通讯》(Nature Communications) 也表现出显著的平均被引频次,远超那些出版量巨大的期刊。这一模式表明,虽然像 Scientific Reports 这样涵盖面广的期刊发表了最多的人工智能相关研究,但像 PNAS、JCIM 和 Nature Communications 这样专业或权威的期刊发表了更具影响力、能产生更大科学价值的研究成果。
- 各科学领域趋势:众多领域已受到人工智能的深远影响,但有几个领域因出版物呈指数级增长而尤为突出(见图 4):

在所有学科中,工业化学与化学工程在期刊出版方面表现出最显著的增长,到 2024 年,其轨迹已达到总文献量的约 8%。这种卓越的增长可能反映了该领域在制造、流程优化和工业创新方面的广泛应用,以及其在开发可持续工业流程和绿色化学解决方案中的关键作用。
分析化学成为期刊出版方面增长第二快的领域,深蓝色线条显示从 2019 年起呈现强劲增长。这种强劲的增长模式展示了该领域在化学所有分支中的基础重要性,以及其在开发支持多学科研究的新型测量技术、仪器和分析方法方面的作用。
能源技术与环境化学表现出稳健增长,与生物化学并列成为增长最快的领域第三名。这反映了全球对气候变化、环境可持续性挑战及突发事件的迫切关注。
其余学科,包括物理化学、药理学、毒理学与制药、有机化学、无机化学、天然产物和合成聚合物,均表现出适度但持续的出版量增长。这些领域代表了科学研究的成熟领域,其基本原理已确立,但持续的研究仍能带来渐进式的进步与完善。
专利族数据呈现出与期刊出版截然不同的图景,其创新模式高度多样且集中,而非学术产出中那种统一的增长。这种对比凸显了学术研究生产力与商业化创新之间的根本区别,在后者中,市场力量、实际应用和经济激励在决定哪些科学进步能转化为可申请专利的知识产权方面起着决定性作用。
在专利方面,生物化学呈现出指数级增长,到 2024 年达到约 8%,完全盖过了其他所有学科。生物化学专利领域以生物医学方法为主导,并由融合了分子科学与先进医疗技术的创新所塑造。关键领域包括疾病检测、医学影像、可穿戴监测和临床决策支持,所有这些都利用了生物化学标记物。生物化学还推动了神经接口、基因组学、生物标志物发现、信号处理、手术导航和生物医学制造的进步,凸显了其在现代生物医学创新中的核心地位。这种剧烈的专利活动反映了对生命科学研究的强烈商业兴趣和投资,并在应对新冠疫情的过程中得到进一步提振,当时商业研究获得了大量资金支持。
基于我们的分析,我们发现大多数人工智能相关出版物与生物医学研究和材料科学有关。因此,我们对这些关键研究领域进行了深入分析,因为这些领域在数据集中占据主导地位,表现出快速的人工智能应用和显著的年度增长率,并产生更高的引文影响力,表明了其科学相关性。
人工智能模型在生物医学研究中的应用
概述
生物医学研究一直面临着复杂性和成本方面的持续挑战,而人工智能现在可以解决这些问题。例如,解析复杂的蛋白质结构和相互作用、药物开发中伴随的高成本和高失败率,以及理解多因素疾病机制的复杂性,都非常适合采用基于人工智能的方法。
人工智能驱动的科学研究的数据完整性。人工智能在数据处理能力和计算速度上超越了人类,这项技术将继续重新定义可能性的边界。然而,数据完整性和协调性是人工智能在科学领域任何成功应用的关键要素。
进行此项分析的初衷是通过使用文献频率作为客观指标来识别关键概念,从而确保对最重要的研究领域进行具有代表性的抽样。具体而言,我们利用生物医学领域内的多种人工智能/机器学习方法,识别出了引起了广泛科学兴趣和研究投入的概念(见图 5)。

In the Biochemistry domain, protein sequences and structures, gene and gene expression and DNA/genomics have emerged as the most extensively studied concepts, utilizing diverse machine learning approaches. ML models thrive in these areas due to data abundance and standardization, especially in complex systems like protein hierarchies and gene regulatory networks. ML excels in tasks such as sequence-function mapping, protein family classification, domain prediction, structure-function analysis, tumor feature selection, gene interaction prediction in cancer, and clustering genes by expression in patterns in oncology, leveraging high-dimensional expression data with thousands of genes measured simultaneously, complex non-linear relationships between genes and phenotypes, and hierarchical organization of genetic regulatory networks.
Advanced ML models like AlphaFold and BERT are used for protein structure prediction by learning from amino acid sequences and evolutionary patterns to predict 3D folding and functional domains. These models effectively handle complex spatial relationships and sequential inputs with long-range dependencies.
In the Modeling and Drug Design domain, QSAR modeling dominates this field. It utilizes ML methods to extract molecular descriptors (i.e., physicochemical properties, fingerprints) from chemical structures for predicting biological activities and toxicity endpoints through supervised learning approaches. These methods excel with feature rich molecular descriptors, structure-activity relationships, and quantitative endpoints suitable for regression tasks.
Molecular docking, the second most frequent concept, uses deep learning approaches (CNN and GNN) on 3D structural data and molecular graphs to predict protein-ligand binding poses and affinities, leveraging spatial conformations, energy landscapes, and molecular interactions. Pharmacokinetics follows as the next focus area, using ML to learn from molecular descriptors, physiological parameters, and time-series data for predicting ADMET properties (Absorption, Distribution, Metabolism, Excretion, Toxicity) and drug clearance rates.
Biomarkers dominate the Diagnostic domain where ML methods analyze high-dimensional genomics, proteomics, and metabolomics data to identify discriminative molecular signatures distinguishing disease states from healthy controls through feature selection and classification. AI methods are also used in prognosis research to analyze patient clinical data and treatment history for predicting survival times and disease progression through survival analysis techniques.
Medical imaging contains data from X-rays, CT, MRI, and structured spatial information that is ideal for deep learning methods. CNNs are widely used to analyze radiological images for tumor detection, fracture identification, disease classification, and pathological conditions through automated pattern recognition. Imaging can also benefit from the ability of deep learning to extract multi-scale features and perform segmentation tasks, particularly in cancer diagnosis where it aids in tumor detection, classification, malignancy assessment, and risk prediction.
In the Disease domain, cancer research received the highest attention, with various ML models applied based on the data types. Genomic and transcriptomic data are commonly analyzed using RF and SVM models for cancer subtype classification and treatment prediction. These tasks benefit from integrating multi-omics data, which captures diverse molecular layers, and from modeling the complexity of heterogeneous tumor microenvironments.
Various algorithms are used in diabetes research for predicting diabetic complications and optimizing treatment protocols taking advantage of longitudinal monitoring data, complex interactions between lifestyle factors and genetics, and time-series prediction problems for glucose levels. In Alzheimer's disease, RF and SVM models are widely used for early prediction by analyzing neuropsychological test scores, biomarker levels (amyloid-beta, tau proteins), and demographic data to classify patients into healthy or mild cognitive impairment categories.
In the Therapy domain, antitumor agents received the most research attention, employing ML methods for drug screening and activity prediction by analyzing molecular descriptors and chemical properties to identify compounds with potential anticancer activity. In chemotherapy, these methods predict treatment responses and toxicity by analyzing patient clinical data, genetic profiles, and tumor characteristics for personalizing drug selection and dosing protocols. Similarly, these models support immunotherapy by analyzing patient immune profiles, tumor mutational burden, and biomarker expressions to predict response and optimize therapeutic outcomes, addressing the complexity of immune interactions and temporal dynamics.
Co-occurrences of AI models and biomedical concepts
Our analysis explores the co-occurrence patterns between biomedical concepts and various AI/ML methods, elucidating their strategic applications across the five domains (see Figure 6).


Random Forest (RF) has emerged as the dominant AI method in biomedical research, showing remarkable growth and overtaking Support Vector Machine (SVM) between the two periods. RF shows strong co-occurrence with concepts across all the domains of biomedical sciences, particularly in biochemistry, diagnosis, and disease-related research. RF is used for protein function prediction and classification by analyzing amino acid composition, sequence motifs, and physicochemical properties to classify proteins into functional families. In biomarker discovery, RF is used to analyze high-dimensional genomics, proteomics, and metabolomics data.
Support vector machine (SVM) while growing steadily between the periods, maintains significant presence with proteins, gene expression, DNA and genomics, biomarkers, prognosis, medical imaging, and cancer research. In protein studies, SVM is used for protein classification and functional annotation by analyzing amino acid sequences, structural features, and physicochemical properties. It also predicts subcellular localization and identifies enzyme classes using kernel-based high-dimensional feature space mapping.
In gene expression, SVM identifies genes involved in specific biochemical processes, classifies metabolic pathways, and predicts enzyme-encoding genes based on their expression patterns across different biochemical conditions and cellular states. For genomic variant classification, SVM processes DNA sequence features and annotations to distinguish pathogenic from benign mutations and identify disease-associated genomic regions through high-dimensional feature analysis of nucleotide patterns and genomic context.
In biomarker research, SVM supports identification, classification, and validation by integrating multiple biomarkers into predictive models for diagnosis, treatment response, disease progression risk assessment, and stratifying patients for personalized medicine approaches. SVM is used in cancer research to distinguish between cancer and normal tissues, classify cancer types, and identify molecular subtypes within specific cancers. It is also used for cancer prognosis and treatment prediction by integrating clinical parameters, biomarker profiles, and genomic features to predict patient survival outcomes, treatment responses, drug resistance patterns, and recurrence risk. Figure 6B reveals that SVM maintained strength in QSAR and SAR modeling while its connections to protein analysis weakened relative to RF in the later period.
Logistic Regression (LR) is a widely used, interpretable statistical method in biomedical research, often co-occurring with key concepts such as proteins, gene expression, biomarkers, prognosis, medical imaging, cancer, and COVID-19. In protein function prediction, LR analyzes amino acid composition, sequence features, and structural properties to classify proteins into functional or structural categories. The model’s key advantage is providing interpretable coefficients that indicate the relative contribution of each feature to the classification decision, allowing researchers to identify which amino acid properties or structural features most strongly influence the predictions.
This interpretability is equally valuable in gene expression classification, where LR helps identify differentially expressed genes. For biomarker validation and diagnostics, LR models predict binary outcomes, such as disease/healthy or responder/non-responder and provide clinically meaningful odds ratios for diagnostic decision making. In prognostic modeling, LR uses a similar binary outcome prediction, by evaluating clinical parameters, biomarker profiles, and patient demographics to forecast outcomes like mortality/survival, disease recurrence/remission, favorable/unfavorable prognosis.
LR is used in COVID-19 diagnosis, severity prediction, and mortality by integrating comorbidities, vital signs, and biomarkers, supporting risk stratification and clinical decision-making. These diverse applications underscore LR’s strong alignment with core biomedical research themes, making it a foundational tool for interpretable and clinically relevant modeling. Figure 6B illustrates the increased adaptability of Logistic Regression, likely due to the capability for multi-class classification and probability-based outputs, unlike linear regression, which is limited to continuous predictions.
As seen in Figure 6B, the 2020-2024 period witnessed the emergence of specialized deep learning approaches barely present earlier, such as AlphaFold. This period also saw a surge in the use of Graph Neural Networks (GNN) for molecular interaction modeling, Graph Adversarial Networks (GAN) for synthetic data generation, and Pattern Recognition for imaging applications and diagnostic challenges.
近年来另一个重大转变是将自然语言处理(NLP)技术整合到生物医学研究中,以 BERT 为代表的模型在挖掘临床报告和分析生物医学文本方面的兴起便是明证。 这种专业化趋势反映了该领域已超越了通用人工智能方法的应用,正转向针对特定生物医学挑战开发定制化方案。
两个时期之间的研究重点发生了显著变化。2020年至2024年间,蛋白质序列与结构分析以及基因表达分析增长显著(图 6B)。生物标志物发现和成像应用也经历了大幅增长,而疾病专项研究则显著扩展,其中 COVID-19 成为主要焦点,癌症研究也在多个亚型中呈现多元化发展。
生物医学研究中的物质
这一比较为探索不足的治疗机会提供了战略洞察,并突显了那些可能受益于增加研究投入或创新方法以弥合科学发现与临床应用之间差距的物质类别(见图 7)。请注意,“物质类别”是指具有公认潜在治疗应用价值的 CAS 索引物质类别。
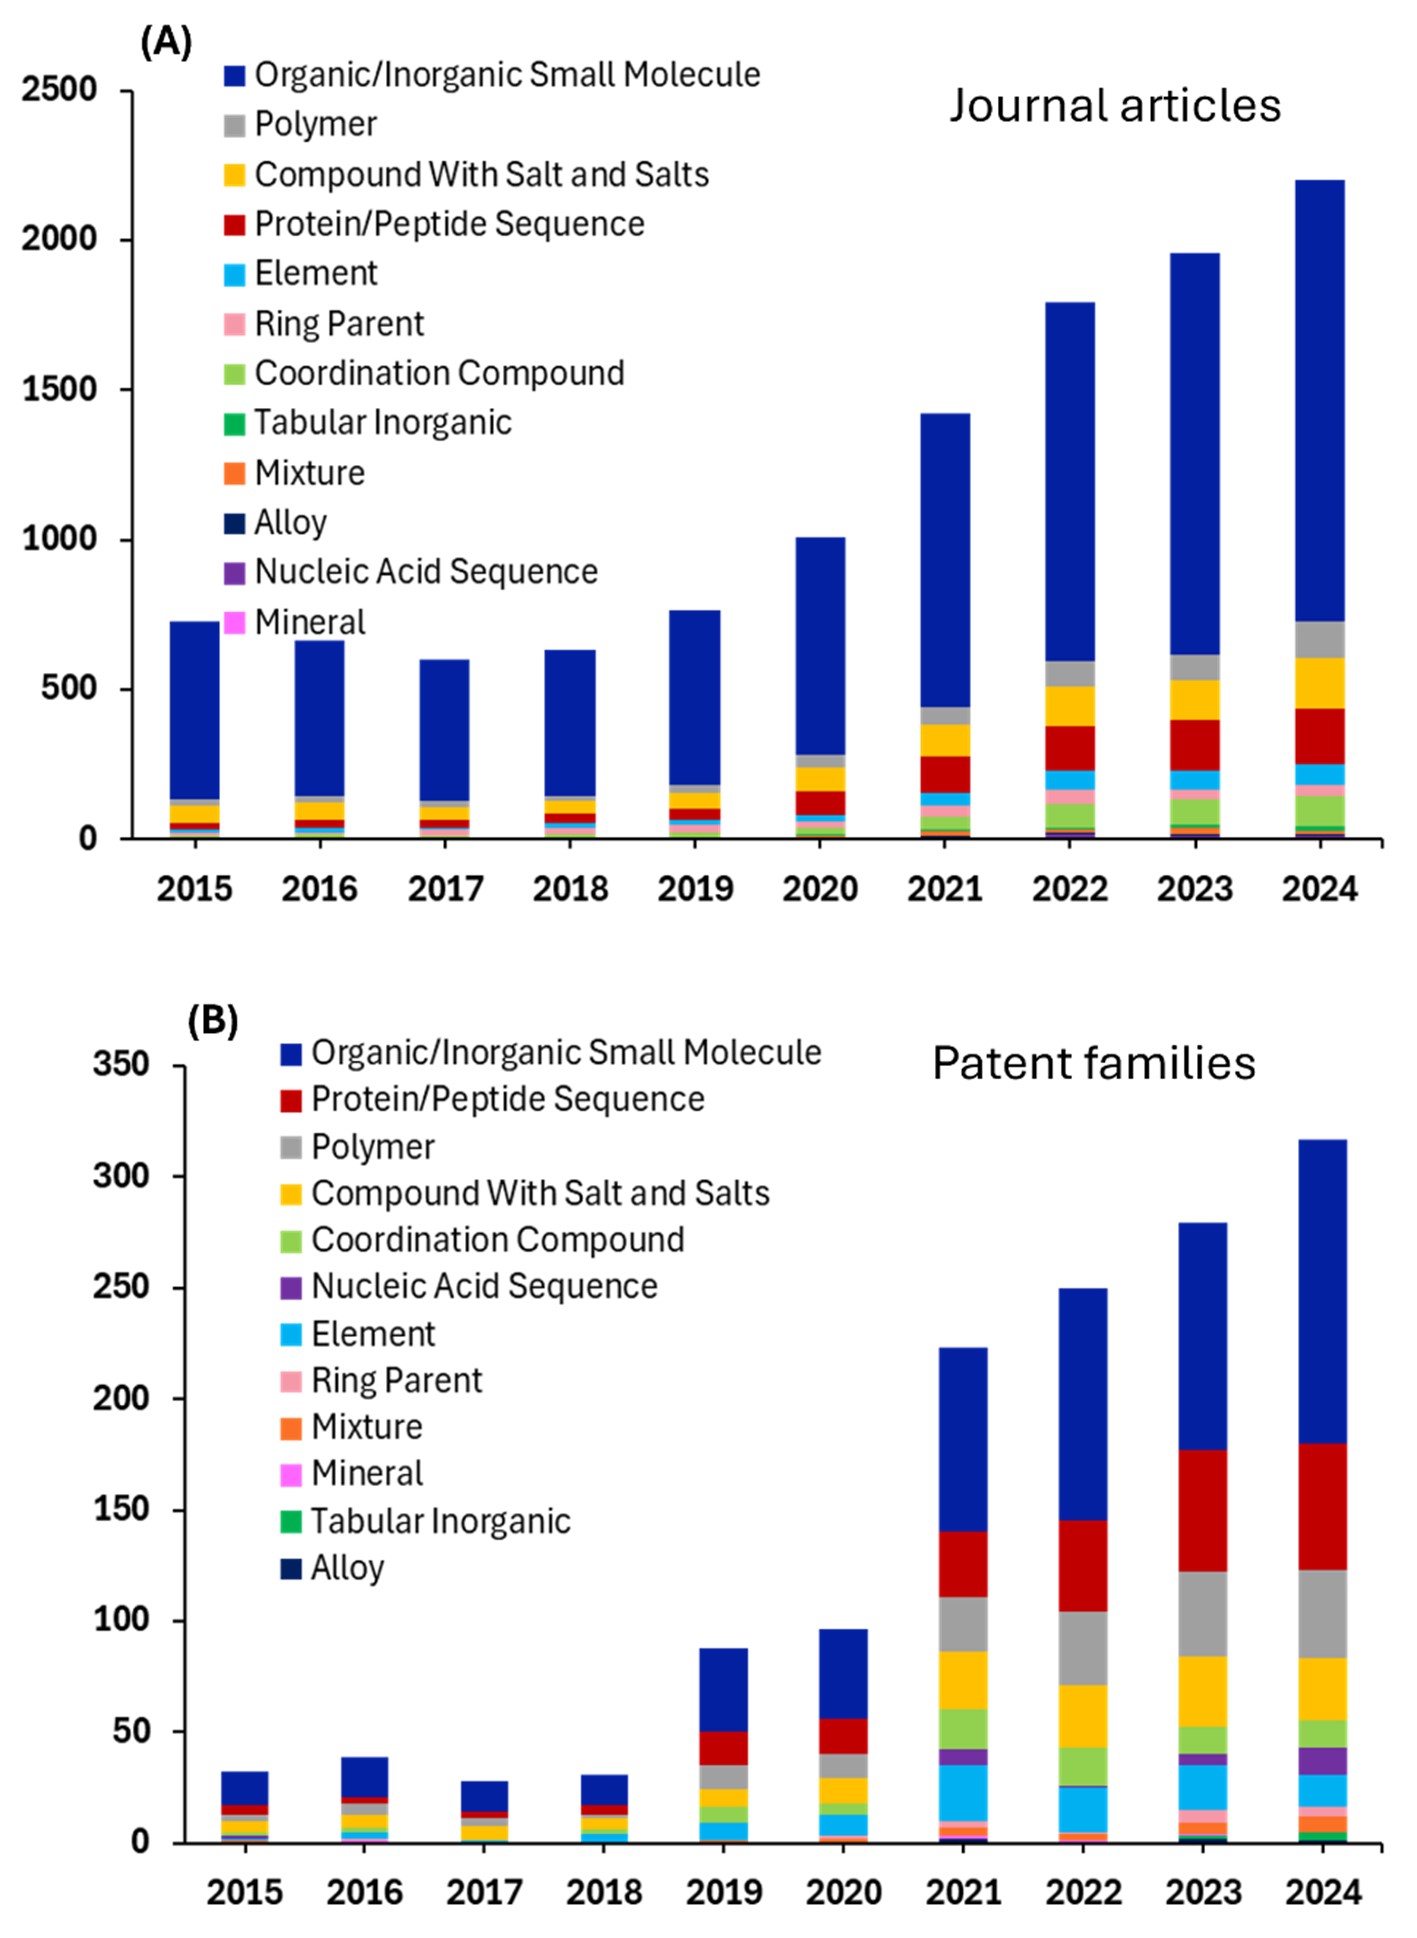
小分子药物在药物研发中持续占据主导地位,人工智能技术正加速其发现进程。基于机器学习的虚拟筛选、用于药代动力学预测的 QSAR 建模以及优化合成路径的深度学习系统,现已成为该流程不可或缺的一部分。这些创新建立在小分子固有的优势之上,包括成熟的合成路线、特征明确的药代动力学、良好的口服生物利用度以及具有成本效益的制造工艺。
蛋白质/多肽类药物是研究第二多的类别。AlphaFold 等工具彻底改变了蛋白质结构预测,使得胰岛素(用于糖尿病)、组织纤溶酶原激活剂(用于中风)以及单克隆抗体(用于癌症和自身免疫性疾病)等治疗性蛋白质的设计与优化成为可能。机器学习模型通过预测蛋白质间的相互作用并优化多肽稳定性,进一步提升了该领域的研究水平。
盐类化合物受益于人工智能驱动的制剂优化算法,这些算法能够预测溶解度、生物利用度和稳定性,反映了药物制剂和生物利用度优化的重要性。聚合物作为关键的治疗递送系统,正通过人工智能设计的纳米颗粒制剂、机器学习优化的水凝胶性能以及用于靶向药物递送的预测建模得到增强,从而提高了治疗效果和组织特异性。
配位化合物是另一个极具前景的类别,人工智能在此类研究中辅助配体设计和金属有机框架(MOF)的优化。通过计算化学和预测金属-配体相互作用及生物活性的人工智能模型,这些化合物正得到进一步完善。
人工智能模型在材料科学中的应用
概述
在材料科学领域,理解并预测材料组成、结构特征与性能之间复杂的相互关系,对于加速材料发现至关重要。相关数据通常具有多维、分层、异构的特点,且通过高通量、数据密集型流程生成。人工智能,特别是机器学习,通过实现对这些复杂数据集的分析,正在彻底改变该领域。我们分析了 CAS 内容合集,以识别应用人工智能方法的关键材料科学概念,并评估了它们在材料发现和性能预测中的重要性(见图 8)。

储能是应用领域中人工智能应用最密集的科研方向,反映了全球对先进电池技术和可持续能源解决方案的需求。机器学习技术已成为强有力的工具,助力电池材料创新。研究人员主要采用三种策略:直接性能预测、机器学习势函数和逆向设计。该领域人工智能研究的高度集中,源于电池系统复杂的多尺度特性,传统的实验方法往往难以优化材料组成、结构与电化学性能之间错综复杂的关系。
在材料和器件类别中,陶瓷、压电陶瓷、传感器和场效应晶体管领域显著的人工智能活动,反映了这些材料及其器件的复杂性。这些先进材料通常表现出复杂的结构-性能关系,是机器学习方法的理想应用对象。
在结构特征方面,我们发现卷积神经网络(CNN)与计算机视觉技术被用于微观结构分析,实现了显微图像的自动分类、分割和特征提取。这些工具正在帮助揭示以往难以量化的结构-性能关系。在冶金领域,针对性的人工智能方法正在推动高温合金的开发,而诸如 CAMEO(闭环自主材料探索与优化)之类的系统,通过将人工智能与高通量实验相结合,实现了组合冶金。此外,用于三维断层扫描数据的机器学习工具正在增强对多孔材料的分析,从而能够更精确地模拟渗透率和机械强度等性能。
介电常数和电导率是性能领域的主要概念,而压电性在现象领域处于领先地位。在模拟与建模方面,计算建模显示出较高的人工智能采用率,这与机器学习在数据分析任务中的天然契合度相一致。
图 7 中以紫色和混合色区域表示的中等人工智能活动领域,是人工智能应用正在加速但仍有提升空间的领域。例如,某些材料领域表现出的低活跃度(主要以蓝色显示)代表了科学界最成熟、最基础的领域,从而形成了一种悖论:最成熟的领域反而显示出最低的人工智能整合度。复合材料和聚合物就是此类别的典型代表。
然而,专门的人工智能模型正在被开发以解决特定挑战。polyBERT 模型将聚合物结构视为一种化学语言,从而能够更有效地对复杂的聚合物系统进行建模。对于晶体材料,MEGNet、CGCNN 和 SchNet 等模型结合了晶体对称性和量子相互作用,而 ALIGNN 则捕捉到了对精确预测合金性能至关重要的高阶原子相互作用。
人工智能模型与材料科学概念的共现
正如我们在生物医学分析中所做的那样,我们深入研究了材料科学中的人工智能方法及其相关概念。我们发现,随机森林(RF)、支持向量机(SVM)、梯度提升机(GBM)和决策树(DT)等传统机器学习模型被广泛用于预测和特征重要性分析,这主要是因为材料信息学中常见的高维数据具有非线性关系(见图 9)。


RF 模型被广泛使用并分布在所有概念领域。与 GBM 模型一样,它们在处理复杂、异质材料方面表现出很强的共现性,这归功于它们能够对非线性关系进行建模并处理混合数据类型。它们常用于异质复合材料、机械性能预测以及通过捕捉基体与增强体之间复杂相互作用进行的失效分析。
我们观察到这些方法与合金领域存在共现,其中 RF 被用于映射合金成分中的非线性关系,助力高熵合金设计、沉淀强化预测和热处理优化。GB 则越来越多地应用于精确的性能调控,例如优化屈服强度或耐腐蚀性。
SVM 更多地用于具有明确结构-性能关系的材料。此类模型对于使用固定维度的特征向量对合金类型和阈值进行分类非常有效。温度相关属性通常也遵循非线性模式,并取决于成分、加工历史和环境条件,而基于树的方法和 SVM 可以有效地捕捉这些特征。
对于微观结构等结构特征,集成模型被用于从复杂图像中识别特征;对晶界、相和缺陷进行分类;以及预测晶体结构(通常被视为需要对称性感知模型的分类问题)。表面属性涵盖从原子到宏观尺度,涉及表面能和反应性的复杂模式。这些应用需要对图像数据进行预处理、提取多尺度特征,并对对称性和周期性进行编码,特别是在催化、腐蚀和粘附研究中,通常需要与分子建模相结合。
应用领域已大幅扩展,其中电池研究呈现出显著增长。图 9A 和 9B 证实了 RF 与电化学过程之间的强相关性,它能够处理电池容量预测、电极材料选择和时间相关过程中的复杂相互作用。
2020-2024 年期间能源相关应用(储能、发电)的出现,证明了该领域的多元化。长短期记忆网络(LSTM)能够捕捉对电池退化预测和循环性能预测至关重要的时间动态。另一个新兴的相关领域是强化学习(RL),它能够优化充电协议和材料使用,并可用于电池管理系统。卡尔曼滤波也常见于电池和二次电池领域,用于跟踪加工过程中的材料状态,并预测电池的健康状态和剩余使用寿命。
Transformer 模型被用于从科学文献中提取合成程序和材料属性,并捕捉复杂材料描述中的长程依赖关系。卷积神经网络(CNN)和生成对抗网络(GAN)实现了 2D/3D 结构特征提取的自动化,并支持性能预测和模式识别。尽管它们功能强大,但需要更多的数据和计算资源,且可解释性较低,因此它们是对传统模型的补充而非替代。神经网络越来越多地用于基于图像的分析和生成式设计,而传统方法在数据集有限的情况下,在成分-性能映射方面仍保持优势。这也是神经网络与传统模型结合使用的原因之一。另一个发展方向是结合了对称性和物理约束的材料专用 CNN 架构,而图神经网络(GNN)在原子和分子结构领域也正受到越来越多的关注。
材料科学中的物质
回到 CAS 索引的物质类别,我们分析了材料科学中与这些物质相关的出版物数量(见图 10)。

有机/无机小分子在人工智能驱动的研究中占据主导地位,这反映了该领域在处理小结构时,相对于聚合物等大型复杂系统,在计算成本和数据丰富度方面具有优势。该类别拥有约 6,500 篇期刊文章,得益于数十年来积累的化学数据库。
小分子特别适合机器学习方法,因为它们的属性可以通过分子描述符、指纹和基于图的表示进行有效编码。该领域的研究规模巨大,也表明制药和化学工业在药物发现、催化剂设计和分子属性预测方面对人工智能进行了大量投入。
元素以约 5,500 篇文章位居第二,同样得益于广泛的数据库和相对简单的结构,使其成为人工智能驱动的性能预测和材料发现的理想对象。
表格化无机材料拥有约 4,500 篇期刊文章,是人工智能获得实质性应用的另一个领域。这些材料(包括陶瓷、氧化物和其他结构化无机化合物)得益于晶体学数据库和系统性的性能测量,为有效的机器学习提供了所需的大规模数据集。这些材料的结构化特性允许基于晶体结构、成分和键合特征进行一致的特征工程。该类别在人工智能研究中的突出地位,反映了材料科学界致力于为储能、催化以及电子和磁性应用发现新型功能材料的重点。
聚合物研究显示人工智能的应用处于中等水平,约有 1,800 篇期刊文章,考虑到聚合物的工业重要性,这一数字似乎偏低。这可能反映了聚合物为人工智能应用带来的独特挑战,包括其复杂的链结构、分子量分布和加工依赖性属性。然而,研究数量的增长表明,在将人工智能应用于聚合物性能预测、合成和加工优化方面,正取得越来越多的成功。
我们分析的另一个重要发现是,在所有材料科学类别中,专利族仅占期刊文章的一小部分。期刊与专利数量之间的差异表明,材料科学中的大部分人工智能研究仍处于基础或探索阶段,学术发现与商业阶段值得申请专利的实际应用之间存在显著的时间滞后。
专利数量相对较少也可能反映了将人工智能驱动的材料发现转化为商业可行技术的挑战,因为该领域中的许多人工智能应用侧重于性能预测和基础理解,而非可立即申请专利的发明。不同材料类型之间的一致比例表明,从学术到商业的转化挑战在整个材料科学领域是普遍存在的,而非特定于某种材料类别。
人工智能在流程管理中的应用
人工智能正在通过实现更智能、更快速、更具适应性的决策来变革流程管理。分析人工智能在这一领域的作用,揭示了自动化、预测性分析和实时优化如何推动各行业的卓越运营(见图 11)。

人工智能驱动的优化技术被广泛应用于增材制造、石油化工、塑料加工、冶金、流动化学、催化工艺以及药物发现与合成等领域。常用的模型包括响应面法(RSM)、实验设计,以及人工神经网络(ANN)、混合模型、物理信息神经网络(PINN)、大语言模型(LLM)和强化学习等机器学习技术。让我们探讨其他几种将预测建模扩展到实时决策和自动化的技术:
- 实时监控:这些系统利用机器学习分析流式数据,以检测模式、趋势和早期预警信号,从而促进动态预测和主动决策。关键创新包括:基于实时输入自动调整参数的自主决策;在故障发生前进行预判的预测性维护;以及能够适应不断变化条件的自改进模型。此外,实时数据可视化和智能警报系统正在改变操作员与实时流程数据的交互方式。这些进展正应用于自动化色谱系统和制药生产中的药物反应监测等行业。我们还看到它们被用于聚合物生产中的性能优化、废物管理中的固体废物分析、环境监测、大规模氢能生产中的能源与资源管理,以及针对老化基础设施的云端能源管理。
- 软传感器:利用来自物理传感器的实时数据,结合人工智能和统计模型,对难以或无法直接测量的变量进行估算。它们被广泛应用于生物过程监测、废水和空气质量监测等行业。在化学过程控制中,软传感器被用于监测复杂的硫化矿浮选、异构化、反应精馏和汽油调合。
- 数字孪生:这些创新是物理系统的虚拟复制品,正随着人工智能的集成而迅速演进,以实现实时优化、预测性分析和自主运营。人工智能通过学习历史和实时数据来模拟未来状态、检测异常并预测故障,从而增强了数字孪生,使其从静态模型转变为具有韧性的自优化系统。在制造业中,人工智能驱动的数字孪生利用传感器和图像来预测设备故障、优化生产流程并检测质量问题。在医疗保健领域,它们用于模拟患者状况、支持个性化医疗、疾病建模、临床试验模拟以及优化免疫疗法。在环境和可持续发展领域,人工智能驱动的数字孪生被应用于地质碳封存、矿石废物处理和资源管理。它们还支持材料科学,实现自动化发现、缺陷分析和逆向分子设计。
人工智能在科学研究应用中面临的挑战
人工智能显然已为所有科学研究领域做出了许多积极贡献,并且随着技术的进步,这种贡献将持续下去。然而,这些创新并非没有挑战,研究人员和数据科学家必须解决这些问题,以确保人工智能在科学领域充分发挥其潜力。一些最紧迫的挑战包括:
- 数据隐私与安全:确保数据隐私和安全是实施人工智能面临的最大挑战之一,因为其训练和运行需要大量敏感数据。当敏感信息在未经适当许可的情况下被收集和使用,或者从人工智能系统中泄露或被窃取时,问题就会出现。科学数据集可能包含未发表的实验结果、新型化合物结构和具有重大竞争优势的专有合成方法。当研究人员使用基于云的人工智能平台或参与协作研究环境时,他们面临着知识产权暴露的巨大风险。为了应对这一风险,一些企业正在实施保障措施以保护客户信息并维护信任,同时一些初创公司正在寻找市场利基,以防范外部人工智能威胁。
- 数据质量与偏差:数据集经常存在系统性偏差,这些偏差可能会通过人工智能模型传播,导致预测结果出现偏差,并可能加剧现有的研究不平等。已发表反应数据中的历史偏差(即成功反应被过度呈现,而失败实验未被充分报告)会严重削弱机器学习模型探索新型化学空间的能力,特别是对于无机材料而言。这种“发表偏差”形成了一种自我强化的循环,使人工智能系统倾向于推荐与已深入研究的化合物相似的物质。生成式人工智能模型带来了额外的担忧,因为它们可能会操纵现有数据并产生“幻觉”,以牺牲真实证据为代价来满足客户需求。
- 透明度:这些模型的“黑箱”性质可能会掩盖其预测背后的逻辑,使研究人员难以评估其可靠性或识别潜在的失效模式。一项关于药物发现中可解释人工智能方法的综述强调,复杂模型缺乏可解释性会削弱药物化学家之间的信任,并阻碍监管机构对人工智能引导决策的认可。对于处理高维化学表示的图神经网络和 Transformer 模型而言,这一挑战尤为严峻,因为输入特征与预测之间的关系变得高度非线性。
- 平衡自动化与人类专业知识:虽然人工智能系统可以处理海量数据集并识别超出人类认知能力的模式,但它们缺乏经验丰富的科学家在研究问题时所具备的直觉、创造力和背景理解能力。这可能导致一代缺乏基础研究技能和概念理解的科学家。反之,当人工智能得出的结论与直觉相悖时,也可能导致“算法厌恶”。
人工智能模型与科学研究的未来
人工智能在科学探索中的重要性只会与日俱增,其革命性的能力已在生物医学和材料科学等领域得到体现。正如我们对 CAS 内容合集的分析所显示的那样,新的应用、模型和方法正不断被应用于解决棘手的科研问题。我们可以预见,药物发现、疾病诊断、材料开发等领域的突破将受到人工智能驱动技术的深刻影响,甚至完全由其主导。
随着人工智能从工具转变为科学协作伙伴,我们很可能会看到逆向设计和自动驾驶实验室等新范式,将科学方法论重新定义为自主发现引擎。然而,较低的专利与出版物比例表明,大量研究仍停留在学术界,特别是在传统材料科学领域。
人工智能的进一步普及需要通过不确定性量化和模型透明度等技术解决方案进行适当的信任校准。人工智能对科学影响的广泛性及其在实施过程中面临的挑战规模,意味着协作和透明度将是最大化其科学进步效益的关键。
欲了解更多信息,请阅读我们的重印期刊文章,“化学领域的人工智能革命:塑造材料与生物医学科学的未来。”
本文中使用的品牌名称和/或提及的任何第三方产品或服务仅用于教育目的,并不暗示 CAS 或美国化学会对此表示认可,也不代表对未提及的类似品牌、产品或服务的歧视


