

Resumen ejecutivo
En el panorama de la investigación científica moderna, la inteligencia artificial (IA) ha surgido como una fuerza transformadora que altera fundamentalmente la forma en que los investigadores conceptualizan, llevan a cabo y validan su trabajo. La convergencia de la potencia computacional, los algoritmos avanzados y los vastos conjuntos de datos ha convertido a la IA de una posibilidad teórica en una necesidad práctica en todas las disciplinas científicas.
Esta revolución aborda varios desafíos persistentes que han limitado el progreso científico: el volumen abrumador de datos generados en campos como la genómica, la medicina y la ciencia de materiales; el elevado tiempo y coste de procesos como el descubrimiento de fármacos; y las limitaciones cognitivas en la generación de hipótesis. La IA ofrece vías nuevas y prometedoras para superar estos retos y lograr avances más rápidos en numerosas disciplinas científicas.
Por ejemplo, en las ciencias biomédicas, la IA ha revolucionado la predicción de la estructura de las proteínas, ha acelerado el proceso de descubrimiento de fármacos y ha hecho posible la medicina personalizada. Del mismo modo, en la ciencia de materiales, la IA está acelerando el descubrimiento de nuevos materiales. Estos avances han allanado el camino para los laboratorios autónomos y los marcos de diseño inverso, que están cambiando el método científico en sí. La IA también ha mejorado significativamente la optimización de procesos al permitir ajustes experimentales en tiempo real para mejorar el rendimiento y la eficiencia, reduciendo al mismo tiempo los residuos y los costes.
Hemos realizado un análisis cuantitativo de la CAS Content CollectionTM, el mayor repositorio de información científica curado por expertos, para comprender la implementación y el impacto de estos avances tecnológicos en el descubrimiento científico. Analizamos sistemáticamente más de 310.000 artículos de revistas y patentes de la CAS Content Collection entre 2015 y 2025, empleando técnicas analíticas avanzadas para identificar las publicaciones relacionadas con la IA y sus metodologías, instituciones y dominios de investigación asociados.
Nuestro estudio explora la distribución de los métodos de IA en los campos científicos con análisis detallados de dos dominios críticos: las ciencias biomédicas y la ciencia de materiales. Estos análisis detallan los conceptos dominantes, los patrones de coocurrencia de los métodos de IA y las clases de sustancias notables. Además, investigamos el papel de la IA en la optimización de procesos industriales y aplicaciones emergentes.
Estos hallazgos proporcionan información esencial sobre el estado actual y la trayectoria de la integración de la IA en la investigación científica, ofreciendo una orientación valiosa para que investigadores, instituciones y responsables políticos comprendan los patrones de adopción tecnológica, identifiquen oportunidades de colaboración y tomen decisiones estratégicas informadas sobre futuras inversiones en IA y direcciones de investigación.
El panorama de los modelos de IA en la ciencia
Para comprender el contexto en el que se seleccionan determinados modelos y su impacto, llevamos a cabo un análisis exhaustivo de publicaciones científicas, incluidas revistas y familias de patentes, que han incorporado métodos basados en IA. La visualización de todo el panorama destaca la creciente integración de estas tecnologías en todas las disciplinas científicas a medida que se desarrollan más modelos y funcionalidades (véase la Figura 1).

Las ramas principales de esta visualización incluyen:
Modelos de clasificación, regresión y agrupación
Los modelos de clasificación están diseñados para predecir etiquetas o categorías discretas y son especialmente eficaces en el manejo de datos de alta dimensión y en la obtención de resultados interpretables. Los modelos comunes incluyen los árboles de decisión (DT), un modelo que clasifica los resultados dividiendo recursivamente los datos en ramas. El bosque aleatorio (RF) es un conjunto de árboles de decisión que reduce el sobreajuste promediando las predicciones. Otro modelo común, la máquina de vectores de soporte (SVM), encuentra el límite óptimo entre clases, mientras que los K-vecinos más cercanos (KNN) clasifican la clase mayoritaria de los vecinos más cercanos.
Estos modelos se aplican ampliamente a conjuntos de datos etiquetados (aprendizaje supervisado) con resultados categóricos, como datos de espectroscopia, microscopía u ómicas con clases conocidas. Entre las aplicaciones de ejemplo se incluyen la clasificación de tipos de enfermedades a partir de la expresión génica o datos de imagen, la predicción de clases de materiales y la clasificación de compuestos según su toxicidad o reactividad.
Los modelos de regresión predicen valores numéricos continuos, lo que los hace ideales para la previsión y la optimización. Algunos de los modelos de regresión observados en las publicaciones son la regresión lineal, la regresión logística, la regresión de vectores de soporte (SVR) y la regresión simbólica. Estos modelos son adecuados para datos numéricos procedentes de experimentos, simulaciones o datos de series temporales de sensores o instrumentos. Sus aplicaciones incluyen la predicción de niveles de energía, tasas de desintegración o trayectorias de partículas, la estimación de rendimientos de reacción, propiedades moleculares, el modelado de temperatura, precipitaciones, la predicción de conductividad, dureza y bandas prohibidas.
A diferencia de la clasificación y la regresión, los modelos de agrupación (clustering) descubren agrupaciones naturales en datos no etiquetados, revelando estructuras ocultas y apoyando el análisis exploratorio (aprendizaje no supervisado). Estos modelos son eficaces para conjuntos de datos no etiquetados de alta dimensión, como datos de imagen, espectrales y moleculares. Los datos científicos adecuados para este grupo incluyen, entre otros, la agrupación de genes o muestras según perfiles de expresión y el descubrimiento de nuevas familias de materiales a partir de datos estructurales.
Redes neuronales artificiales (RNA)
Las RNA son una clase de modelos de aprendizaje automático (ML) diseñados para aprender patrones complejos a través de capas interconectadas de neuronas artificiales. Son potentes para modelar relaciones intrincadas y no lineales en los datos. Como resultado, constituyen la base del aprendizaje profundo y son el fundamento de la IA moderna, con arquitecturas especializadas como las redes neuronales recurrentes (RNN) para datos secuenciales, la memoria a largo y corto plazo (LSTM), una RNN mejorada que captura mejor las dependencias a largo plazo, y las unidades recurrentes cerradas (GRU), que son una versión simplificada de las LSTM con menos parámetros.
Estos modelos son adecuados para datos de secuencias y series temporales, como la expresión génica, secuencias de proteínas, señales fisiológicas, datos climáticos, física de partículas y datos de redes de sensores. A menudo mejoran la alineación imagen-texto aprovechando mapas de conocimiento —representaciones estructuradas de conceptos específicos de un dominio y sus relaciones—, lo que ayuda a cerrar la brecha semántica entre los datos visuales (como imágenes médicas) y las descripciones textuales (como notas clínicas o informes de diagnóstico). Su adopción ha aumentado en áreas como el descubrimiento y desarrollo de fármacos, la medicina de precisión, la imagenología médica, el descubrimiento y diseño de materiales, el almacenamiento de energía, la fabricación y el control de calidad.
Métodos hibridados
La comparación entre las RNA y los modelos de ML convencionales, como los de clasificación, regresión y agrupación, no trata simplemente de cuál es mejor, sino de comprender sus funciones complementarias. Las RNA predominan cuando los datos son complejos y no estructurados, cuando existen grandes conjuntos de datos de entrenamiento y cuando se requiere el aprendizaje de representaciones. Por el contrario, el ML convencional sigue siendo sólido cuando los datos son escasos, los problemas de investigación requieren una interpretabilidad estricta y las entradas poseen relaciones estadísticas bien comprendidas y requieren una cuantificación de la incertidumbre.
Modelos específicos de dominio
Aunque los modelos específicos de dominio cuentan con menos publicaciones, incluyen trabajos innovadores como AlphaFold, un enfoque de aprendizaje profundo que logró una precisión casi experimental en la predicción de estructuras proteicas. ESMFold es otro modelo interesante que aprovecha directamente el modelado del lenguaje de proteínas para generar predicciones de estructuras de alta calidad directamente a partir de secuencias de proteínas individuales.
Procesamiento del lenguaje natural (PLN)
El PLN se utiliza para analizar, comprender, interpretar y generar lenguaje humano. Implica tareas como la tokenización (descomponer el texto en unidades más pequeñas llamadas tokens, normalmente palabras o subpalabras) que pueden ser procesadas por algoritmos. Un método común para representar texto es el modelo de bolsa de palabras (BoW), que convierte el texto en vectores numéricos basados en la frecuencia de las palabras, ignorando la gramática y el orden de las mismas. Otra técnica clave es el reconocimiento de entidades nombradas (NER), que identifica y clasifica entidades como nombres de personas, organizaciones y ubicaciones dentro del texto.
Existen amplias aplicaciones de los modelos de PLN en la minería de textos biomédicos y la extracción de conocimiento, que van desde modelos lingüísticos especializados preentrenados en literatura biomédica (es decir, BioBERT, BioGPT) y el análisis de registros médicos electrónicos (EHR) hasta la extracción automatizada de características de enfermedades a partir de registros clínicos y la creación de nuevos candidatos a fármacos mediante modelos lingüísticos. En ciencia de materiales y química, el PLN se ha utilizado para la extracción de protocolos de síntesis, la predicción de propiedades de materiales, la construcción de bases de conocimiento y el diseño inverso.
Modelos de lenguaje de gran tamaño (LLM)
Esta clase transformadora de sistemas de IA ha revolucionado el PLN y ha encontrado amplias aplicaciones en todos los dominios científicos. Los LLM son sistemas basados en redes neuronales que se entrenan con grandes cantidades de datos de texto para aprender patrones estadísticos del lenguaje. Se utilizan en la extracción de información, el resumen, la construcción de grafos de conocimiento, la integración entre dominios y aplicaciones generativas.
Los LLM ampliamente adoptados incluyen el Generative Pre-Trained Transformer (GPT), que impulsa ChatGPT, GPT-3.5 y GPT-4. Bidirectional Encoder Representations from Transformers (BERT) sigue siendo un modelo lingüístico de primer nivel, manteniendo un fuerte interés académico debido a su comprensión bidireccional del contexto y su rendimiento superior en la respuesta a preguntas y el análisis de sentimientos.
BLOOM, un modelo multilingüe, se ha convertido en un contribuyente significativo al panorama de la investigación. Nuevos modelos como GEMINI, desarrollado por Google DeepMind, y LLAMA, de Meta AI, también se están volviendo populares, al igual que Claude, desarrollado por Anthropic. La última generación de modelos, Gemma, Falcon, Mistral, Qwen y DeepSeek, lanzados entre 2023 y 2025, muestran un gran potencial para futuros desarrollos.
Varios LLM especializados para química, ciencias de la vida y ciencia de materiales también están teniendo un impacto, como chemLLM, PharmaGPT y MatSciBERT.
Las tendencias de publicación muestran el impacto de la IA en la ciencia
Como se ha señalado, analizamos 310.000 documentos de la CAS Content Collection relacionados con la IA en la investigación científica durante el periodo 2015-2025. Observamos un crecimiento constante durante todo el periodo, con un crecimiento destacado en los últimos cinco años (véase la Figura 2). El creciente número de familias de patentes sugiere además que la IA está evolucionando de una tecnología emergente a una herramienta de investigación esencial en diversas industrias.

- Distribución por país/región y organización: China lidera el volumen de publicaciones (revistas y patentes), mientras que EE. UU., India, Corea del Sur y Japón también muestran un crecimiento constante en sus publicaciones (véase la Figura 3). En conjunto, los datos subrayan el surgimiento de Asia como el nuevo epicentro de la innovación científica global en IA, dejando a los países occidentales rezagados en términos de producción cuantitativa.

- Distribución en familias de patentes: Analizamos además las tendencias de publicación en revistas y patentes de los cinco principales países. China e India contribuyen conjuntamente a más del 75 % de las patentes globales en este campo; las 15 instituciones principales en cuanto a solicitudes de patentes provienen de China e India. Las universidades chinas dominan en volumen de publicaciones en revistas, con un recuento medio de citas para la mayoría de ellas que oscila entre 10 y 20. Por el contrario, el MIT y Stanford cuentan con recuentos medios de citas significativamente superiores, de 32 y 66, respectivamente. Esto sugiere que, aunque China destaca en cantidad, las universidades estadounidenses lideran en cuanto a la calidad e impacto de sus artículos de revista en el campo de la IA.
- Distribución en publicaciones específicas: Analizamos el volumen de publicaciones y el impacto de las citas de las principales revistas científicas que publican investigaciones basadas en IA. El volumen de publicaciones está dominado por Scientific Reports, Applied Sciences y PLoS One. Sin embargo, al considerar el recuento medio de citas por artículo, Proceedings of the National Academy of Sciences (PNAS) destaca, demostrando una influencia excepcional con casi 50 citas por publicación, a pesar de tener un volumen de publicaciones relativamente modesto. Otras revistas como el Journal of Chemical Information and Modelling (JCIM), Bioinformatics y Nature Communications también muestran un promedio de citas notable, superando significativamente a las revistas con un gran volumen. Este patrón sugiere que, si bien las revistas de amplio espectro como Scientific Reports publican la mayor parte de la investigación relacionada con la IA, las revistas especializadas o prestigiosas como PNAS, JCIM y Nature Communications publican trabajos más influyentes que generan un mayor impacto científico.
- Tendencias por campo científico: Numerosos campos se han visto enormemente afectados por la IA, pero varios destacan por un crecimiento exponencial en sus publicaciones (véase la Figura 4):

Entre todas las disciplinas, la Química Industrial e Ingeniería Química demuestra el crecimiento más espectacular en publicaciones de revistas, con una trayectoria que alcanza aproximadamente el 8 % del total de documentos para 2024. Este crecimiento excepcional refleja probablemente las amplias aplicaciones del campo en la fabricación, la optimización de procesos y la innovación industrial, así como su papel fundamental en el desarrollo de procesos industriales sostenibles y soluciones de química verde.
La Química Analítica emerge como el segundo campo de más rápido crecimiento en términos de publicaciones en revistas, con la línea azul oscuro mostrando un crecimiento sólido a lo largo del periodo desde 2019 en adelante. Este fuerte patrón de crecimiento muestra la importancia fundamental del campo en todas las áreas de la química y su papel en el desarrollo de nuevas técnicas de medición, instrumentación y métodos analíticos que respaldan la investigación en múltiples disciplinas.
La Tecnología Energética y Química Ambiental demuestra un crecimiento sólido, ocupando conjuntamente el tercer lugar entre los campos de más rápido crecimiento junto con la Bioquímica. Esto refleja el enfoque global urgente en el cambio climático, los desafíos de sostenibilidad ambiental y los eventos emergentes.
Las disciplinas restantes, incluyendo la Química Física, Farmacología, Toxicología y Productos Farmacéuticos, Química Orgánica, Química Inorgánica, Productos Naturales y Polímeros Sintéticos, demuestran aumentos modestos pero constantes en el volumen de publicaciones. Estos campos representan áreas maduras de investigación científica donde los principios fundamentales están bien establecidos, aunque la investigación continua produce avances y refinamientos incrementales.
Los datos de familias de patentes presentan un panorama sorprendentemente diferente en comparación con las publicaciones de revistas, con patrones de innovación muy variados y concentrados en lugar del crecimiento uniforme observado en la producción académica. Este contraste resalta la diferencia fundamental entre la productividad de la investigación académica y la innovación comercialmente viable, donde las fuerzas del mercado, las aplicaciones prácticas y los incentivos económicos desempeñan papeles decisivos a la hora de determinar qué avances científicos se traducen en propiedad intelectual patentable.
Entre las patentes, la Bioquímica muestra un crecimiento casi exponencial, alcanzando aproximadamente el 8 % para 2024 y eclipsando por completo a todas las demás disciplinas. El panorama de las patentes de bioquímica está dominado por métodos biomédicos y moldeado por innovaciones que fusionan la ciencia molecular con tecnologías sanitarias avanzadas. Los dominios clave incluyen la detección de enfermedades, imágenes médicas, monitorización mediante dispositivos vestibles y apoyo a la toma de decisiones clínicas, todo ello aprovechando marcadores bioquímicos. La bioquímica también impulsa el progreso en interfaces neurológicas, genómica, descubrimiento de biomarcadores, procesamiento de señales, guía quirúrgica y fabricación biomédica, destacando su papel central en la innovación biomédica moderna. Esta espectacular actividad de patentes refleja el intenso interés comercial y la inversión en la investigación de las ciencias de la vida en general, impulsada aún más en respuesta a la pandemia de COVID, donde la investigación comercial recibió una financiación significativa.
Basándonos en nuestro análisis, descubrimos que la mayoría de las publicaciones relacionadas con la IA están vinculadas a la investigación biomédica y la ciencia de materiales. Por lo tanto, llevamos a cabo un análisis en profundidad de estas áreas de investigación clave, ya que estos campos dominan el conjunto de datos, exhiben una rápida adopción de la IA con notables tasas de crecimiento anual y generan mayores impactos de citas, lo que indica su relevancia científica.
Aplicaciones de los modelos de IA en la investigación biomédica
Visión general
La investigación biomédica se ha enfrentado a desafíos continuos en cuanto a complejidad y costes que la IA puede abordar ahora. Por ejemplo, descodificar estructuras e interacciones proteicas complejas, los elevados costes y tasas de fracaso asociados al desarrollo de fármacos, y las complejidades de comprender los mecanismos de enfermedades multifactoriales se prestan a enfoques basados en la IA.
Integridad de los datos para la investigación científica impulsada por IA. La capacidad de la IA para procesar datos y su velocidad computacional superan lo que los humanos son capaces de hacer, y la tecnología seguirá redefiniendo lo que es posible. Pero la integridad y la armonización de los datos son componentes críticos de cualquier aplicación exitosa de la IA en la ciencia.
La razón de ser de este análisis fue garantizar un muestreo representativo de las áreas de investigación más significativas utilizando la frecuencia de documentos como métrica objetiva para identificar conceptos clave. Específicamente, identificamos conceptos que han generado un interés científico sustancial e inversión en investigación utilizando varios métodos de IA/aprendizaje automático dentro del campo biomédico (véase la Figura 5).

En el ámbito de la bioquímica, las secuencias y estructuras proteicas, la expresión génica y el ADN/genómica han surgido como los conceptos más estudiados, utilizando diversos enfoques de aprendizaje automático. Los modelos de aprendizaje automático prosperan en estas áreas debido a la abundancia y estandarización de los datos, especialmente en sistemas complejos como las jerarquías proteicas y las redes de regulación génica. El aprendizaje automático destaca en tareas como el mapeo secuencia-función, la clasificación de familias de proteínas, la predicción de dominios, el análisis estructura-función, la selección de características tumorales, la predicción de interacciones génicas en el cáncer y la agrupación de genes por patrones de expresión en oncología, aprovechando datos de expresión de alta dimensión con miles de genes medidos simultáneamente, relaciones no lineales complejas entre genes y fenotipos, y la organización jerárquica de las redes reguladoras genéticas.
Modelos avanzados de aprendizaje automático como AlphaFold y BERT se utilizan para la predicción de la estructura de proteínas, aprendiendo de las secuencias de aminoácidos y los patrones evolutivos para predecir el plegamiento 3D y los dominios funcionales. Estos modelos manejan eficazmente relaciones espaciales complejas y entradas secuenciales con dependencias de largo alcance.
En el ámbito del modelado y diseño de fármacos, el modelado QSAR domina este campo. Utiliza métodos de aprendizaje automático para extraer descriptores moleculares (es decir, propiedades fisicoquímicas, huellas dactilares) de estructuras químicas para predecir actividades biológicas y puntos finales de toxicidad mediante enfoques de aprendizaje supervisado. Estos métodos destacan con descriptores moleculares ricos en características, relaciones estructura-actividad y puntos finales cuantitativos adecuados para tareas de regresión.
El acoplamiento molecular, el segundo concepto más frecuente, utiliza enfoques de aprendizaje profundo (CNN y GNN) en datos estructurales 3D y grafos moleculares para predecir las poses y afinidades de unión proteína-ligando, aprovechando las conformaciones espaciales, los paisajes energéticos y las interacciones moleculares. La farmacocinética es la siguiente área de enfoque, utilizando el aprendizaje automático para aprender de descriptores moleculares, parámetros fisiológicos y datos de series temporales para predecir propiedades ADMET (absorción, distribución, metabolismo, excreción y toxicidad) y tasas de aclaramiento de fármacos.
Los biomarcadores dominan el ámbito del diagnóstico, donde los métodos de aprendizaje automático analizan datos genómicos, proteómicos y metabolómicos de alta dimensión para identificar firmas moleculares discriminatorias que distinguen los estados patológicos de los controles sanos mediante la selección de características y la clasificación. Los métodos de IA también se utilizan en la investigación del pronóstico para analizar los datos clínicos y el historial de tratamiento de los pacientes con el fin de predecir los tiempos de supervivencia y la progresión de la enfermedad mediante técnicas de análisis de supervivencia.
La imagenología médica contiene datos de rayos X, TC, resonancias magnéticas e información espacial estructurada que resulta ideal para los métodos de aprendizaje profundo. Las CNN se utilizan ampliamente para analizar imágenes radiológicas con el fin de detectar tumores, identificar fracturas, clasificar enfermedades y detectar condiciones patológicas mediante el reconocimiento automatizado de patrones. La imagenología también se beneficia de la capacidad del aprendizaje profundo para extraer características multiescala y realizar tareas de segmentación, particularmente en el diagnóstico del cáncer, donde ayuda en la detección de tumores, la clasificación, la evaluación de la malignidad y la predicción de riesgos.
En el ámbito de las enfermedades, la investigación sobre el cáncer recibió la mayor atención, con diversos modelos de aprendizaje automático aplicados según los tipos de datos. Los datos genómicos y transcriptómicos se analizan habitualmente mediante modelos RF y SVM para la clasificación de subtipos de cáncer y la predicción de tratamientos. Estas tareas se benefician de la integración de datos multiómicos, que capturan diversas capas moleculares, y del modelado de la complejidad de los microentornos tumorales heterogéneos.
Se utilizan diversos algoritmos en la investigación de la diabetes para predecir complicaciones diabéticas y optimizar protocolos de tratamiento, aprovechando los datos de seguimiento longitudinal, las interacciones complejas entre factores de estilo de vida y genética, y los problemas de predicción de series temporales para los niveles de glucosa. En la enfermedad de Alzheimer, los modelos RF y SVM se utilizan ampliamente para la predicción temprana mediante el análisis de puntuaciones de pruebas neuropsicológicas, niveles de biomarcadores (amiloide-beta, proteínas tau) y datos demográficos para clasificar a los pacientes en categorías de salud o deterioro cognitivo leve.
En el ámbito de la terapia, los agentes antitumorales recibieron la mayor atención investigadora, empleando métodos de aprendizaje automático para el cribado de fármacos y la predicción de actividad mediante el análisis de descriptores moleculares y propiedades químicas para identificar compuestos con potencial actividad anticancerígena. En quimioterapia, estos métodos predicen las respuestas al tratamiento y la toxicidad analizando los datos clínicos, los perfiles genéticos y las características tumorales de los pacientes para personalizar la selección de fármacos y los protocolos de dosificación. Del mismo modo, estos modelos apoyan la inmunoterapia analizando los perfiles inmunitarios de los pacientes, la carga mutacional tumoral y la expresión de biomarcadores para predecir la respuesta y optimizar los resultados terapéuticos, abordando la complejidad de las interacciones inmunitarias y la dinámica temporal.
Coocurrencias de modelos de IA y conceptos biomédicos
Nuestro análisis explora los patrones de coocurrencia entre conceptos biomédicos y diversos métodos de IA/aprendizaje automático, dilucidando sus aplicaciones estratégicas en los cinco ámbitos (véase la Figura 6).


El bosque aleatorio (RF) ha surgido como el método de IA dominante en la investigación biomédica, mostrando un crecimiento notable y superando a la máquina de vectores de soporte (SVM) entre ambos periodos. El RF muestra una fuerte coocurrencia con conceptos en todos los ámbitos de las ciencias biomédicas, particularmente en bioquímica, diagnóstico e investigación relacionada con enfermedades. El RF se utiliza para la predicción y clasificación de la función proteica mediante el análisis de la composición de aminoácidos, motivos de secuencia y propiedades fisicoquímicas para clasificar las proteínas en familias funcionales. En el descubrimiento de biomarcadores, el RF se utiliza para analizar datos genómicos, proteómicos y metabolómicos de alta dimensión.
La máquina de vectores de soporte (SVM), aunque creció de manera constante entre los periodos, mantiene una presencia significativa en proteínas, expresión génica, ADN y genómica, biomarcadores, pronóstico, imagenología médica e investigación del cáncer. En los estudios de proteínas, la SVM se utiliza para la clasificación y anotación funcional de proteínas mediante el análisis de secuencias de aminoácidos, características estructurales y propiedades fisicoquímicas. También predice la localización subcelular e identifica clases de enzimas utilizando el mapeo de espacios de características de alta dimensión basado en núcleos.
En la expresión génica, la SVM identifica genes implicados en procesos bioquímicos específicos, clasifica rutas metabólicas y predice genes codificadores de enzimas basándose en sus patrones de expresión en diferentes condiciones bioquímicas y estados celulares. Para la clasificación de variantes genómicas, la SVM procesa características y anotaciones de secuencias de ADN para distinguir mutaciones patógenas de benignas e identificar regiones genómicas asociadas a enfermedades mediante el análisis de características de alta dimensión de patrones de nucleótidos y contexto genómico.
En la investigación de biomarcadores, la SVM apoya la identificación, clasificación y validación mediante la integración de múltiples biomarcadores en modelos predictivos para el diagnóstico, la respuesta al tratamiento, la evaluación del riesgo de progresión de la enfermedad y la estratificación de pacientes para enfoques de medicina personalizada. La SVM se utiliza en la investigación del cáncer para distinguir entre tejidos cancerosos y normales, clasificar tipos de cáncer e identificar subtipos moleculares dentro de cánceres específicos. También se utiliza para el pronóstico del cáncer y la predicción del tratamiento mediante la integración de parámetros clínicos, perfiles de biomarcadores y características genómicas para predecir los resultados de supervivencia del paciente, las respuestas al tratamiento, los patrones de resistencia a los fármacos y el riesgo de recurrencia. La Figura 6B revela que la SVM mantuvo su fuerza en el modelado QSAR y SAR, mientras que sus conexiones con el análisis de proteínas se debilitaron en relación con el RF en el periodo posterior.
La regresión logística (LR) es un método estadístico ampliamente utilizado e interpretable en la investigación biomédica, que a menudo coocurre con conceptos clave como proteínas, expresión génica, biomarcadores, pronóstico, imagenología médica, cáncer y COVID-19. En la predicción de la función proteica, la LR analiza la composición de aminoácidos, las características de la secuencia y las propiedades estructurales para clasificar las proteínas en categorías funcionales o estructurales. La ventaja clave del modelo es que proporciona coeficientes interpretables que indican la contribución relativa de cada característica a la decisión de clasificación, lo que permite a los investigadores identificar qué propiedades de los aminoácidos o características estructurales influyen más fuertemente en las predicciones.
Esta interpretabilidad es igualmente valiosa en la clasificación de la expresión génica, donde la LR ayuda a identificar genes expresados diferencialmente. Para la validación de biomarcadores y el diagnóstico, los modelos de LR predicen resultados binarios, como enfermedad/sano o respondedor/no respondedor, y proporcionan razones de momios (odds ratios) clínicamente significativas para la toma de decisiones diagnósticas. En el modelado pronóstico, la LR utiliza una predicción de resultados binarios similar, evaluando parámetros clínicos, perfiles de biomarcadores y datos demográficos de los pacientes para pronosticar resultados como mortalidad/supervivencia, recurrencia/remisión de la enfermedad o pronóstico favorable/desfavorable.
La LR se utiliza en el diagnóstico, la predicción de la gravedad y la mortalidad por COVID-19 mediante la integración de comorbilidades, signos vitales y biomarcadores, apoyando la estratificación del riesgo y la toma de decisiones clínicas. Estas diversas aplicaciones subrayan la fuerte alineación de la LR con los temas centrales de la investigación biomédica, convirtiéndola en una herramienta fundamental para el modelado interpretable y clínicamente relevante. La Figura 6B ilustra la mayor adaptabilidad de la regresión logística, probablemente debido a su capacidad para la clasificación multiclase y las salidas basadas en probabilidades, a diferencia de la regresión lineal, que se limita a predicciones continuas.
Como se observa en la Figura 6B, el periodo 2020-2024 fue testigo de la aparición de enfoques de aprendizaje profundo especializados apenas presentes anteriormente, como AlphaFold. Este periodo también vio un aumento en el uso de redes neuronales de grafos (GNN) para el modelado de interacciones moleculares, redes generativas adversarias de grafos (GAN) para la generación de datos sintéticos y reconocimiento de patrones para aplicaciones de imagenología y desafíos diagnósticos.
Otro cambio importante en los últimos años es la integración de técnicas de PNL en la investigación biomédica, lo cual se pone de manifiesto con el auge de modelos como BERT para la minería de informes clínicos y el análisis de textos biomédicos. Esta especialización refleja la maduración del campo, que ha pasado de aplicar métodos de IA genéricos a desarrollar enfoques adaptados a retos biomédicos específicos.
Las prioridades de investigación cambiaron sustancialmente entre ambos periodos. El análisis de secuencias y estructuras proteicas y el análisis de la expresión génica crecieron significativamente entre 2020 y 2024 (Figura 6B). El descubrimiento de biomarcadores y las aplicaciones de imagen también experimentaron un crecimiento espectacular, mientras que la investigación sobre enfermedades específicas se expandió considerablemente, con la COVID-19 emergiendo como un foco principal y la investigación sobre el cáncer diversificándose en múltiples subtipos.
Sustancias en la investigación biomédica
Esta comparación proporciona una visión estratégica de las oportunidades terapéuticas poco exploradas y destaca las clases de sustancias que podrían beneficiarse de una mayor inversión en investigación o de enfoques innovadores para salvar la distancia entre el descubrimiento científico y la aplicación clínica (véase la Figura 7). Tenga en cuenta que «clases de sustancias» se refiere a categorías de sustancias indexadas por CAS con potencial terapéutico reconocido.
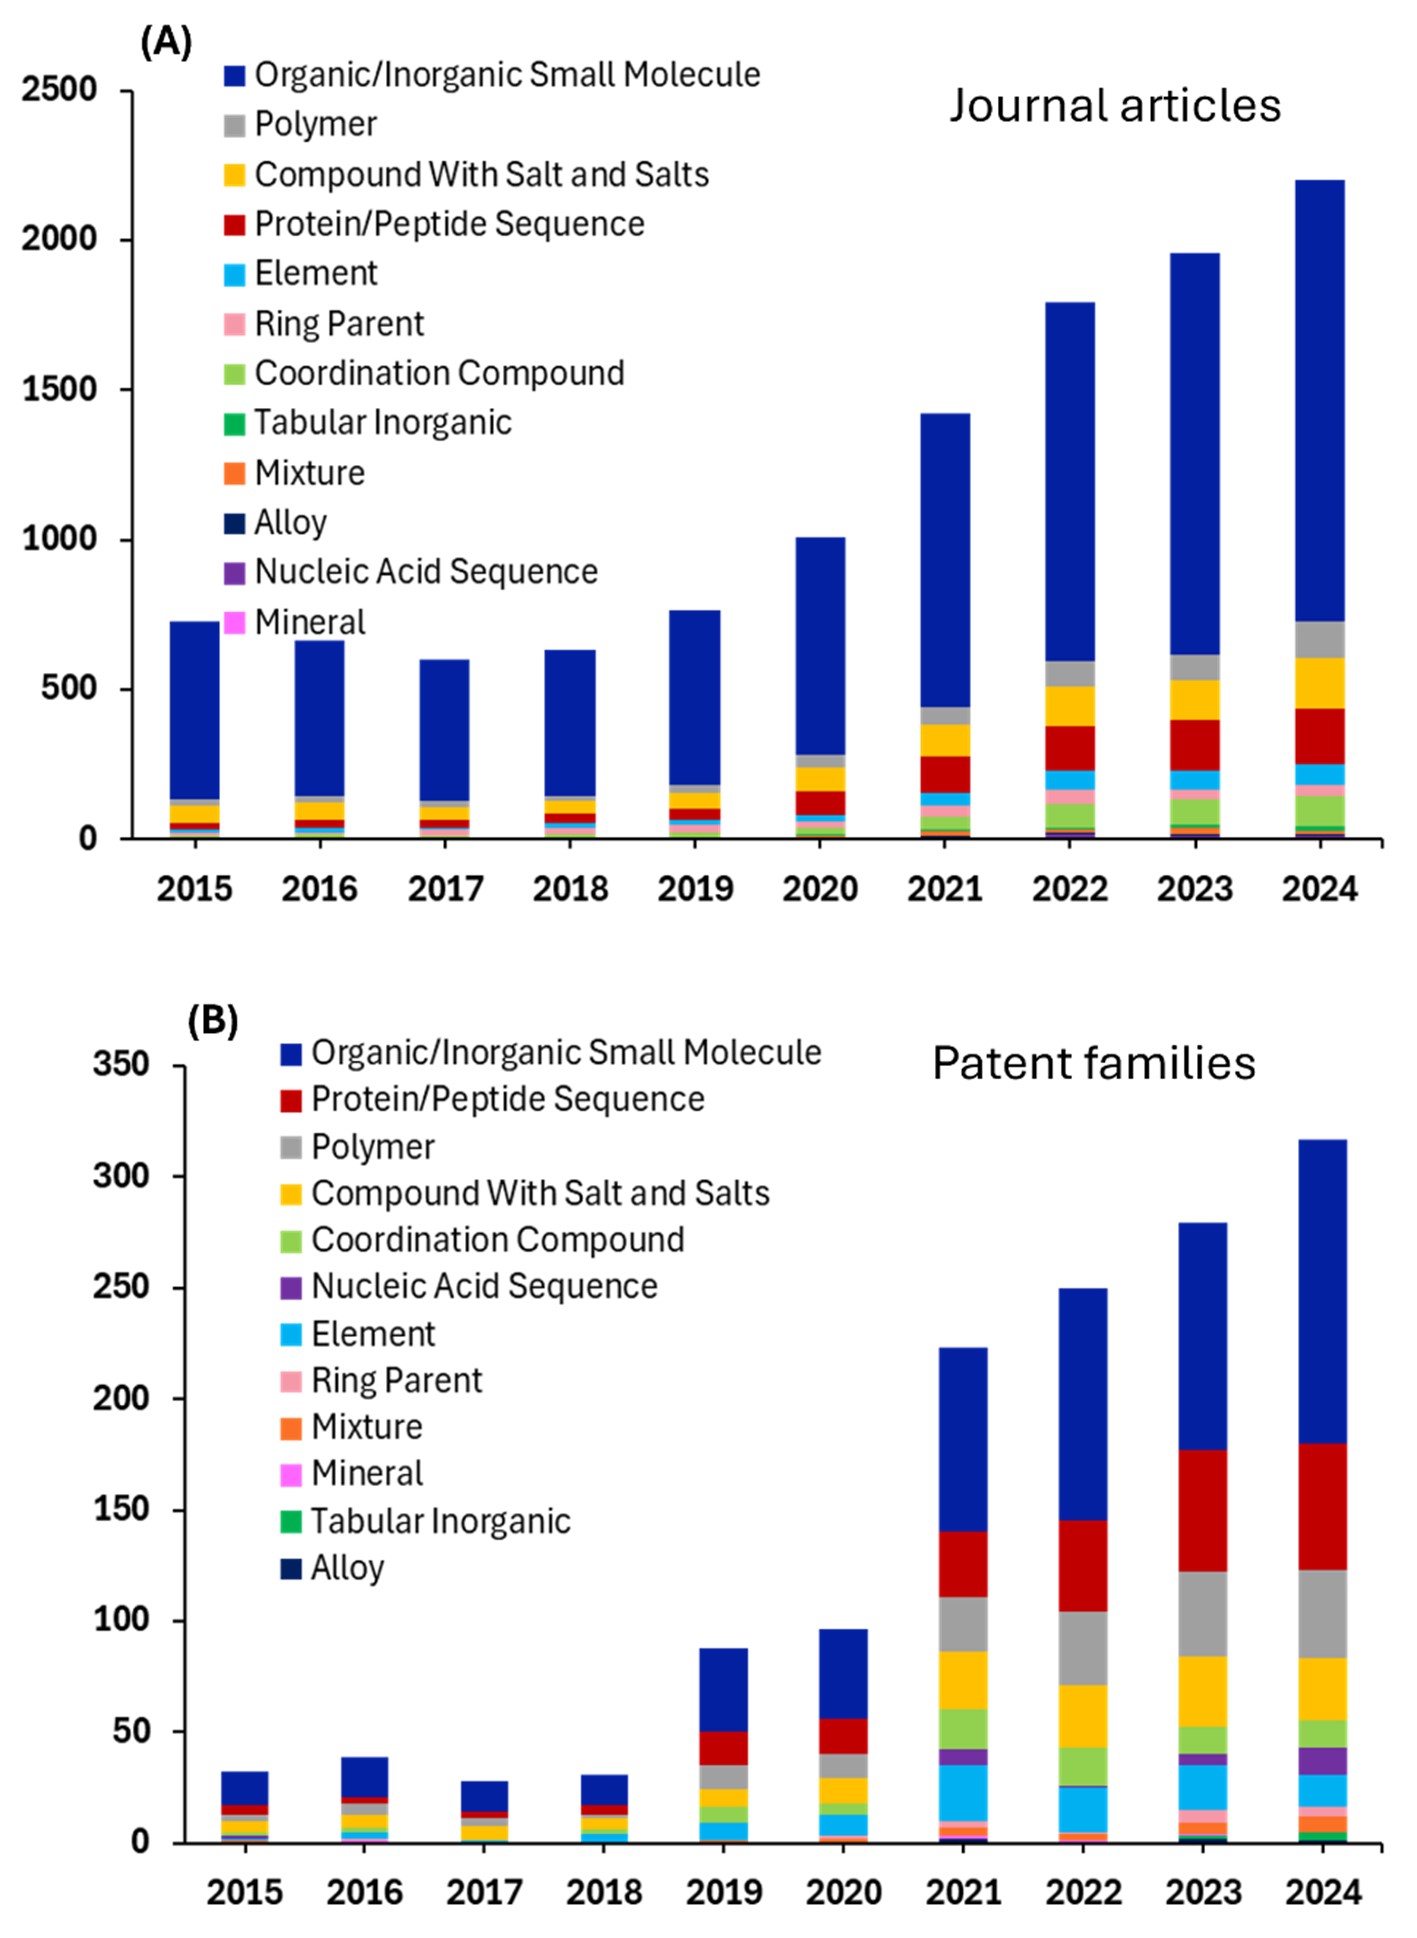
Los fármacos de moléculas pequeñas siguen dominando la investigación y el desarrollo farmacéuticos, y las tecnologías de IA están acelerando su descubrimiento. El cribado virtual basado en aprendizaje automático (ML), el modelado QSAR para la predicción farmacocinética y los sistemas de aprendizaje profundo que optimizan las rutas sintéticas son ahora parte integral de este proceso. Estas innovaciones se basan en las ventajas inherentes de las moléculas pequeñas, como las rutas de síntesis establecidas, una farmacocinética bien caracterizada, la biodisponibilidad oral y una fabricación rentable.
Las terapias con proteínas/péptidos constituyen la segunda categoría más investigada. Herramientas como AlphaFold han revolucionado la predicción de la estructura de las proteínas, permitiendo el diseño y la optimización de proteínas terapéuticas como la insulina para la diabetes, el activador tisular del plasminógeno para los accidentes cerebrovasculares y los anticuerpos monoclonales para el cáncer y las enfermedades autoinmunes. Los modelos de ML mejoran aún más este campo al predecir las interacciones proteína-proteína y optimizar la estabilidad de los péptidos.
Los compuestos con sales se benefician de algoritmos de optimización de formulaciones basados en IA que predicen la solubilidad, la biodisponibilidad y la estabilidad, lo que refleja la importancia de la formulación de fármacos y la optimización de la biodisponibilidad. Los polímeros, que a menudo sirven como sistemas de administración terapéutica cruciales, se están mejorando mediante formulaciones de nanopartículas diseñadas por IA, propiedades de hidrogel optimizadas por ML y modelos predictivos para la administración dirigida de fármacos, lo que mejora la eficacia terapéutica y la especificidad tisular.
Los compuestos de coordinación son otra clase prometedora, en la que la IA ayuda en el diseño de ligandos y en la optimización de estructuras metal-orgánicas (MOF). Estos compuestos se están perfeccionando mediante química computacional y modelos de IA que predicen las interacciones metal-ligando y la actividad biológica.
Aplicaciones de los modelos de IA en la ciencia de materiales
Visión general
En ciencia de materiales, comprender y predecir las complejas relaciones entre la composición del material, sus características estructurales y sus propiedades es esencial para acelerar el descubrimiento de nuevos materiales. Los datos implicados suelen ser multidimensionales, jerárquicos, heterogéneos y generados mediante procesos de alto rendimiento e intensivos en datos. La IA, en particular el aprendizaje automático (ML), está revolucionando el campo al permitir el análisis de estos complejos conjuntos de datos. Analizamos la CAS Content Collection para identificar conceptos clave de la ciencia de materiales en los que se aplican métodos de IA y evaluamos su importancia en el descubrimiento de materiales y la predicción de propiedades (véase la Figura 8).

El almacenamiento de energía es el área de investigación más intensiva en IA dentro de Aplicaciones, lo que refleja la necesidad mundial de tecnologías de baterías avanzadas y soluciones energéticas sostenibles. Las técnicas de ML se han convertido en herramientas potentes para la innovación en materiales para baterías, y los investigadores utilizan tres estrategias principales: predicciones directas de propiedades, potenciales de aprendizaje automático y diseño inverso. La alta concentración de investigación en IA en este campo se debe a la compleja naturaleza multiescala de los sistemas de baterías, donde los enfoques experimentales tradicionales a menudo no logran optimizar las intrincadas relaciones entre la composición del material, su estructura y su rendimiento electroquímico.
En las categorías de Materiales y Dispositivos, la importante actividad de IA en cerámica, piezocerámica, sensores y transistores de efecto de campo refleja la naturaleza sofisticada de estos materiales y sus dispositivos. Estos materiales avanzados suelen presentar complejas relaciones estructura-propiedad que son candidatas ideales para los enfoques de ML.
En Características estructurales, descubrimos que las redes neuronales convolucionales (CNN), junto con la visión artificial, se utilizan para el análisis microestructural al permitir la clasificación, segmentación y extracción de características automatizadas a partir de imágenes de microscopía. Estas herramientas están ayudando a descubrir relaciones estructura-propiedad que antes eran difíciles de cuantificar. En metalurgia, los enfoques de IA dirigidos están impulsando el desarrollo de superaleaciones, mientras que sistemas como CAMEO (Exploración y Optimización Autónoma de Materiales en Bucle Cerrado) permiten la metalurgia combinatoria al integrar la IA con la experimentación de alto rendimiento. Además, las herramientas de aprendizaje automático para datos de tomografía 3D están mejorando el análisis de materiales porosos, lo que permite un modelado más preciso de propiedades como la permeabilidad y la resistencia mecánica.
La constante dieléctrica y la conductividad eléctrica son los conceptos principales en Propiedades, mientras que la piezoelectricidad lidera en Fenómenos. En Simulación y Modelado, el modelado computacional muestra una alta adopción de IA, lo que concuerda con la compatibilidad natural del aprendizaje automático con las tareas de análisis de datos.
Las áreas de actividad moderada de IA representadas por las regiones de color púrpura y mixto en la Figura 7 son campos donde la adopción de la IA se está acelerando, pero que tienen margen de mejora. Por ejemplo, la baja actividad en algunas áreas de materiales, mostrada predominantemente en azul, representa algunos de los dominios más establecidos y fundamentales de la ciencia, creando una situación paradójica en la que los campos más maduros muestran la menor integración de IA. Los materiales compuestos y los polímeros son los principales ejemplos de esta categoría.
Sin embargo, se están desarrollando modelos de IA especializados para abordar retos específicos. El modelo polyBERT trata las estructuras de los polímeros como un lenguaje químico, lo que permite un modelado más eficaz de sistemas poliméricos complejos. Para los materiales cristalinos, modelos como MEGNet, CGCNN y SchNet incorporan la simetría cristalina y las interacciones cuánticas, mientras que ALIGNN captura las interacciones atómicas de orden superior esenciales para una predicción precisa de las propiedades de las aleaciones.
Coocurrencias de modelos de IA y conceptos de ciencia de materiales
Al igual que en nuestro análisis biomédico, examinamos detenidamente los métodos de IA y los conceptos concurrentes en la ciencia de materiales. Observamos que los modelos tradicionales de aprendizaje automático (ML), como los bosques aleatorios (RF), las máquinas de vectores de soporte (SVM), los modelos de potenciación de gradiente (GBM) y los árboles de decisión (DT), se utilizan ampliamente para el análisis de predicción y la importancia de las características, debido en gran medida a la alta dimensionalidad de los datos con relaciones no lineales, algo habitual en la informática de materiales (véase la Figura 9).


Los modelos RF se utilizan ampliamente y están distribuidos en todas las áreas conceptuales. Junto con los modelos GBM, muestran una fuerte concurrencia con materiales complejos y heterogéneos debido a su capacidad para modelar relaciones no lineales y gestionar tipos de datos mixtos. A menudo se emplean en compuestos heterogéneos, la predicción de propiedades mecánicas y el análisis de fallos al capturar las complejas interacciones entre la matriz y el refuerzo.
Observamos que estos coinciden con las aleaciones, donde el RF se utiliza para mapear relaciones no lineales en las composiciones de las aleaciones, lo que ayuda en el diseño de aleaciones de alta entropía, la predicción del endurecimiento por precipitación y la optimización del tratamiento térmico. El GB se aplica cada vez más para el ajuste preciso de propiedades, como la optimización del límite elástico o la resistencia a la corrosión.
Las SVM se utilizan con mayor frecuencia en materiales que presentan relaciones estructura-propiedad bien definidas. Este tipo de modelo es eficaz para clasificar tipos de aleaciones y umbrales mediante vectores de características de dimensión fija. Las propiedades dependientes de la temperatura también suelen seguir patrones no lineales y dependen de la composición, el historial de procesamiento y las condiciones ambientales, aspectos que los métodos basados en árboles y las SVM capturan eficazmente.
Para características estructurales como la microestructura, se emplean modelos de conjunto para identificar características a partir de imágenes complejas; clasificar límites de grano, fases y defectos; y predecir estructuras cristalinas, a menudo tratadas como problemas de clasificación que requieren modelos que tengan en cuenta la simetría. Las propiedades superficiales, que abarcan desde escalas atómicas hasta macroscópicas, implican patrones complejos en la energía superficial y la reactividad. Estas aplicaciones exigen el preprocesamiento de datos de imagen, la extracción de características multiescala y la codificación de la simetría y la periodicidad, especialmente para estudios de catálisis, corrosión y adhesión, lo que a menudo requiere la integración con el modelado molecular.
Los dominios de aplicación se han ampliado considerablemente, y la investigación sobre baterías muestra un crecimiento espectacular. Las figuras 9A y 9B confirman la fuerte correlación del RF con los procesos electroquímicos, gestionando interacciones complejas para la predicción de la capacidad de las baterías, la selección de materiales de electrodos y los procesos dependientes del tiempo.
La aparición de aplicaciones relacionadas con la energía (almacenamiento de energía, generación de energía) en el periodo 2020-2024 demuestra la diversificación del campo. La memoria a largo y corto plazo (LSTM) captura la dinámica temporal, que es crucial para la predicción de la degradación de las baterías y la previsión del rendimiento del ciclo. Otra correlación emergente es el aprendizaje por refuerzo (RL), que es capaz de optimizar los protocolos de carga y el uso de materiales, y puede utilizarse en sistemas de gestión de baterías. También se observan filtros de Kalman en baterías y baterías secundarias, los cuales se utilizan para realizar un seguimiento del estado del material durante el procesamiento y predecir la estimación del estado de salud de la batería y su vida útil restante.
Los transformadores se utilizan para extraer procedimientos de síntesis y propiedades de los materiales a partir de la literatura científica y para capturar dependencias de largo alcance en descripciones complejas de materiales. Las redes neuronales convolucionales (CNN) y las GAN automatizan la extracción de características a partir de estructuras 2D/3D y respaldan la predicción de propiedades y el reconocimiento de patrones. A pesar de su potencia, requieren más datos y capacidad de cálculo y ofrecen una menor interpretabilidad, por lo que complementan a los modelos tradicionales en lugar de sustituirlos. Las redes neuronales se utilizan cada vez más en el análisis basado en imágenes y el diseño generativo, mientras que los métodos tradicionales mantienen ventajas en el mapeo de composición-propiedad con conjuntos de datos limitados. Esta es otra razón por la que las redes neuronales y los modelos tradicionales se utilizan en combinación. Otro avance son las arquitecturas de CNN específicas para materiales que incorporan simetría y restricciones físicas, mientras que las GNN están ganando terreno para estructuras atómicas y moleculares.
Sustancias en la ciencia de materiales
Volviendo a las categorías de sustancias indexadas por CAS, analizamos el número de publicaciones relacionadas con estas sustancias en la ciencia de materiales (véase la Figura 10).

El predominio de las moléculas pequeñas orgánicas/inorgánicas en la investigación impulsada por la IA refleja las ventajas computacionales del campo y la abundancia de datos en el manejo de estructuras pequeñas en términos de coste computacional frente a sistemas complejos más grandes, como los polímeros. Con aproximadamente 6500 artículos de revistas, esta categoría se beneficia de décadas de bases de datos químicas acumuladas.
Las moléculas pequeñas son especialmente adecuadas para los enfoques de ML porque sus propiedades pueden codificarse eficazmente mediante descriptores moleculares, huellas dactilares y representaciones basadas en grafos. El gran volumen de investigación en esta área también indica la fuerte inversión de las industrias farmacéutica y química en IA para el descubrimiento de fármacos, el diseño de catalizadores y la predicción de propiedades moleculares.
Los elementos, que ocupan el segundo lugar con alrededor de 5500 artículos, se benefician de manera similar de extensas bases de datos y de la relativa simplicidad de sus estructuras, lo que los convierte en candidatos ideales para la predicción de propiedades y el descubrimiento de materiales mediante IA.
Los materiales inorgánicos tabulares, con aproximadamente 4500 artículos de revistas, representan otra área donde la IA ha encontrado aplicaciones sustanciales. Estos materiales —que incluyen cerámicas, óxidos y otros compuestos inorgánicos estructurados— se benefician de bases de datos cristalográficas y mediciones de propiedades sistemáticas que proporcionan los grandes conjuntos de datos necesarios para un aprendizaje automático eficaz. La naturaleza estructurada de estos materiales permite una ingeniería de características coherente basada en la estructura cristalina, la composición y las características de enlace. La prominencia de esta categoría en la investigación de IA refleja probablemente el enfoque de la comunidad de ciencia de materiales en el descubrimiento de nuevos materiales funcionales para el almacenamiento de energía, la catálisis y las aplicaciones electrónicas y magnéticas.
La investigación sobre polímeros muestra una adopción moderada de la IA con alrededor de 1800 artículos de revistas, lo que puede parecer bajo dada la importancia industrial de los polímeros. Esto refleja probablemente los desafíos únicos que presentan los polímeros para las aplicaciones de IA, incluidas sus complejas estructuras de cadena, distribuciones de peso molecular y propiedades dependientes del procesamiento. Sin embargo, el creciente volumen de investigación sugiere un éxito cada vez mayor en la aplicación de la IA a la predicción de propiedades, la síntesis y la optimización del procesamiento de polímeros.
Otro hallazgo importante de nuestro análisis es cómo las familias de patentes representan solo una fracción de los artículos de revistas en todas las categorías de la ciencia de materiales. La disparidad entre el número de revistas y patentes sugiere que gran parte de la investigación en IA en la ciencia de materiales permanece en la etapa fundamental o exploratoria, con importantes desfases temporales entre los descubrimientos académicos y las aplicaciones prácticas dignas de protección mediante patente en la etapa comercial.
El número relativamente pequeño de patentes también puede reflejar el desafío de traducir los descubrimientos de materiales impulsados por la IA en tecnologías comercialmente viables, ya que muchas aplicaciones de IA en este campo se centran en la predicción de propiedades y la comprensión fundamental en lugar de en invenciones inmediatamente patentables. La proporción constante en los diferentes tipos de materiales indica que el desafío de la traducción de lo académico a lo comercial es universal en toda la ciencia de materiales, en lugar de ser específico de determinadas clases de materiales.
La IA en la gestión de procesos
La IA está transformando la gestión de procesos al permitir una toma de decisiones más inteligente, rápida y adaptable. El análisis del papel de la IA en este ámbito revela cómo la automatización, el análisis predictivo y la optimización en tiempo real pueden impulsar la excelencia operativa en todos los sectores (véase la Figura 11).

La optimización impulsada por IA se utiliza ampliamente en la fabricación aditiva, las industrias petroquímicas, el procesamiento de plásticos, la metalurgia, la química de flujo, los procesos catalíticos y el descubrimiento y síntesis de fármacos. Los modelos utilizados habitualmente incluyen la metodología de superficie de respuesta (RSM), el diseño de experimentos, así como técnicas de aprendizaje automático como las RNA, modelos híbridos, PINN, LLM y enfoques de aprendizaje por refuerzo. Exploremos otras tecnologías que están extendiendo el modelado predictivo hacia la toma de decisiones y la automatización en tiempo real:
- Monitorización en tiempo real: estos sistemas analizan datos en flujo mediante aprendizaje automático para detectar patrones, tendencias y señales de alerta temprana, lo que facilita la previsión dinámica y la toma de decisiones proactiva. Entre las innovaciones clave se incluyen la toma de decisiones autónoma, donde los parámetros se ajustan automáticamente según las entradas en tiempo real; el mantenimiento predictivo, que anticipa los fallos antes de que ocurran; y los modelos de autoaprendizaje que se adaptan a las condiciones cambiantes. Además, la visualización de datos en tiempo real y los sistemas de alerta inteligentes están transformando la forma en que los operadores interactúan con los datos de procesos en vivo. Estos avances se aplican en sectores como los sistemas de cromatografía automatizados y la monitorización de reacciones farmacológicas en la fabricación farmacéutica. También observamos su uso en la optimización de propiedades en la producción de polímeros, el análisis de residuos sólidos en la gestión de desechos, la monitorización medioambiental, la gestión de energía y recursos para la producción de hidrógeno a gran escala y la gestión energética basada en la nube para infraestructuras antiguas.
- Sensores virtuales: Utilizando datos en tiempo real de sensores físicos, estos aprovechan la IA y los modelos estadísticos para estimar variables que resultan difíciles o costosas de medir directamente. Se aplican ampliamente en diversos sectores, incluida la monitorización de bioprocesos y el control de la calidad del agua residual y del aire. En el control de procesos químicos, los sensores virtuales se utilizan para monitorizar la flotación compleja de minerales de sulfuro, la isomerización, la destilación reactiva y la mezcla de gasolinas.
- Gemelos digitales: Estas innovaciones son réplicas virtuales de sistemas físicos que evolucionan rápidamente con la integración de la IA para permitir la optimización en tiempo real, el análisis predictivo y las operaciones autónomas. La IA mejora los gemelos digitales al aprender de datos históricos y en tiempo real para simular estados futuros, detectar anomalías y predecir fallos, transformándolos de modelos estáticos en sistemas resilientes y auto-optimizables. En la fabricación, los gemelos digitales impulsados por IA predicen fallos en los equipos, optimizan los procesos de producción y detectan problemas de calidad mediante sensores e imágenes. En el ámbito sanitario, simulan estados de pacientes, apoyan la medicina personalizada, modelan enfermedades, simulan ensayos clínicos y optimizan la inmunoterapia. En los ámbitos medioambiental y de sostenibilidad, los gemelos digitales basados en IA se aplican en el almacenamiento geológico de carbono, el procesamiento de residuos minerales y la gestión de recursos. También apoyan la ciencia de materiales, permitiendo el descubrimiento automatizado, el análisis de defectos y el diseño molecular inverso.
Desafíos para el uso de la IA en la investigación científica
La IA ha realizado contribuciones positivas a todos los campos de la investigación científica y seguirá haciéndolo a medida que avance. Sin embargo, estas innovaciones no están exentas de desafíos que los investigadores y científicos de datos deben abordar para garantizar que la IA alcance su máximo potencial en la ciencia. Algunos de los retos más urgentes incluyen:
- Privacidad y seguridad de los datos: Garantizar la privacidad y la seguridad de los datos es uno de los mayores desafíos en la implementación de la IA, ya que requiere un gran volumen de datos confidenciales para su entrenamiento y funcionamiento. Los problemas surgen cuando se recopila y utiliza información sensible sin el permiso adecuado, o cuando esta se filtra o es robada de los sistemas de IA. Los conjuntos de datos científicos pueden contener resultados experimentales no publicados, estructuras de compuestos novedosos y métodos de síntesis patentados que representan importantes ventajas competitivas. Cuando los investigadores utilizan plataformas de IA basadas en la nube o participan en entornos de investigación colaborativa, se enfrentan a riesgos sustanciales de exposición de la propiedad intelectual. Para combatir este riesgo, algunas empresas están implementando salvaguardas para proteger la información de los clientes y mantener la confianza, con nuevas empresas emergentesencontrando nichos de mercado para protegerse contra las amenazas externas de la IA.
- Calidad y sesgo de los datos: Los conjuntos de datos suelen sufrir sesgos sistemáticos que pueden propagarse a través de los modelos de IA, lo que conduce a predicciones sesgadas y, potencialmente, refuerza las desigualdades de investigación existentes. Los sesgos históricos en los datos de reacciones publicados, donde las reacciones exitosas están sobrerrepresentadas y los experimentos fallidos no se notifican, pueden perjudicar significativamente la capacidad de los modelos de aprendizaje automático para explorar nuevos espacios químicos, particularmente en materiales inorgánicos. Este "sesgo de publicación" crea un ciclo de autorrefuerzo donde los sistemas de IA recomiendan preferentemente compuestos similares a los ya bien estudiados. Los modelos de IA generativa presentan preocupaciones adicionales, ya que pueden manipular datos existentes y alucinar para satisfacer las solicitudes de los clientes a expensas de pruebas reales.
- Transparencia: La naturaleza de "caja negra" de estos modelos puede ocultar el razonamiento detrás de sus predicciones, lo que dificulta que los investigadores evalúen su fiabilidad o identifiquen posibles modos de fallo. Unarevisión de los métodos de IA explicable en el descubrimiento de fármacos destacó cómo la falta de interpretabilidad en modelos complejos puede socavar la confianza entre los químicos medicinales e impedir la aceptación regulatoria de las decisiones guiadas por IA en el desarrollo farmacéutico. Este desafío es particularmente agudo para las redes neuronales de grafos y los modelos transformadores que operan con representaciones químicas de alta dimensión, donde la relación entre las características de entrada y las predicciones se vuelve altamente no lineal.
- Equilibrio entre la automatización y la experiencia humana: Aunque los sistemas de IA pueden procesar vastos conjuntos de datos e identificar patrones más allá de la capacidad cognitiva humana, carecen de la intuición, la creatividad y la comprensión contextual que los científicos experimentados aportan a los problemas de investigación. Esto puede conducir a una generación de científicos que carezcan de habilidades de investigación fundamentales y de comprensión conceptual. Por el contrario, también puede llevar a una “aversión algorítmica” cuando las conclusiones impulsadas por la IA contradicen la intuición.
Modelos de IA y el futuro de la investigación científica
La importancia de la IA para la investigación científica no hará más que aumentar, y sus capacidades revolucionarias ya se están materializando en campos como la biomedicina y la ciencia de materiales. Como muestra nuestro análisis de la CAS Content Collection, constantemente se aplican nuevas aplicaciones, modelos y métodos a preguntas de investigación complejas. Podemos esperar que los avances en el descubrimiento de fármacos, el diagnóstico de enfermedades, el desarrollo de materiales y mucho más estén influenciados o totalmente impulsados por tecnologías basadas en IA.
A medida que la IA pase de ser una herramienta a un socio científico colaborativo, es probable que veamos nuevos paradigmas como el diseño inverso y los laboratorios autónomos redefiniendo la metodología científica hacia motores de descubrimiento autónomos. Sin embargo, las bajas tasas de patentes frente a publicaciones indican que gran parte de la investigación permanece en el ámbito académico, particularmente en los campos tradicionales de la ciencia de materiales.
Una mayor adopción de la IA requiere una calibración adecuada de la confianza a través de soluciones técnicas como la cuantificación de la incertidumbre y la transparencia del modelo. La naturaleza amplia del impacto de la IA en la ciencia y el alcance de los desafíos en su implementación significan que la colaboración y la visibilidad serán clave para maximizar sus beneficios para el avance científico.
Para obtener más información, lea nuestro artículo de revista reimpreso: "La revolución de la IA en la química: dando forma al futuro de las ciencias de los materiales y biomédicas."
El uso de nombres de marca y/o cualquier mención de productos o servicios de terceros en este documento tiene fines exclusivamente educativos y no implica el respaldo de CAS o de la American Chemical Society, ni la discriminación contra marcas, productos o servicios similares no mencionados.


