

Resumo executivo
No cenário da pesquisa científica moderna, a inteligência artificial (IA) emergiu como uma força transformadora, alterando fundamentalmente a forma como os pesquisadores conceituam, conduzem e validam seu trabalho. A convergência de poder computacional, algoritmos avançados e vastos conjuntos de dados impulsionou a IA de uma possibilidade teórica a uma necessidade prática em todas as disciplinas científicas.
Esta revolução aborda vários desafios de longa data que limitaram o progresso científico: o volume avassalador de dados gerados em áreas como genômica, medicina e ciência dos materiais; o tempo e os custos extensivos de processos como a descoberta de fármacos; e as limitações cognitivas na geração de hipóteses. A IA oferece caminhos novos e promissores para superar esses desafios e encontrar avanços mais rápidos em muitas disciplinas científicas.
Por exemplo, nas ciências biomédicas, a IA revolucionou a previsão da estrutura de proteínas, acelerou o processo de descoberta de fármacos e possibilitou a medicina personalizada. Da mesma forma, nas ciências dos materiais, a IA está acelerando a descoberta de novos materiais. Esses avanços abriram caminho para laboratórios autônomos e estruturas de design inverso, que estão mudando o próprio método científico. A IA também avançou significativamente na otimização de processos, permitindo ajustes experimentais em tempo real para melhorar o rendimento e a eficiência, reduzindo desperdícios e custos.
Realizamos uma análise quantitativa da CAS Content CollectionTM, o maior repositório de informações científicas com curadoria humana, para entender a implementação e o impacto desses avanços tecnológicos na descoberta científica. Analisamos sistematicamente mais de 310.000 artigos de periódicos e patentes da CAS Content Collection abrangendo os anos de 2015 a 2025, empregando técnicas analíticas avançadas para identificar publicações relacionadas à IA e suas metodologias, instituições e domínios de pesquisa associados.
Nosso estudo explora a distribuição de métodos de IA em campos científicos com análises aprofundadas de dois domínios críticos: ciências biomédicas e ciência dos materiais. Essas análises detalham conceitos dominantes, padrões de coocorrência de métodos de IA e classes de substâncias notáveis. Além disso, investigamos o papel da IA na otimização de processos industriais e aplicações emergentes.
Essas descobertas fornecem insights essenciais sobre o estado atual e a trajetória da integração da IA na pesquisa científica, oferecendo orientações valiosas para pesquisadores, instituições e formuladores de políticas na compreensão de padrões de adoção tecnológica, identificação de oportunidades de colaboração e tomada de decisões estratégicas informadas sobre futuros investimentos em IA e direções de pesquisa.
O cenário dos modelos de IA na ciência
Para entender o contexto em que certos modelos são selecionados e seu impacto, conduzimos uma análise abrangente de publicações científicas, incluindo periódicos e famílias de patentes, que incorporaram métodos baseados em IA. A visualização de todo o cenário destaca a crescente integração dessas tecnologias em todas as disciplinas científicas à medida que mais modelos e funcionalidades são desenvolvidos (veja a Figura 1).

Os principais ramos desta visualização incluem:
Modelos de classificação, regressão e agrupamento
Os modelos de classificação são projetados para prever rótulos ou categorias discretas e são especialmente eficazes no tratamento de dados de alta dimensão e no fornecimento de resultados interpretáveis. Modelos comuns incluem Árvores de Decisão (DT), um modelo que classifica resultados dividindo recursivamente os dados em ramos. Random Forest (RF) é um conjunto de árvores de decisão que reduz o sobreajuste (overfitting) ao calcular a média das previsões. Outro modelo comum, a Máquina de Vetores de Suporte (SVM), encontra o limite ideal entre as classes, enquanto o K-Nearest Neighbors (KNN) classifica a classe majoritária dos vizinhos mais próximos.
Esses modelos são amplamente aplicados a conjuntos de dados rotulados (aprendizado supervisionado) com resultados categóricos, como espectroscopia, microscopia ou dados ômicos com classes conhecidas. Exemplos de aplicações incluem a classificação de tipos de doenças a partir de expressão gênica ou dados de imagem, previsão de classes de materiais e classificação de compostos com base em toxicidade ou reatividade.
Modelos de regressão preveem valores numéricos contínuos, tornando-os ideais para previsão e otimização. Alguns dos modelos de regressão observados em publicações são Regressão Linear, Regressão Logística, Regressão de Vetor de Suporte (SVR) e Regressão Simbólica. Esses modelos são adequados para dados numéricos de experimentos, simulações ou dados de séries temporais de sensores ou instrumentos. As aplicações incluem a previsão de níveis de energia, taxas de decaimento ou trajetórias de partículas, estimativa de rendimentos de reação, propriedades moleculares, modelagem de temperatura, precipitação, previsão de condutividade, dureza e band gaps.
Diferente da classificação e da regressão, os modelos de agrupamento (clustering) descobrem agrupamentos naturais em dados não rotulados, revelando estruturas ocultas e apoiando a análise exploratória (aprendizado não supervisionado). Esses modelos são eficazes para conjuntos de dados não rotulados de alta dimensão, como dados de imagem, espectrais e moleculares. Dados científicos adequados para este grupo incluem, mas não se limitam a, agrupar genes ou amostras com base em perfis de expressão e descobrir novas famílias de materiais a partir de dados estruturais.
Redes neurais artificiais (RNAs)
As RNAs são uma classe de modelos de aprendizado de máquina (ML) projetados para aprender padrões complexos por meio de camadas interconectadas de neurônios artificiais. Elas são poderosas para modelar relacionamentos não lineares complexos em dados. Como resultado, formam a base do aprendizado profundo e são o alicerce da IA moderna, com arquiteturas especializadas como Redes Neurais Recorrentes (RNNs) para dados sequenciais, Long-Short Term Memory (LSTM), uma RNN aprimorada que captura melhor dependências de longo alcance, e Gated Recurrent Units (GRUs), que são uma versão simplificada das LSTMs com menos parâmetros.
Esses modelos são adequados para dados de sequência e séries temporais, como expressão gênica, sequências de proteínas, sinais fisiológicos, dados climáticos, física de partículas e dados de redes de sensores. Eles frequentemente aprimoram o alinhamento imagem-texto aproveitando mapas de conhecimento — representações estruturadas de conceitos específicos de domínio e seus relacionamentos — o que ajuda a preencher a lacuna semântica entre dados visuais (como imagens médicas) e descrições textuais (como notas clínicas ou relatórios de diagnóstico). Sua adoção aumentou em áreas como descoberta e desenvolvimento de medicamentos, medicina de precisão, imagens médicas, descoberta e design de materiais, armazenamento de energia, manufatura e controle de qualidade.
Métodos hibridizados
A comparação entre RNAs e modelos convencionais de ML, como classificação, regressão e agrupamento, não se trata simplesmente de qual é melhor, mas sim de entender seus papéis complementares. As RNAs dominam onde os dados são complexos e não estruturados, onde existem grandes conjuntos de dados de treinamento e quando o aprendizado de representação é necessário. Por outro lado, o ML convencional permanece forte onde os dados são pequenos, os problemas de pesquisa exigem interpretabilidade rigorosa e as entradas possuem relacionamentos estatísticos bem compreendidos e exigem quantificação de incerteza.
Modelos específicos de domínio
Embora os modelos específicos de domínio tenham menos publicações, eles incluem trabalhos inovadores como o AlphaFold, uma abordagem de aprendizado profundo que alcançou precisão quase experimental na previsão da estrutura de proteínas. O ESMFold é outro modelo interessante que aproveita diretamente a modelagem de linguagem de proteínas para gerar previsões de estrutura de alta qualidade diretamente a partir de sequências de proteínas únicas.
Processamento de linguagem natural (PLN)
O PLN é usado para analisar, entender, interpretar e gerar linguagem humana. Envolve tarefas como tokenização (dividir o texto em unidades menores chamadas tokens, geralmente palavras ou subpalavras) que podem ser processadas por algoritmos. Um método comum para representar texto é o modelo Bag of Words (BoW), que converte texto em vetores numéricos com base na frequência das palavras, ignorando a gramática e a ordem das palavras. Outra técnica fundamental é o Reconhecimento de Entidade Nomeada (NER), que identifica e classifica entidades como nomes de pessoas, organizações e locais dentro do texto.
Existem amplas aplicações de modelos de PLN na mineração de textos biomédicos e extração de conhecimento, variando de modelos de linguagem especializados pré-treinados em literatura biomédica (por exemplo, BioBERT, BioGPT) e análise de registros eletrônicos de saúde (EHR) até a extração automatizada de características de doenças de registros clínicos e a criação de novos candidatos a medicamentos usando modelos de linguagem. Na ciência dos materiais e química, o PLN tem sido usado para extração de protocolos de síntese, previsão de propriedades de materiais, construção de bases de conhecimento e design inverso.
Grandes modelos de linguagem (LLMs)
Esta classe transformadora de sistemas de IA revolucionou o PLN e encontrou amplas aplicações em domínios científicos. Os LLMs são sistemas baseados em redes neurais treinados em vastas quantidades de dados de texto para aprender padrões estatísticos da linguagem. Eles são usados em extração de informações, sumarização, construção de grafos de conhecimento, integração entre domínios e aplicações generativas.
LLMs amplamente adotados incluem o Generative Pre-Trained Transformer (GPT), que impulsiona o ChatGPT e o GPT-3.5 e GPT-4. O Bidirectional Encoder Representations from Transformers (BERT) continua sendo um dos principais modelos de linguagem, mantendo forte interesse acadêmico devido à sua compreensão de contexto bidirecional e desempenho superior em resposta a perguntas e análise de sentimento.
O BLOOM, um modelo multilíngue, emergiu como um contribuidor significativo para o cenário de pesquisa. Novos modelos como o GEMINI, desenvolvido pelo Google DeepMind, e o LLAMA, da Meta AI, também estão se tornando populares, assim como o Claude, desenvolvido pela Anthropic. A última geração de modelos, Gemma, Falcon, Mistral, Qwen e DeepSeek, lançados entre 2023 e 2025, mostra grande promessa para desenvolvimentos futuros.
Vários LLMs especializados para química, ciências da vida e ciência dos materiais também estão causando impacto, como o chemLLM, PharmaGPT e MatSciBERT.
Tendências de publicação mostram o impacto da IA na ciência
Como observado, analisamos 310.000 documentos na CAS Content Collection relacionados à IA em pesquisa científica durante o período de 2015-2025. Notamos um crescimento constante durante todo o período, com um crescimento proeminente nos últimos cinco anos (veja a Figura 2). O número crescente de famílias de patentes sugere ainda que a IA está evoluindo de uma tecnologia emergente para uma ferramenta de pesquisa essencial em vários setores.

- Distribuição por país/região e organização: A China lidera em volume de publicações (artigos e patentes), enquanto os EUA, a Índia, a Coreia do Sul e o Japão também apresentam um crescimento constante nas publicações (veja a Figura 3). No geral, os dados destacam a ascensão da Ásia como o novo epicentro da inovação científica global em IA, com os países ocidentais ficando para trás em termos de produção quantitativa.

- Distribuição em famílias de patentes: Analisamos ainda as tendências de publicação de artigos e patentes dos cinco principais países. A China e a Índia juntas contribuem com mais de 75% das patentes globais nesta área — as 15 principais instituições em termos de pedidos de patentes são da China e da Índia. As universidades chinesas dominam em volume de publicações científicas, com a contagem média de citações para a maioria delas variando entre 10 e 20. Em contrapartida, o MIT e Stanford ostentam contagens médias de citações significativamente maiores, de 32 e 66, respectivamente. Isso sugere que, embora a China se destaque em quantidade, as universidades dos EUA lideram em termos de qualidade e impacto de seus artigos científicos no campo da IA.
- Distribuição em publicações específicas: Analisamos o volume de publicações e o impacto das citações dos principais periódicos científicos que publicam pesquisas baseadas em IA. O volume de publicações é dominado por Scientific Reports, Applied Sciences e PLoS One. No entanto, ao considerar a contagem média de citações por artigo, a Proceedings of the National Academy of Sciences (PNAS) se destaca, demonstrando uma influência excepcional com quase 50 citações por publicação, apesar de ter um volume de publicações relativamente modesto. Outros periódicos, como o Journal of Chemical Information and Modelling (JCIM), Bioinformatics e Nature Communications também apresentam uma média de citações notável, superando significativamente os periódicos com grande volume. Esse padrão sugere que, embora periódicos de amplo escopo como a Scientific Reports publiquem a maior parte das pesquisas relacionadas à IA, periódicos especializados ou de prestígio como a PNAS, JCIM e Nature Communications publicam trabalhos mais influentes que geram maior impacto científico.
- Tendências por área científica: Inúmeras áreas foram fortemente impactadas pela IA, mas várias se destacam pelo crescimento exponencial nas publicações (veja a Figura 4):

Entre todas as disciplinas, a Química Industrial e Engenharia Química demonstra o crescimento mais dramático em publicações científicas, com sua trajetória atingindo aproximadamente 8% do total de documentos até 2024. Esse crescimento excepcional provavelmente reflete as amplas aplicações da área em manufatura, otimização de processos e inovação industrial, bem como seu papel crítico no desenvolvimento de processos industriais sustentáveis e soluções de química verde.
A Química Analítica surge como a segunda área de crescimento mais rápido em termos de publicações científicas, com a linha azul escura mostrando um crescimento robusto durante todo o período a partir de 2019. Esse forte padrão de crescimento mostra a importância fundamental da área em todas as vertentes da química e seu papel no desenvolvimento de novas técnicas de medição, instrumentação e métodos analíticos que apoiam pesquisas em múltiplas disciplinas.
Tecnologia Energética e Química Ambiental demonstram um crescimento sólido, ocupando conjuntamente o terceiro lugar entre as áreas de crescimento mais rápido, juntamente com a Bioquímica. Isso reflete o foco global urgente nas mudanças climáticas, nos desafios da sustentabilidade ambiental e em eventos emergentes.
As disciplinas restantes, incluindo Físico-Química, Farmacologia, Toxicologia e Farmacêutica, Química Orgânica, Química Inorgânica, Produtos Naturais e Polímeros Sintéticos, demonstram aumentos modestos, porém consistentes, no volume de publicações. Essas áreas representam campos maduros de pesquisa científica onde os princípios fundamentais estão bem estabelecidos, mas a investigação contínua produz avanços e refinamentos incrementais.
Os dados de famílias de patentes apresentam um cenário notavelmente diferente em comparação com as publicações científicas, com padrões de inovação altamente variados e concentrados, em vez do crescimento uniforme observado na produção acadêmica. Esse contraste destaca a diferença fundamental entre a produtividade da pesquisa acadêmica e a inovação comercialmente viável, onde as forças de mercado, as aplicações práticas e os incentivos econômicos desempenham papéis decisivos na determinação de quais avanços científicos se traduzem em propriedade intelectual patenteável.
Entre as patentes, a Bioquímica mostra um crescimento quase exponencial, atingindo aproximadamente 8% até 2024 e ofuscando completamente todas as outras disciplinas. O cenário de patentes em bioquímica é dominado por métodos biomédicos e moldado por inovações que unem a ciência molecular a tecnologias avançadas de saúde. Os principais domínios incluem detecção de doenças, imagens médicas, monitoramento vestível e suporte à decisão clínica, todos aproveitando marcadores bioquímicos. A Bioquímica também impulsiona o progresso em interfaces neurológicas, genômica, descoberta de biomarcadores, processamento de sinais, orientação cirúrgica e manufatura biomédica, destacando seu papel central na inovação biomédica moderna. Essa atividade dramática de patentes reflete o intenso interesse comercial e o investimento em pesquisa em ciências da vida em geral, impulsionado ainda mais em resposta à pandemia de COVID, quando a pesquisa comercial recebeu financiamento significativo.
Com base em nossa análise, descobrimos que a maioria das publicações relacionadas à IA está ligada à pesquisa biomédica e à ciência dos materiais. Portanto, realizamos uma análise aprofundada dessas áreas de pesquisa fundamentais, uma vez que esses campos dominam o conjunto de dados, exibem uma rápida adoção de IA com taxas de crescimento anual notáveis e geram maiores impactos de citação, indicando sua relevância científica.
Aplicações de modelos de IA na pesquisa biomédica
Visão geral
A pesquisa biomédica tem enfrentado desafios contínuos de complexidade e custos que a IA agora pode resolver. Por exemplo, decodificar estruturas e interações proteicas complexas, os altos custos e taxas de falha associados ao desenvolvimento de medicamentos e as complexidades de entender mecanismos de doenças multifatoriais se prestam a abordagens baseadas em IA.
Integridade de dados para pesquisa científica impulsionada por IA. A capacidade da IA para dados e sua velocidade computacional superam o que os humanos são capazes de fazer, e a tecnologia continuará a redefinir o que é possível. Mas a integridade e a harmonização dos dados são componentes críticos de qualquer aplicação bem-sucedida de IA na ciência.
A lógica por trás desta análise foi garantir uma amostragem representativa das áreas de pesquisa mais significativas, usando a frequência de documentos como uma métrica objetiva para identificar conceitos-chave. Especificamente, identificamos conceitos que geraram interesse científico substancial e investimento em pesquisa usando vários métodos de IA/ML dentro do campo biomédico (veja a Figura 5).

No domínio da Bioquímica, sequências e estruturas proteicas, genes e expressão gênica, além de DNA/genômica, tornaram-se os conceitos mais estudados, utilizando diversas abordagens de aprendizado de máquina. Modelos de ML prosperam nessas áreas devido à abundância e padronização de dados, especialmente em sistemas complexos como hierarquias proteicas e redes regulatórias gênicas. O ML se destaca em tarefas como mapeamento sequência-função, classificação de famílias de proteínas, predição de domínios, análise estrutura-função, seleção de características tumorais, predição de interação gênica no câncer e agrupamento de genes por padrões de expressão em oncologia, aproveitando dados de expressão de alta dimensão com milhares de genes medidos simultaneamente, relações não lineares complexas entre genes e fenótipos, e a organização hierárquica de redes regulatórias genéticas.
Modelos avançados de ML, como AlphaFold e BERT, são usados para a predição de estruturas proteicas, aprendendo a partir de sequências de aminoácidos e padrões evolutivos para prever o dobramento 3D e domínios funcionais. Esses modelos lidam eficazmente com relações espaciais complexas e entradas sequenciais com dependências de longo alcance.
No domínio de Modelagem e Design de Fármacos, a modelagem QSAR domina o campo. Ela utiliza métodos de ML para extrair descritores moleculares (ou seja, propriedades físico-químicas, impressões digitais) de estruturas químicas para prever atividades biológicas e pontos de toxicidade por meio de abordagens de aprendizado supervisionado. Esses métodos se destacam com descritores moleculares ricos em características, relações estrutura-atividade e pontos finais quantitativos adequados para tarefas de regressão.
O docking molecular, o segundo conceito mais frequente, utiliza abordagens de aprendizado profundo (CNN e GNN) em dados estruturais 3D e grafos moleculares para prever poses e afinidades de ligação proteína-ligante, aproveitando conformações espaciais, paisagens energéticas e interações moleculares. A farmacocinética segue como a próxima área de foco, usando ML para aprender a partir de descritores moleculares, parâmetros fisiológicos e dados de séries temporais para prever propriedades ADMET (Absorção, Distribuição, Metabolismo, Excreção, Toxicidade) e taxas de depuração de fármacos.
Biomarcadores dominam o domínio de Diagnóstico, onde métodos de ML analisam dados genômicos, proteômicos e metabolômicos de alta dimensão para identificar assinaturas moleculares discriminatórias que distinguem estados de doença de controles saudáveis por meio de seleção de características e classificação. Métodos de IA também são usados em pesquisas de prognóstico para analisar dados clínicos de pacientes e histórico de tratamento para prever tempos de sobrevivência e progressão da doença por meio de técnicas de análise de sobrevivência.
A imagem médica contém dados de raios-X, tomografias, ressonâncias magnéticas e informações espaciais estruturadas, ideais para métodos de aprendizado profundo. CNNs são amplamente utilizadas para analisar imagens radiológicas para detecção de tumores, identificação de fraturas, classificação de doenças e condições patológicas por meio de reconhecimento automatizado de padrões. A imagem também se beneficia da capacidade do aprendizado profundo de extrair características multiescala e realizar tarefas de segmentação, particularmente no diagnóstico de câncer, onde auxilia na detecção de tumores, classificação, avaliação de malignidade e predição de risco.
No domínio de Doenças, a pesquisa sobre câncer recebeu a maior atenção, com vários modelos de ML aplicados com base nos tipos de dados. Dados genômicos e transcriptômicos são comumente analisados usando modelos RF e SVM para classificação de subtipos de câncer e predição de tratamento. Essas tarefas se beneficiam da integração de dados multi-ômicos, que capturam diversas camadas moleculares, e da modelagem da complexidade de microambientes tumorais heterogêneos.
Vários algoritmos são usados na pesquisa de diabetes para prever complicações diabéticas e otimizar protocolos de tratamento, aproveitando dados de monitoramento longitudinal, interações complexas entre fatores de estilo de vida e genética, e problemas de predição de séries temporais para níveis de glicose. Na doença de Alzheimer, modelos RF e SVM são amplamente usados para predição precoce, analisando pontuações de testes neuropsicológicos, níveis de biomarcadores (beta-amiloide, proteínas tau) e dados demográficos para classificar pacientes em categorias saudáveis ou com comprometimento cognitivo leve.
No domínio de Terapia, agentes antitumorais receberam a maior atenção em pesquisas, empregando métodos de ML para triagem de fármacos e predição de atividade, analisando descritores moleculares e propriedades químicas para identificar compostos com potencial atividade anticancerígena. Na quimioterapia, esses métodos preveem respostas ao tratamento e toxicidade analisando dados clínicos de pacientes, perfis genéticos e características tumorais para personalizar a seleção de fármacos e protocolos de dosagem. Da mesma forma, esses modelos apoiam a imunoterapia analisando perfis imunológicos de pacientes, carga mutacional tumoral e expressões de biomarcadores para prever a resposta e otimizar resultados terapêuticos, abordando a complexidade das interações imunes e dinâmicas temporais.
Coocorrências de modelos de IA e conceitos biomédicos
Nossa análise explora os padrões de coocorrência entre conceitos biomédicos e vários métodos de IA/ML, elucidando suas aplicações estratégicas nos cinco domínios (veja a Figura 6).


Random Forest (RF) emergiu como o método de IA dominante na pesquisa biomédica, mostrando um crescimento notável e superando a Support Vector Machine (SVM) entre os dois períodos. O RF mostra forte coocorrência com conceitos em todos os domínios das ciências biomédicas, particularmente em bioquímica, diagnóstico e pesquisas relacionadas a doenças. O RF é usado para predição e classificação de funções proteicas analisando a composição de aminoácidos, motivos de sequência e propriedades físico-químicas para classificar proteínas em famílias funcionais. Na descoberta de biomarcadores, o RF é usado para analisar dados genômicos, proteômicos e metabolômicos de alta dimensão.
A Support Vector Machine (SVM), embora tenha crescido de forma constante entre os períodos, mantém uma presença significativa com proteínas, expressão gênica, DNA e genômica, biomarcadores, prognóstico, imagem médica e pesquisa sobre câncer. Em estudos de proteínas, a SVM é usada para classificação e anotação funcional de proteínas analisando sequências de aminoácidos, características estruturais e propriedades físico-químicas. Ela também prevê a localização subcelular e identifica classes de enzimas usando mapeamento de espaço de características de alta dimensão baseado em kernel.
Na expressão gênica, a SVM identifica genes envolvidos em processos bioquímicos específicos, classifica vias metabólicas e prevê genes codificadores de enzimas com base em seus padrões de expressão em diferentes condições bioquímicas e estados celulares. Para a classificação de variantes genômicas, a SVM processa características e anotações de sequências de DNA para distinguir mutações patogênicas de benignas e identificar regiões genômicas associadas a doenças por meio de análise de características de alta dimensão de padrões de nucleotídeos e contexto genômico.
Na pesquisa de biomarcadores, a SVM apoia a identificação, classificação e validação integrando múltiplos biomarcadores em modelos preditivos para diagnóstico, resposta ao tratamento, avaliação de risco de progressão de doença e estratificação de pacientes para abordagens de medicina personalizada. A SVM é usada na pesquisa de câncer para distinguir entre tecidos cancerígenos e normais, classificar tipos de câncer e identificar subtipos moleculares dentro de cânceres específicos. Também é usada para prognóstico de câncer e predição de tratamento, integrando parâmetros clínicos, perfis de biomarcadores e características genômicas para prever resultados de sobrevivência do paciente, respostas ao tratamento, padrões de resistência a fármacos e risco de recorrência. A Figura 6B revela que a SVM manteve força na modelagem QSAR e SAR, enquanto suas conexões com a análise de proteínas enfraqueceram em relação ao RF no período posterior.
A Regressão Logística (LR) é um método estatístico amplamente utilizado e interpretável na pesquisa biomédica, frequentemente coocorrendo com conceitos-chave como proteínas, expressão gênica, biomarcadores, prognóstico, imagem médica, câncer e COVID-19. Na predição de função proteica, a LR analisa a composição de aminoácidos, características de sequência e propriedades estruturais para classificar proteínas em categorias funcionais ou estruturais. A principal vantagem do modelo é fornecer coeficientes interpretáveis que indicam a contribuição relativa de cada característica para a decisão de classificação, permitindo que os pesquisadores identifiquem quais propriedades de aminoácidos ou características estruturais influenciam mais fortemente as predições.
Essa interpretabilidade é igualmente valiosa na classificação de expressão gênica, onde a LR ajuda a identificar genes diferencialmente expressos. Para validação de biomarcadores e diagnósticos, modelos de LR preveem resultados binários, como doente/saudável ou respondedor/não respondedor, e fornecem razões de chances clinicamente significativas para a tomada de decisão diagnóstica. Na modelagem prognóstica, a LR usa uma predição de resultado binário semelhante, avaliando parâmetros clínicos, perfis de biomarcadores e dados demográficos dos pacientes para prever resultados como mortalidade/sobrevivência, recorrência/remissão da doença, prognóstico favorável/desfavorável.
A LR é usada no diagnóstico, predição de gravidade e mortalidade por COVID-19, integrando comorbidades, sinais vitais e biomarcadores, apoiando a estratificação de risco e a tomada de decisão clínica. Essas diversas aplicações ressaltam o forte alinhamento da LR com temas centrais da pesquisa biomédica, tornando-a uma ferramenta fundamental para modelagem interpretável e clinicamente relevante. A Figura 6B ilustra a maior adaptabilidade da Regressão Logística, provavelmente devido à capacidade de classificação multiclasse e saídas baseadas em probabilidade, ao contrário da regressão linear, que é limitada a predições contínuas.
Como visto na Figura 6B, o período de 2020-2024 testemunhou o surgimento de abordagens especializadas de aprendizado profundo quase inexistentes anteriormente, como o AlphaFold. Este período também viu um aumento no uso de Redes Neurais em Grafos (GNN) para modelagem de interação molecular, Redes Adversárias em Grafos (GAN) para geração de dados sintéticos e Reconhecimento de Padrões para aplicações de imagem e desafios diagnósticos.
Outra mudança importante nos últimos anos é a integração de técnicas de PNL na pesquisa biomédica, destacada pela ascensão de modelos como o BERT para mineração de relatórios clínicos e análise de textos biomédicos. Essa especialização reflete o amadurecimento da área, que vai além da aplicação de métodos genéricos de IA para o desenvolvimento de abordagens personalizadas para desafios biomédicos específicos.
As prioridades de pesquisa mudaram substancialmente entre os dois períodos. A análise de sequências e estruturas de proteínas e a análise de expressão gênica cresceram significativamente entre 2020 e 2024 (Figura 6B). A descoberta de biomarcadores e as aplicações de imagem também experimentaram um crescimento dramático, enquanto a pesquisa específica sobre doenças expandiu consideravelmente, com a COVID-19 surgindo como um foco principal e a pesquisa sobre câncer diversificando-se em múltiplos subtipos.
Substâncias na pesquisa biomédica
Esta comparação fornece uma visão estratégica sobre oportunidades terapêuticas pouco exploradas e destaca classes de substâncias que podem se beneficiar de um maior investimento em pesquisa ou de abordagens inovadoras para preencher a lacuna entre a descoberta científica e a aplicação clínica (veja a Figura 7). Observe que “classes de substâncias” refere-se a categorias de substâncias indexadas pelo CAS com aplicações terapêuticas reconhecidas.
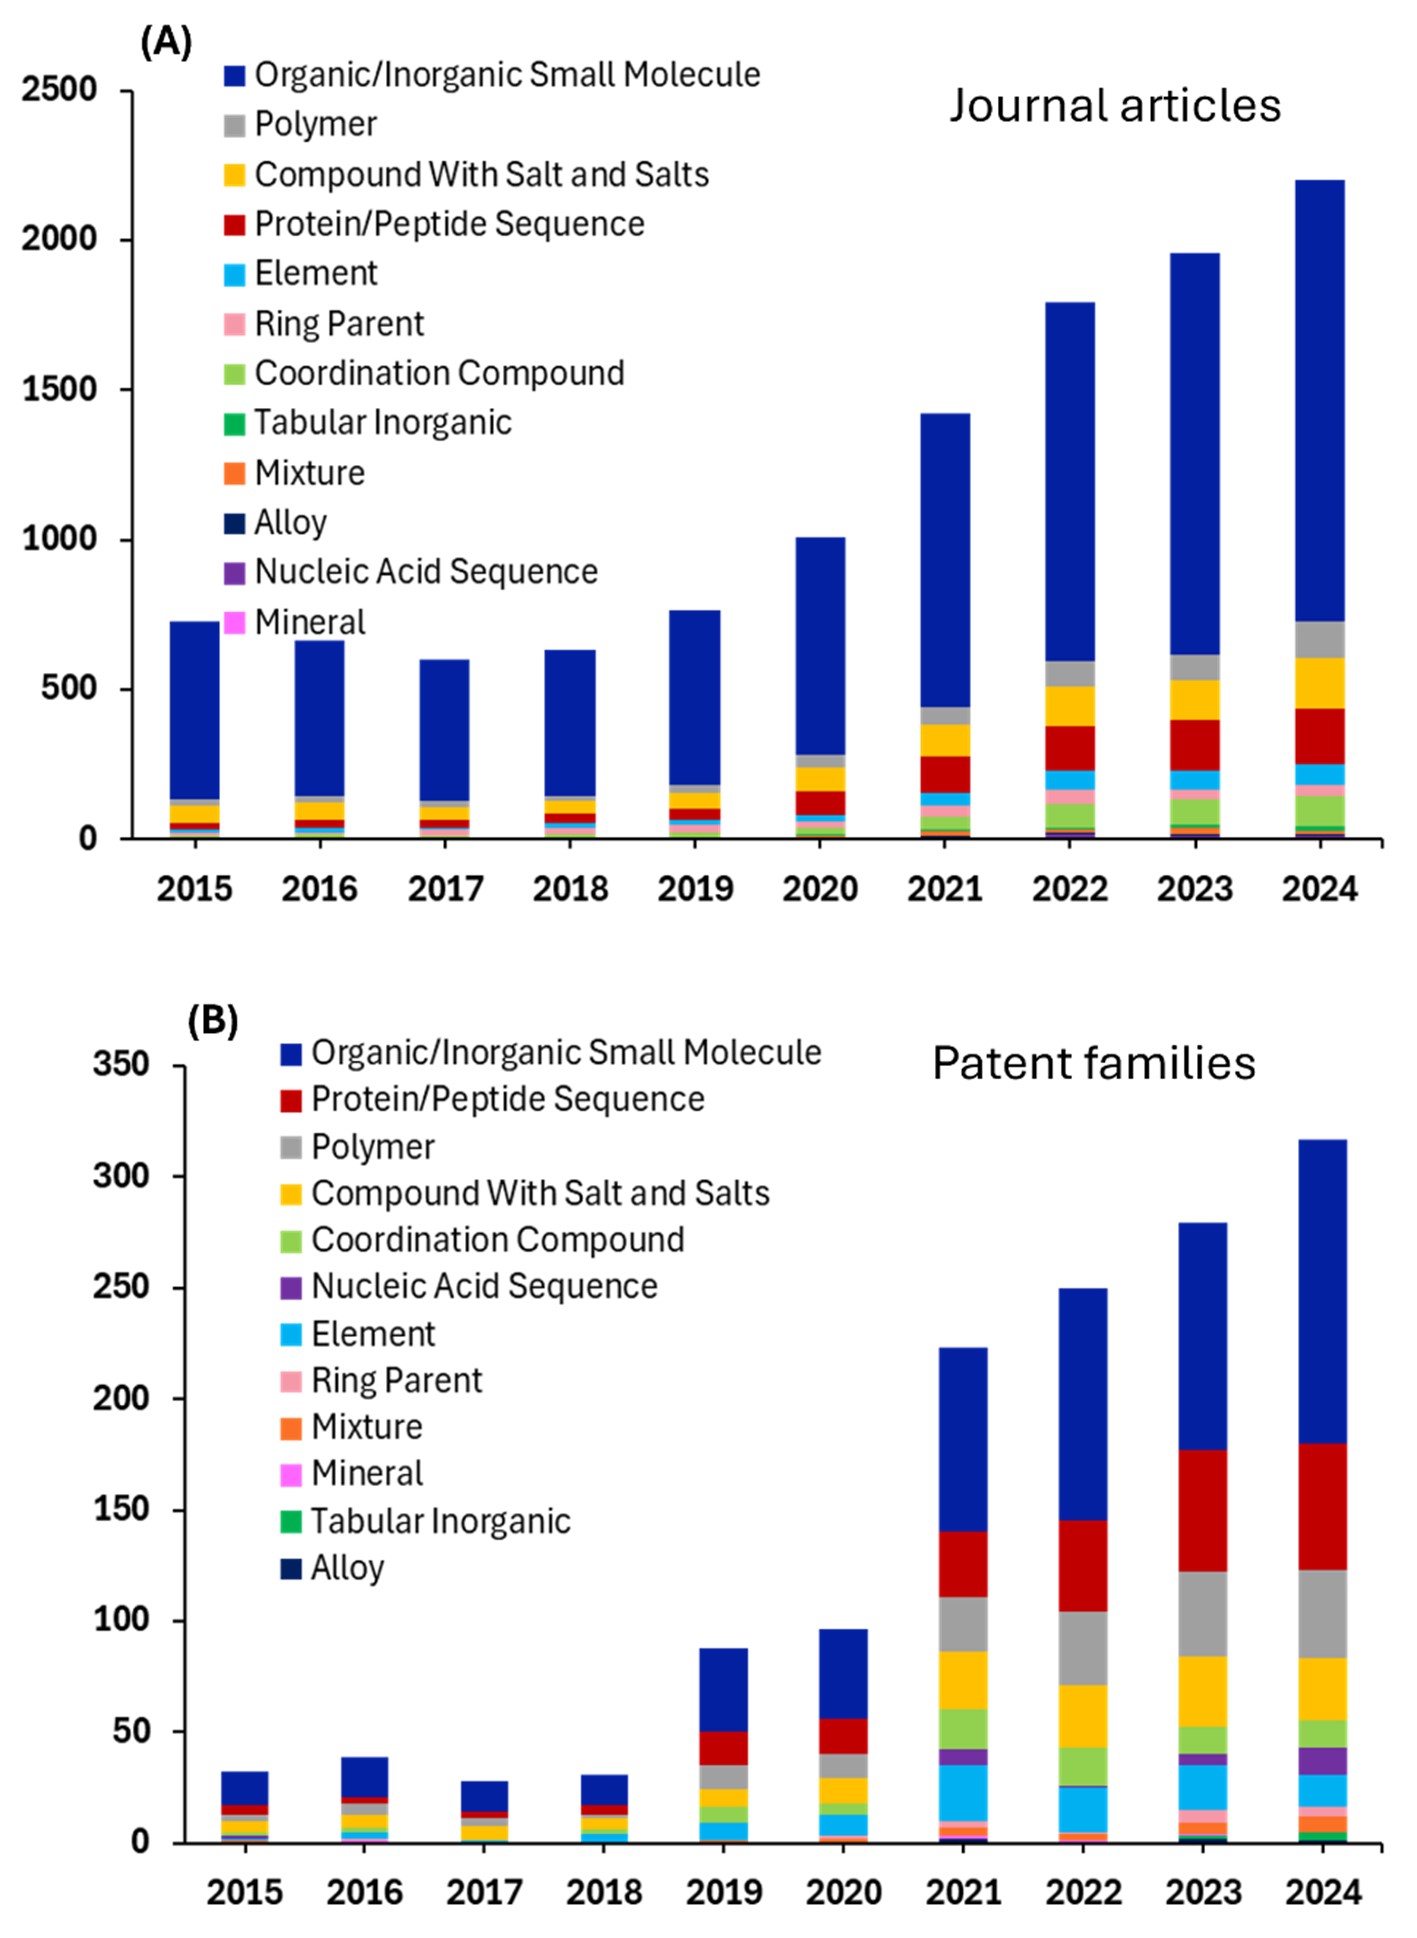
Drogas de pequenas moléculas continuam a dominar a pesquisa e o desenvolvimento farmacêutico, com tecnologias de IA acelerando sua descoberta. A triagem virtual baseada em aprendizado de máquina (ML), modelagem QSAR para previsão farmacocinética e sistemas de aprendizado profundo que otimizam vias sintéticas são agora parte integrante desse processo. Essas inovações baseiam-se nas vantagens inerentes das pequenas moléculas, incluindo rotas de síntese estabelecidas, farmacocinética bem caracterizada, biodisponibilidade oral e fabricação econômica.
Terapias com proteínas/peptídeos constituem a segunda categoria mais pesquisada. Ferramentas como o AlphaFold revolucionaram a previsão da estrutura de proteínas, permitindo o design e a otimização de proteínas terapêuticas, como a insulina para diabetes, o ativador de plasminogênio tecidual para derrames e anticorpos monoclonais para câncer e doenças autoimunes. Modelos de ML aprimoram ainda mais esse campo ao prever interações proteína-proteína e otimizar a estabilidade de peptídeos.
Compostos com sais e sais beneficiam-se de algoritmos de otimização de formulação impulsionados por IA que preveem solubilidade, biodisponibilidade e estabilidade, refletindo a importância da formulação de medicamentos e da otimização da biodisponibilidade. Polímeros, que frequentemente servem como sistemas cruciais de entrega terapêutica, estão sendo aprimorados por meio de formulações de nanopartículas projetadas por IA, propriedades de hidrogel otimizadas por ML e modelagem preditiva para entrega direcionada de medicamentos, melhorando a eficácia terapêutica e a especificidade tecidual.
Compostos de coordenação são outra classe promissora, na qual a IA auxilia no design de ligantes e na otimização de redes metalorgânicas (MOFs). Esses compostos estão sendo refinados por meio de química computacional e modelos de IA que preveem interações metal-ligante e atividade biológica.
Aplicações de modelos de IA na ciência dos materiais
Visão geral
Na ciência dos materiais, compreender e prever as relações complexas entre a composição, as características estruturais e as propriedades dos materiais é essencial para acelerar a descoberta de novos materiais. Os dados envolvidos são frequentemente multidimensionais, hierárquicos, heterogêneos e gerados por meio de processos de alto rendimento e intensivos em dados. A IA, particularmente o aprendizado de máquina (ML), está revolucionando o campo ao permitir a análise desses conjuntos de dados complexos. Analisamos a CAS Content Collection para identificar conceitos-chave da ciência dos materiais onde métodos de IA são aplicados e avaliamos sua importância na descoberta de materiais e na previsão de propriedades (veja a Figura 8).

O armazenamento de energia é a área de pesquisa mais intensiva em IA em Aplicações, refletindo a necessidade global de tecnologias avançadas de bateria e soluções de energia sustentável. As técnicas de ML tornaram-se ferramentas potentes para a inovação em materiais de bateria, com pesquisadores utilizando três estratégias principais: previsões diretas de propriedades, potenciais de aprendizado de máquina e design inverso. A alta concentração de pesquisa em IA neste campo decorre da natureza complexa e multiescala dos sistemas de bateria, onde as abordagens experimentais tradicionais muitas vezes não conseguem otimizar as relações intrincadas entre composição do material, estrutura e desempenho eletroquímico.
Nas categorias Materiais e Dispositivos, a atividade significativa de IA em cerâmicas, piezocerâmicas, sensores e transistores de efeito de campo reflete a natureza sofisticada desses materiais e seus dispositivos. Esses materiais avançados frequentemente exibem relações complexas entre estrutura e propriedade que são candidatas ideais para abordagens de ML.
Em Características Estruturais, descobrimos que redes neurais convolucionais (CNNs), juntamente com a visão computacional, são usadas para análise microestrutural, permitindo a classificação, segmentação e extração de características automatizadas a partir de imagens de microscopia. Essas ferramentas estão ajudando a descobrir relações entre estrutura e propriedade que antes eram difíceis de quantificar. Na metalurgia, abordagens direcionadas de IA estão avançando no desenvolvimento de superligas, enquanto sistemas como o CAMEO (Exploração e Otimização Autônoma de Materiais em Circuito Fechado) permitem a metalurgia combinatória ao integrar IA com experimentação de alto rendimento. Além disso, ferramentas de aprendizado de máquina para dados de tomografia 3D estão aprimorando a análise de materiais porosos, permitindo uma modelagem mais precisa de propriedades como permeabilidade e resistência mecânica.
Constante dielétrica e condutividade elétrica são os principais conceitos em Propriedades, enquanto a piezoeletricidade lidera em Fenômenos. Em Simulação e Modelagem, a modelagem computacional mostra uma alta adoção de IA, o que se alinha à compatibilidade natural do aprendizado de máquina com tarefas de análise de dados.
As áreas de atividade moderada de IA representadas pelas regiões roxas e de cores mistas na Figura 7 são campos onde a adoção de IA está acelerando, mas ainda há espaço para melhorias. Por exemplo, a baixa atividade em algumas áreas de materiais, predominantemente mostrada em azul, representa alguns dos domínios mais estabelecidos e fundamentais da ciência, criando uma situação paradoxal em que os campos mais maduros mostram a menor integração de IA. Materiais compósitos e polímeros são exemplos principais dessa categoria.
No entanto, modelos especializados de IA estão sendo desenvolvidos para enfrentar desafios específicos. O modelo polyBERT trata estruturas de polímeros como uma linguagem química, permitindo uma modelagem mais eficaz de sistemas poliméricos complexos. Para materiais cristalinos, modelos como MEGNet, CGCNN e SchNet incorporam simetria de cristal e interações quânticas, enquanto o ALIGNN captura interações atômicas de ordem superior essenciais para a previsão precisa das propriedades de ligas.
Coocorrências de modelos de IA e conceitos de ciência dos materiais
Assim como em nossa análise biomédica, examinamos detalhadamente os métodos de IA e os conceitos correlatos na ciência dos materiais. Descobrimos que modelos tradicionais de aprendizado de máquina (ML), como Random Forest (RF), Support Vector Machine (SVM), Gradient Boosting Machines (GBM) e árvores de decisão (DT), são amplamente utilizados para análise de previsão e importância de recursos, em grande parte devido aos dados de alta dimensão com relações não lineares, comuns na informática de materiais (veja a Figura 9).


Modelos de RF são amplamente utilizados e distribuídos por todas as áreas de conceito. Juntamente com modelos de GBM, eles apresentam fortes coocorrências com materiais complexos e heterogêneos devido à sua capacidade de modelar relações não lineares e lidar com tipos de dados mistos. Eles são frequentemente usados para compósitos heterogêneos, previsão de propriedades mecânicas e análise de falhas, capturando as interações complexas entre a matriz e o reforço.
Observamos essas coocorrências com ligas, onde o RF é usado para mapear relações não lineares em composições de ligas, auxiliando no design de ligas de alta entropia, na previsão de endurecimento por precipitação e na otimização de tratamento térmico. O GB é cada vez mais aplicado para o ajuste preciso de propriedades, como a otimização do limite de escoamento ou da resistência à corrosão.
O SVM é usado com mais frequência em materiais que possuem relações estrutura-propriedade bem definidas. Esse tipo de modelo é eficaz para classificar tipos de ligas e limites usando vetores de características de dimensão fixa. Propriedades dependentes da temperatura também costumam seguir padrões não lineares e dependem da composição, do histórico de processamento e das condições ambientais, o que métodos baseados em árvores e SVMs capturam de forma eficaz.
Para características estruturais como a microestrutura, modelos de conjunto (ensemble) são empregados para identificar características a partir de imagens complexas; classificar contornos de grão, fases e defeitos; e prever estruturas cristalinas, muitas vezes tratadas como problemas de classificação que exigem modelos que considerem a simetria. As propriedades de superfície, que abrangem desde escalas atômicas até macroscópicas, envolvem padrões complexos de energia superficial e reatividade. Essas aplicações exigem o pré-processamento de dados de imagem, a extração de características multiescala e a codificação de simetria e periodicidade, especialmente para estudos de catálise, corrosão e adesão, muitas vezes exigindo integração com modelagem molecular.
Os domínios de aplicação expandiram-se consideravelmente, com a pesquisa em baterias apresentando um crescimento dramático. As Figuras 9A e 9B confirmam a forte correlação do RF com processos eletroquímicos, lidando com interações complexas para a previsão da capacidade da bateria, seleção de materiais de eletrodo e processos dependentes do tempo.
O surgimento de aplicações relacionadas à energia (armazenamento de energia, geração de energia) no período de 2020-2024 demonstra a diversificação do campo. O Long-Short Term Memory (LSTM) captura dinâmicas temporais que são cruciais para a previsão da degradação da bateria e do desempenho do ciclo. Outra correlação emergente é o Aprendizado por Reforço (RL), que é capaz de otimizar protocolos de carregamento e uso de materiais, podendo ser utilizado em sistemas de gerenciamento de baterias. Filtros de Kalman também são observados em baterias e baterias secundárias, sendo usados para rastrear o estado do material durante o processamento e prever a estimativa do estado de saúde da bateria e a vida útil restante.
Transformers são usados na extração de procedimentos de síntese e propriedades de materiais a partir da literatura científica e na captura de dependências de longo alcance em descrições complexas de materiais. Redes Neurais Convolucionais (CNNs) e GANs automatizam a extração de características de estruturas 2D/3D e apoiam a previsão de propriedades e o reconhecimento de padrões. Apesar de seu poder, eles exigem mais dados e computação e oferecem menor interpretabilidade, complementando, portanto, em vez de substituir, os modelos tradicionais. As redes neurais são cada vez mais usadas em análises baseadas em imagem e design generativo, enquanto os métodos tradicionais mantêm vantagens no mapeamento composição-propriedade com conjuntos de dados limitados. Esta é outra razão pela qual redes neurais e modelos tradicionais são usados em combinação. Outro desenvolvimento são as arquiteturas de CNN específicas para materiais que incorporam simetria e restrições físicas, enquanto as GNNs estão ganhando força para estruturas atômicas e moleculares.
Substâncias na ciência dos materiais
Retornando às categorias de substâncias indexadas pelo CAS, analisamos o número de publicações relacionadas a essas substâncias na ciência dos materiais (veja a Figura 10).

A predominância de pequenas moléculas orgânicas/inorgânicas em pesquisas impulsionadas por IA reflete as vantagens computacionais do campo e a abundância de dados no tratamento de estruturas pequenas em termos de custo computacional em comparação com sistemas complexos maiores, como polímeros. Com aproximadamente 6.500 artigos científicos, esta categoria beneficia-se de décadas de bancos de dados químicos acumulados.
Pequenas moléculas são particularmente suscetíveis a abordagens de ML porque suas propriedades podem ser efetivamente codificadas usando descritores moleculares, impressões digitais e representações baseadas em grafos. O alto volume de pesquisa nesta área também indica o forte investimento das indústrias farmacêutica e química em IA para descoberta de medicamentos, design de catalisadores e previsão de propriedades moleculares.
Elementos, ocupando o segundo lugar com cerca de 5.500 artigos, beneficiam-se de forma semelhante de bancos de dados extensos e da relativa simplicidade de suas estruturas, tornando-os candidatos ideais para a previsão de propriedades e descoberta de materiais impulsionadas por IA.
Materiais inorgânicos tabulares, com aproximadamente 4.500 artigos científicos, representam outra área onde a IA encontrou aplicações substanciais. Esses materiais — que incluem cerâmicas, óxidos e outros compostos inorgânicos estruturados — beneficiam-se de bancos de dados cristalográficos e medições sistemáticas de propriedades que fornecem os grandes conjuntos de dados necessários para um aprendizado de máquina eficaz. A natureza estruturada desses materiais permite uma engenharia de recursos consistente baseada na estrutura cristalina, composição e características de ligação. A proeminência desta categoria na pesquisa de IA reflete provavelmente o foco da comunidade de ciência dos materiais na descoberta de novos materiais funcionais para armazenamento de energia, catálise e aplicações eletrônicas e magnéticas.
Polymer research shows moderate AI adoption with around 1,800 journal articles, which may seem low given the industrial importance of polymers. This likely reflects the unique challenges polymers present to AI applications, including their complex chain structures, molecular weight distributions, and processing-dependent properties. However, the growing research volume suggests increasing success in applying AI to polymer property prediction, synthesis, and processing optimization.
Outra descoberta importante de nossa análise é como as famílias de patentes representam apenas uma fração dos artigos científicos em todas as categorias da ciência dos materiais. A disparidade entre o número de periódicos e patentes sugere que grande parte da pesquisa em IA na ciência dos materiais permanece no estágio fundamental ou exploratório, com atrasos significativos entre as descobertas acadêmicas e as aplicações práticas dignas de proteção por patente no estágio comercial.
O número relativamente pequeno de patentes também pode refletir o desafio de traduzir descobertas de materiais impulsionadas por IA em tecnologias comercialmente viáveis, já que muitas aplicações de IA neste campo focam na previsão de propriedades e na compreensão fundamental, em vez de invenções imediatamente patenteáveis. A proporção consistente entre diferentes tipos de materiais indica que o desafio da tradução acadêmico-comercial é universal em toda a ciência dos materiais, em vez de ser específico para certas classes de materiais.
IA na gestão de processos
A IA está transformando a gestão de processos ao permitir uma tomada de decisão mais inteligente, rápida e adaptável. Analisar o papel da IA neste domínio revela como a automação, a análise preditiva e a otimização em tempo real podem impulsionar a excelência operacional em diversos setores (veja a Figura 11).

A otimização impulsionada por IA é amplamente utilizada na manufatura aditiva, indústrias petroquímicas, processamento de plásticos, metalurgia, química de fluxo, processos catalíticos e na descoberta e síntese de fármacos. Os modelos comumente usados incluem a metodologia de superfície de resposta (RSM), planejamento de experimentos, além de técnicas de ML como RNAs, modelos híbridos, PINN, LLMs e abordagens de Aprendizado por Reforço. Vamos explorar algumas outras tecnologias que estão estendendo a modelagem preditiva para a tomada de decisão e automação em tempo real:
- Monitoramento em tempo real: estes sistemas analisam dados em fluxo usando ML para detectar padrões, tendências e sinais de alerta precoce, facilitando a previsão dinâmica e a tomada de decisão proativa. As principais inovações incluem a tomada de decisão autônoma, onde os parâmetros são ajustados automaticamente com base em entradas em tempo real; a manutenção preditiva, que antecipa falhas antes que ocorram; e modelos de autoaperfeiçoamento que se ajustam a condições variáveis. Além disso, a visualização de dados em tempo real e sistemas de alerta inteligentes estão transformando a forma como os operadores interagem com dados de processos ao vivo. Esses avanços estão sendo aplicados em setores como sistemas de cromatografia automatizados e monitoramento de reações medicamentosas na fabricação farmacêutica. Também observamos seu uso na otimização de propriedades na produção de polímeros, análise de resíduos sólidos na gestão de resíduos, monitoramento ambiental, gestão de energia e recursos para a produção de hidrogênio em larga escala e gestão de energia baseada em nuvem para infraestruturas obsoletas.
- Sensores virtuais: Utilizando dados em tempo real de sensores físicos, eles aproveitam a IA e modelos estatísticos para estimar variáveis que são difíceis ou caras de medir diretamente. São amplamente aplicados em diversos setores, incluindo o monitoramento de bioprocessos e o controle da qualidade da água e do ar. No controle de processos químicos, sensores virtuais são usados para monitorar a flotação complexa de minérios de sulfeto, isomerização, destilação reativa e mistura de gasolina.
- Gêmeos digitais: Estas inovações são réplicas virtuais de sistemas físicos que evoluem rapidamente com a integração da IA para permitir otimização em tempo real, análise preditiva e operações autônomas. A IA aprimora os gêmeos digitais ao aprender com dados históricos e em tempo real para simular estados futuros, detectar anomalias e prever falhas, transformando-os de modelos estáticos em sistemas resilientes e auto-otimizáveis. Na manufatura, gêmeos digitais impulsionados por IA preveem falhas em equipamentos, otimizam processos de produção e detectam problemas de qualidade usando sensores e imagens. Na saúde, eles simulam condições de pacientes, apoiam medicamentos personalizados, modelam doenças, simulam ensaios clínicos e otimizam a imunoterapia. Nos domínios ambiental e de sustentabilidade, gêmeos digitais com IA são aplicados no armazenamento geológico de carbono, processamento de resíduos de minério e gestão de recursos. Eles também apoiam a ciência dos materiais, permitindo a descoberta automatizada, análise de defeitos e design molecular inverso.
Desafios para o uso da IA na pesquisa científica
A IA claramente contribuiu de forma positiva para todos os campos da pesquisa científica e continuará a fazê-lo à medida que avança. No entanto, essas inovações não estão isentas de desafios que pesquisadores e cientistas de dados devem enfrentar para garantir que a IA atinja seu potencial máximo na ciência. Alguns dos desafios mais urgentes incluem:
- Privacidade e segurança de dados: Garantir a privacidade e a segurança dos dados é um dos maiores desafios na implementação da IA, uma vez que ela necessita de um grande volume de dados sensíveis para treinamento e operação. Problemas ocorrem quando informações sensíveis são coletadas e usadas sem a devida permissão, ou quando são vazadas ou roubadas de sistemas de IA. Conjuntos de dados científicos podem conter resultados experimentais não publicados, estruturas de compostos inéditas e métodos de síntese proprietários que representam vantagens competitivas significativas. Quando pesquisadores utilizam plataformas de IA baseadas em nuvem ou participam de ambientes de pesquisa colaborativa, enfrentam riscos substanciais de exposição de propriedade intelectual. Para combater esse risco, algumas empresas estão implementando salvaguardas para proteger as informações dos clientes e manter a confiança, com novas startups encontrando nichos de mercado para proteção contra ameaças externas de IA.
- Qualidade e viés de dados: Conjuntos de dados frequentemente sofrem de vieses sistemáticos que podem se propagar pelos modelos de IA, levando a previsões distorcidas e potencialmente reforçando desigualdades de pesquisa existentes. Vieses históricos em dados de reações publicados, onde reações bem-sucedidas são super-representadas e experimentos fracassados subnotificados, podem prejudicar significativamente a capacidade dos modelos de ML de explorar novos espaços químicos, particularmente para materiais inorgânicos. Esse "viés de publicação" cria um ciclo de autorreforço onde sistemas de IA recomendam preferencialmente compostos semelhantes aos já bem estudados. Modelos de IA generativa apresentam preocupações adicionais, pois podem manipular dados existentes e alucinar para satisfazer solicitações de clientes em detrimento de evidências reais.
- Transparência: A natureza de "caixa-preta" desses modelos pode obscurecer o raciocínio por trás de suas previsões, dificultando a avaliação de sua confiabilidade ou a identificação de possíveis modos de falha. Uma revisão de métodos de IA explicável na descoberta de fármacos destacou como a falta de interpretabilidade em modelos complexos pode minar a confiança entre químicos medicinais e impedir a aceitação regulatória de decisões guiadas por IA no desenvolvimento farmacêutico. Esse desafio é particularmente agudo para redes neurais em grafos e modelos transformer que operam em representações químicas de alta dimensão, onde a relação entre características de entrada e previsões torna-se altamente não linear.
- Equilibrando automação com experiência humana: Embora sistemas de IA possam processar vastos conjuntos de dados e identificar padrões além da capacidade cognitiva humana, eles carecem da intuição, criatividade e compreensão contextual que cientistas experientes trazem para problemas de pesquisa. Isso pode levar a uma geração de cientistas sem habilidades fundamentais de pesquisa e compreensão conceitual. Por outro lado, também pode levar à “aversão algorítmica” quando conclusões impulsionadas por IA contradizem a intuição.
Modelos de IA e o futuro da pesquisa científica
A IA só aumentará em importância para a investigação científica, e suas capacidades revolucionárias já estão sendo realizadas em campos como a biomedicina e a ciência dos materiais. Como mostra nossa análise do CAS Content Collection, novas aplicações, modelos e métodos estão sendo aplicados a questões de pesquisa difíceis o tempo todo. Podemos esperar que avanços na descoberta de fármacos, diagnóstico de doenças, desenvolvimento de materiais e muito mais sejam influenciados ou inteiramente impulsionados por tecnologias baseadas em IA.
À medida que a IA passa de ferramenta a parceira científica colaborativa, também é provável que vejamos novos paradigmas, como design inverso e laboratórios autônomos, redefinindo a metodologia científica em direção a motores de descoberta autônomos. No entanto, baixas taxas de patentes por publicação indicam que muita pesquisa permanece na academia, particularmente em campos tradicionais da ciência dos materiais.
A adoção adicional de IA requer uma calibração de confiança apropriada por meio de soluções técnicas como quantificação de incerteza e transparência de modelos. A natureza abrangente do impacto da IA na ciência e o escopo dos desafios em sua implementação significam que a colaboração e a visibilidade serão fundamentais para maximizar seus benefícios para o avanço científico.
Para mais informações, leia nosso artigo de revista reimpresso, "The AI Revolution in Chemistry: Shaping the Future of Materials and Biomedical Sciences."
O uso de nomes de marcas e/ou qualquer menção a produtos ou serviços de terceiros aqui contidos é estritamente para fins educacionais e não implica endosso pelo CAS ou pela American Chemical Society, nem discriminação contra marcas, produtos ou serviços similares não mencionados


