


人工智能和机器学习模型有助于逆合成规划,但受限于其已有的训练数据。请继续阅读,了解如何通过确保数据具备必要的多元性和高质量,来优化关键的合成规划方案,从而生成新颖的预测结果。
现有药物分子的演进一直是药物研发创新的基石。然而,展望未来,结构新颖的小分子可能比现有药物的改良版更具治疗价值。在2020年获批的小分子药物中,有65%属于结构新颖药物,这些分子被FDA认定为突破性疗法的可能性高出2.5倍,且在上市后5年内成为重磅药物的可能性高出2倍。
然而,合成新颖分子并非易事。逆合成预测工具对于设计新方法和优化生产效率正变得至关重要。这些工具系统地利用全球最新的研究成果,以实现更快的上市速度。通过设定价格或供应商等特定限制条件来构建分子,还能在整个开发流程中实现成本节约。
人工智能在化学合成中的成功应用受限于数据的质量和多样性,缺乏这些要素会阻碍预测的准确性。我们在近期与拜耳(Bayer)的合作中证明了这一点,当时拜耳正寻求优化人工智能在新型小分子逆合成中的应用。通过利用我们高质量、多样化的反应数据来丰富其现有的训练集,我们成功帮助其将罕见反应类别的预测准确率提高了32个百分点。
多样且准确的数据驱动人工智能模型取得成功
在化学合成规划中,目标是生成尽可能多样且准确的合成路线集。然而,人工智能应用的效果取决于底层数据。预测能力取决于训练数据的质量、多样性和准确性。一个关键挑战是数据多样性,因为如果训练数据除了常见的化学反应外,未能涵盖稀疏的化学子空间,那么人工智能应用在范围和新颖性方面将只能提供有限的结果。
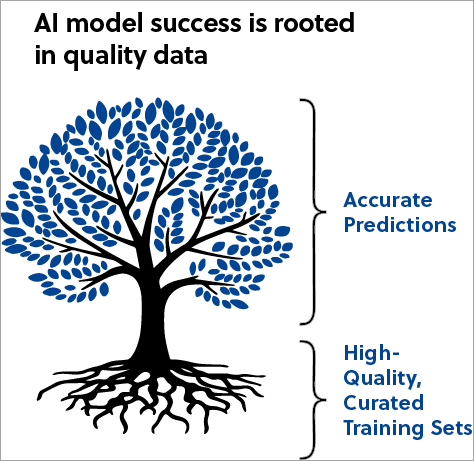
CAS反应数据提供了多样化的反应信息,可显著影响合成规划的预测能力。该数据库在过去十年中规模翻了一番以上,汇集了全球专利、期刊和科学出版物中最稳健、最详尽的化学信息。这种整理工作正在持续进行,并与机器学习同步,以赋能和丰富人工智能合成规划。
拜耳与CAS合作,最大化人工智能在高效药物研发中的应用
在拜耳与CAS的合作中,一个广泛的机器学习训练集通过CAS针对罕见反应类型的数据得到了丰富,从而显著增强了药物研发人工智能模型的预测能力。
该模型包含一个可行性过滤器,由一个神经网络组成,用于评估预测的反应步骤是否可能成功。该网络基于已知反应数据集和一组主要是理论上的失败反应进行了训练。此外,还利用CAS数据构建了一个额外的训练数据集,以量化可行性过滤器的预测能力。加入CAS反应数据后,罕见反应类别的准确率从16%提高到48%,提升了32个百分点。
可行性过滤器准确率的提高在研发流程中具有乘数效应,创造了更高比例的可用反应。这种增强的预测能力开启了以往预测模型无法触及的“罕见”类别,贡献了新颖的结果,为小分子药物研发的未知领域提供了洞察。
这项研究表明,即使是来自CAS Content CollectionTM的一组中等规模的科学家整理的反应数据,也能显著提高合成规划工具的预测能力。这种效果仅在小范围的反应类别中就已显现,这表明通过利用高质量、多样化的数据进一步扩充基础训练集,将能实现更强大的预测能力。这一令人印象深刻的概念验证具有广泛的应用前景,最显著的是能够更高效地发现新型小分子药物靶点。
CAS助力优化您的成果
CAS定制服务SM可以设计训练数据集,为您的机器学习工作提供动力。联系我们的团队讨论您的需求并提高您的预测准确性。